ИИ над данными: сначала доступы, потом ИИ
56 наборов прав сотрудников я свёл к 10, и только после этого пустил ИИ-агента к тринадцати базам.
Раньше, чтобы узнать зарплату коллеги, нужен был доступ в бухгалтерию. Барьер держался сам собой: нет доступа — нет данных. Агент, который читает тринадцать баз, этот барьер схлопывает: хватает вопроса на русском языке.
Это реальный проект группы компаний, которая сама решила не повторять чужих ошибок. Заказчика не называю. Проект реализовал я лично: от ролевой модели до журнала аудита.
Что мы построили
• ролевая модель: 56 наборов прав свели к 10;
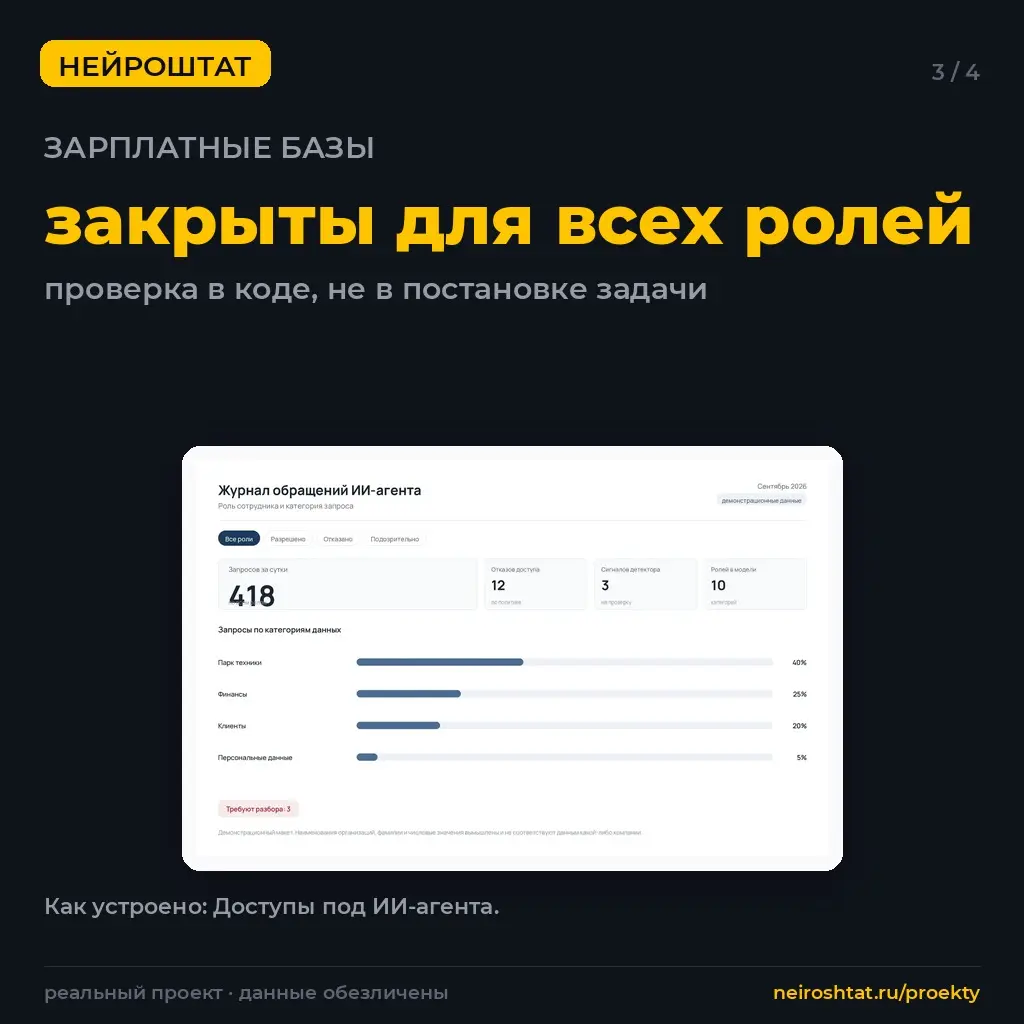
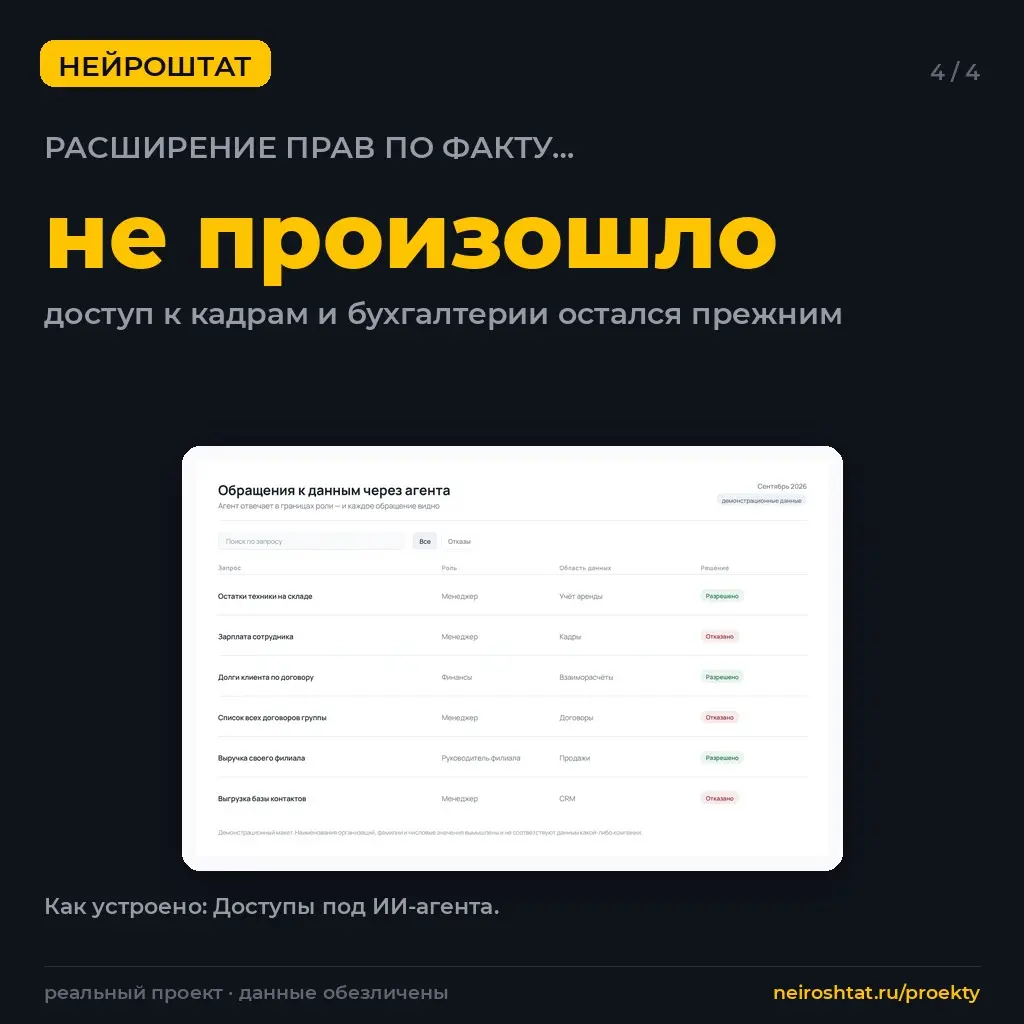
• запреты на уровне кода: зарплатные базы закрыты для всех ролей, включая тех, кому «можно всё»;
• детектор обращений к чувствительным данным;
• контур стоимости и журнал аудита;
• разделение технических учётных записей.
Каждый слой закрывает свой класс риска. Вместе они дают защиту, которая не зависит от аккуратности модели или удачной формулировки запроса.
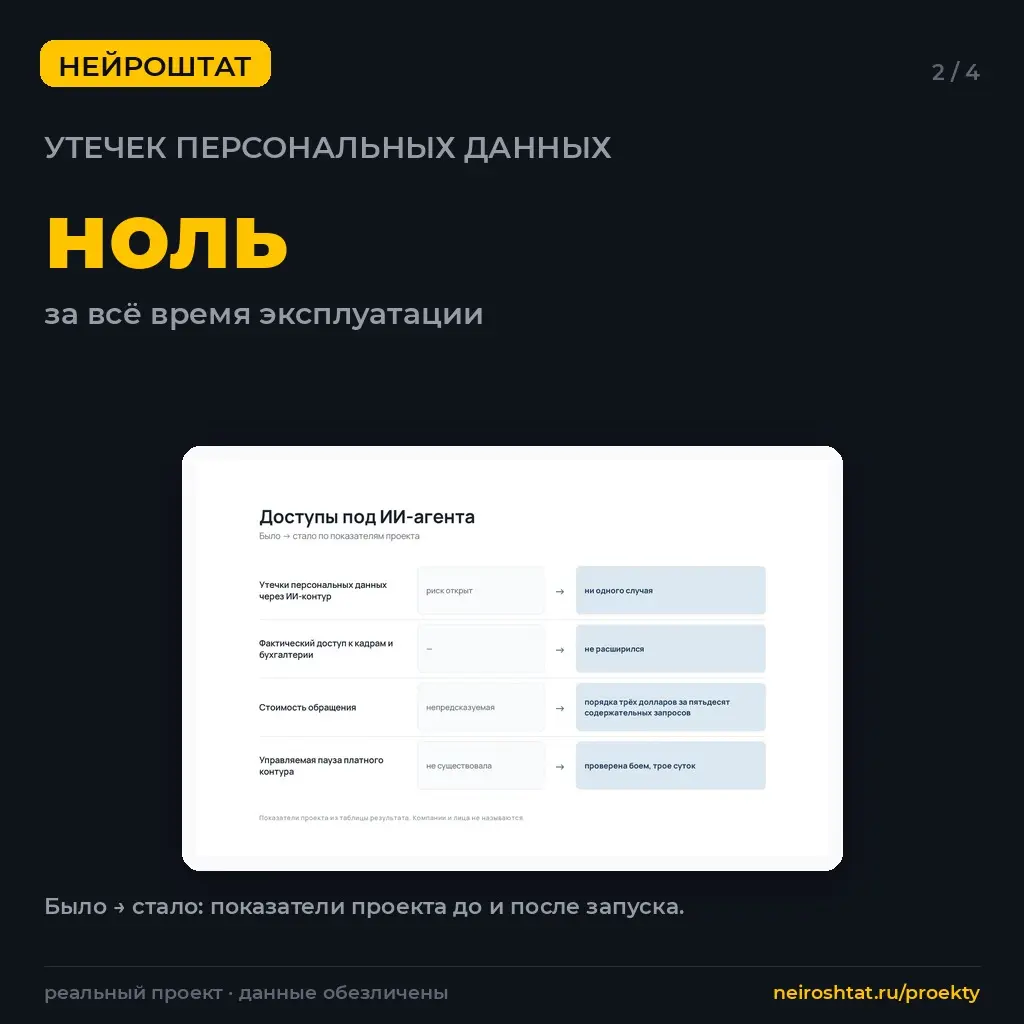
Что изменилось: было → стало
• утечки персональных данных через ИИ-контур: риск был открыт, теперь ни одного случая;
• фактический доступ к кадрам и бухгалтерии: не расширился;
• стоимость обращения: была непредсказуемой, теперь порядка трёх долларов за пятьдесят содержательных запросов.
Честно скажу про незакрытое: часть рисков в этой схеме пока остаётся, и я разбираю их отдельно, а не делаю вид, что защита идеальна.
Вывод: внедрение ИИ над корпоративными данными — сначала проект по управлению доступом, и только потом проект про ИИ. Кто в вашей компании сейчас может прочитать зарплатную ведомость и сколько человек об этом знают?
Полный разбор с деталями кейса →
Кейсы: как бизнес зарабатывает на ИИ-агентах
НейроШтат — внедрение ИИ-агентов