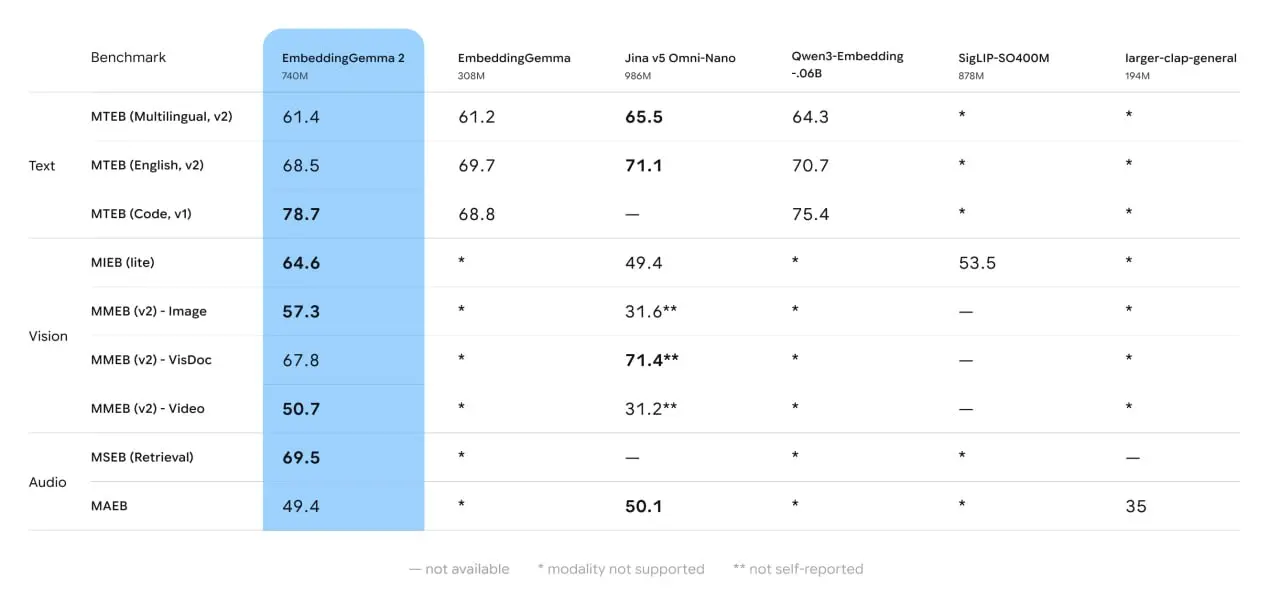
🔍 ПОИСК, КОТОРЫЙ ВИДИТ ВСЁ Google выкатили EmbeddingGemma 2 — локальную мультимодальную модель, которая превращает любые данные в единое числовое пространство 🧠✨. Больше не нужно расшифровывать видео или парсить код отдельно: пишешь запрос словами — находишь нужный кадр, фрагмент программы или аудиомомент мгновенно ⚡️. ▌ Модульность вместо монолита • Полная версия: 740 млн параметров, но можно грузить только нужные части • 💻 Только текст и код: 270 млн параметров (легковесный вариант) • 🖼 Текст + изображения: 440 млн параметров • 🔊 Текст + аудио: 570 млн параметров • 🎥 Полный мультимодальный стек: все 740 млн
На Pixel 11 Pro текстовая версия занимает всего ~191 МБ RAM, а полная мультимодальная — ~567 МБ. Это позволяет обрабатывать чувствительные данные полностью на устройстве, без отправки в облако 🔐📱.
▌ Что нового под капотом? • 📏 Контекст для текста вырос до 8192 токенов — теперь можно индексировать длинные статьи и документацию целиком • 📈 Поиск по коду стал на 14% эффективнее, чем у первого поколения EmbeddingGemma • 🗜 Сжатие векторов: размер можно уменьшить с 768 до 128 измерений, сокращая объем индекса до 6 раз без критической потери качества • 🛠 Открытый исходник под лицензией Apache 2.0 — никаких ограничений на коммерческое использование
▌ Где уже работает? → sentence-transformers ✅ → Hugging Face Transformers ✅ → MLX (для Apple Silicon) ✅ → Ollama ✅ → LM Studio ✅ → vLLM ✅ 💥 ПОЧЕМУ ЭТО КРУТО? ▸ Единое пространство смыслов Текст, картинка, звук и код становятся соседями в одном векторном пространстве. Можно искать изображение котика, набрав «пушистый зверь мяукает», или найти баг в коде, описав ошибку словами 🎯.
▸ Локальность = приватность + скорость Данные не покидают устройство. Для компаний это значит отсутствие рисков утечки IP через сторонние API. Для юзера — молниеносный ответ без сетевых задержек 🚀🔒.
▸ Гибкость ресурсов Не нужно тащить тяжелую модель, если задача простая. Хочешь быстрый поиск по тексту? Грузи легкую версию. Нужен анализ видео? Подключай мультимодальные модули. Экономия VRAM и батареи в реальном времени 🔋⚙️.
▸ Эффективное хранение данных Сжатие векторов до 128 измерений позволяет хранить огромные базы знаний на обычных SSD или даже телефонах. Индекс становится компактным, как архив, но остается умным 🗄.
▸ Open Source без сюрпризов Apache 2.0 — это свобода. Можешь форкать, тюнинговать, интегрировать в свои продукты и не бояться, что завтра Google изменит условия лицензии. Это фундамент для долгосрочных проектов 🤝.
▸ Преемственность экосистемы Интеграция с популярными инструментами (Ollama, LangChain, RAG-системами) означает, что внедрение займет часы, а не недели. Совместимость из коробки экономит время разработчиков ⏳✅. 💼 КАК ИСПОЛЬЗОВАТЬ В БИЗНЕСЕ? ▸ Умные корпоративные поисковые системы Создай единый поиск по внутренней документации, видеоинструкциям, скриншотам интерфейсов и репозиториям кода. Сотрудник пишет вопрос — получает ответ из любого формата контента мгновенно 💼🔍.
▸ Медиамониторинг и контент-менеджмент Для медиа-компаний: автоматическая тегировация тысяч часов видеоконтента. Ищи конкретные моменты, лица или предметы в архиве без ручной разметки. Экономия миллионов на операторах монтажа 🎬💰.
E-commerce визуальный поиск Пользователь загружает фото товара → система находит похожие товары в базе, игнорируя различия в названиях. Или наоборот: поиск по описанию характеристик среди изображений товаров 🛒📸.
▸ DevOps и поддержка кодовой базы Поиск аналогичных ошибок или решений в истории коммитов, логах и документации по естественному языку. Разработчик спрашивает «как мы фиксили таймауты в платежном шлюзе?» → система находит код и обсуждения в Jira/GitHub 💻.
▸ Приватные RAG-системы для медицины и права Обработка медицинских снимков, рентгена и историй болезни локально. Юристы могут искать прецеденты в сканах старых дел, связывая текст договора с изображениями подписей или печатей. Без выхода данных за пределы сервера клиники или фирмы ⚖️. ⏳⏳⏳⏳⏳⏳⏳⏳ ⚡️ Робот Рекрутер 🫢 ИИ-Продавцы + ИИ-Приложения 😞 Квайз - ИИ-игры ▶️ Это наш Ютубчик #поиск