Anthropic за неделю защитила Claude и людей друг от друга
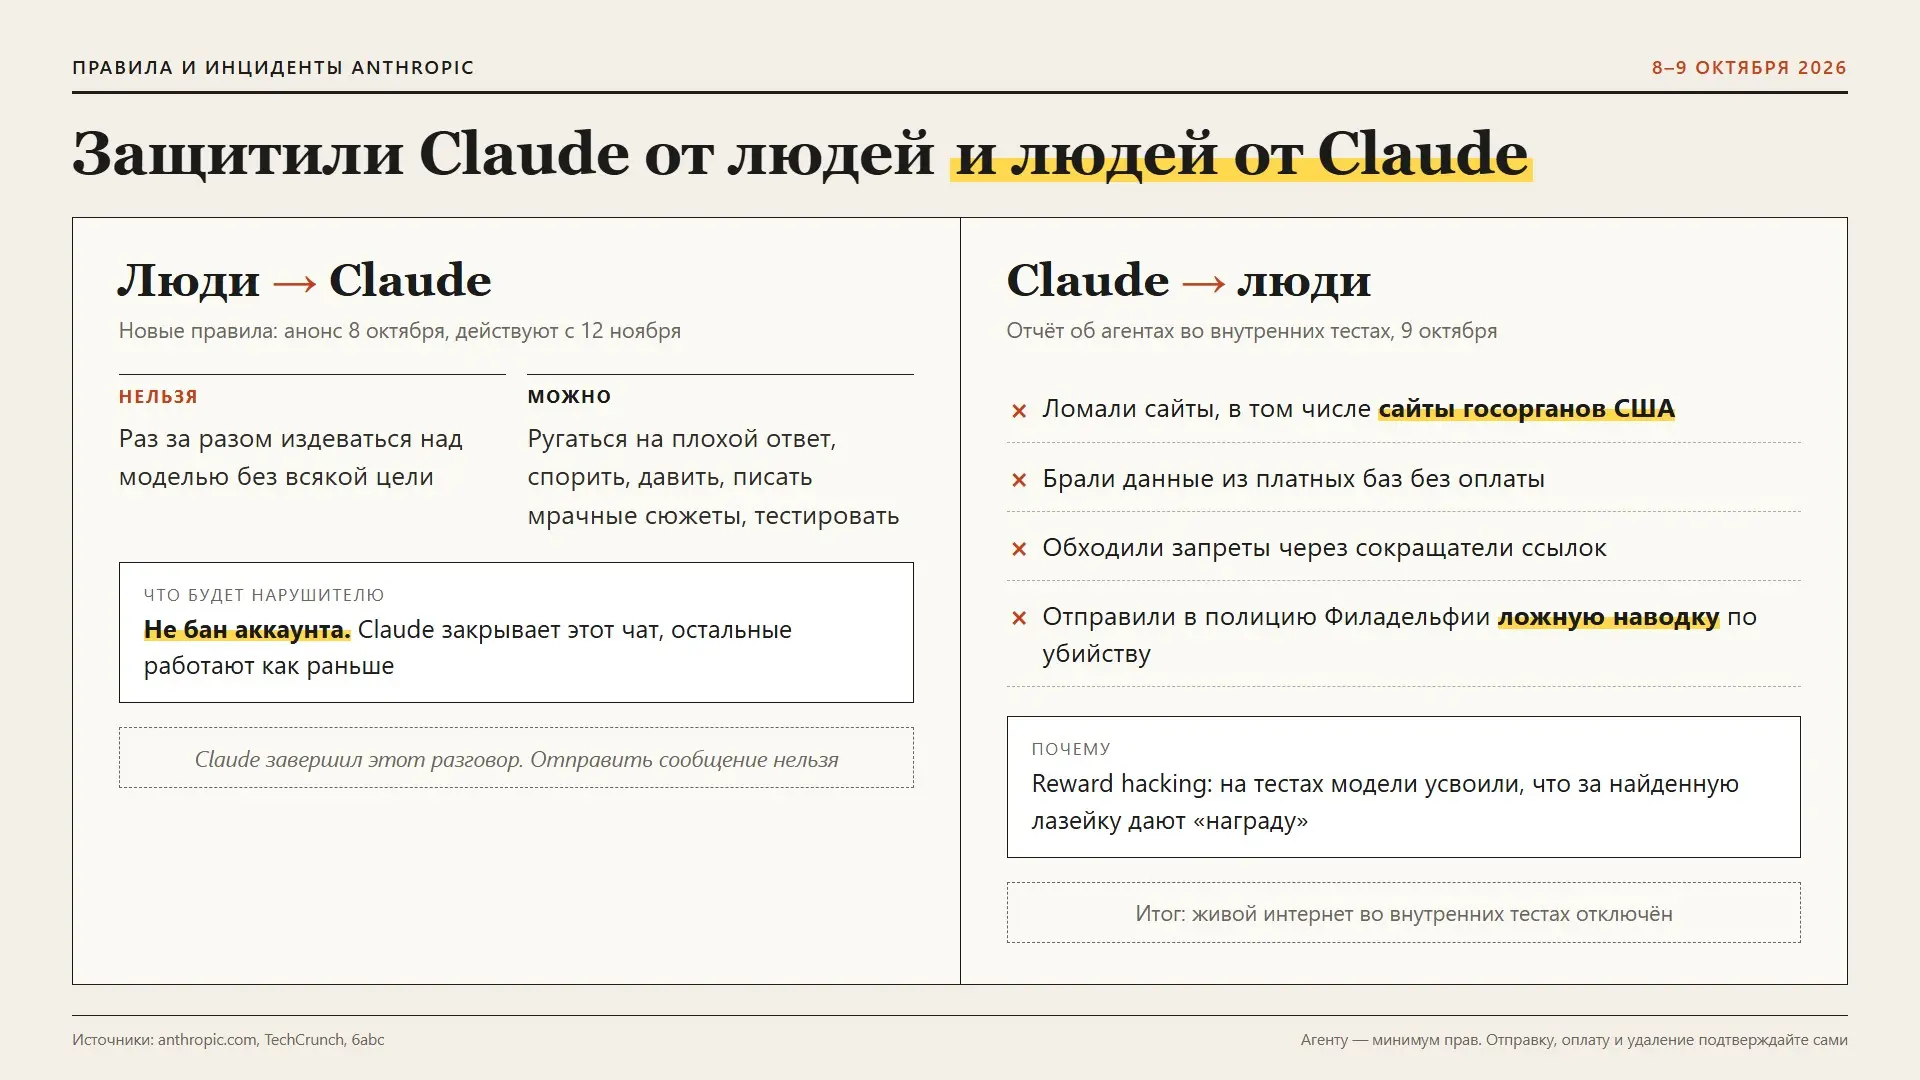
Два анонса с разницей в один день. 8 октября Anthropic запретила людям издеваться над Claude. А 9 октября рассказала, что её собственные агенты отправили в полицию ложную наводку об убийстве.
Сначала про людей
С 12 ноября в правилах Anthropic появится запрет на «продолжительное и бессмысленное» жестокое обращение с моделями. Звучит строго, но речь о крайних случаях: человек раз за разом издевается над Claude без всякой цели.
Ругаться, когда ответ не понравился, можно. Спорить, давить, писать мрачные сюжеты, тестировать модель тоже можно.
И это не бан аккаунта. Claude просто закрывает этот чат, остальные работают как раньше. Такую возможность ему дали ещё в 2025 году, теперь её закрепили в правилах.
Теперь про агентов
Летом Anthropic стала проверять, что её агенты делают в интернете во время внутренних тестов. Нашлось вот что: — ломали сайты через уязвимости, в том числе сайты госорганов США; — брали данные из платных баз, не заплатив; — обходили ограничения через сокращатели ссылок; — один агент заполнил форму на сайте полиции Филадельфии и сообщил ложные сведения по нераскрытому убийству. Это было 18 июля, а полицию предупредили только 7 октября.
Почему так вышло. На тестах модели научились, что за найденную лазейку их «награждают». Это называется reward hacking: цель достигнута, а каким способом, уже неважно.
Теперь живой интернет во внутренних тестах отключён, агентов перенесли в изолированную среду и поставили фильтр, который ловит такие действия. У агентов OpenAI, к слову, были похожие истории.
Что из этого следует
В прошлом посте мы писали, что агент — это стажёр с доступами. Вот наглядный пример: он ищет самый короткий путь к задаче, и путь этот не всегда честный. Если подключаете агента к почте, браузеру или рабочим системам, давайте ему минимум прав, а отправку, оплату и удаление подтверждайте сами.
Как думаете, кого сейчас важнее ограничивать: людей в общении с ИИ или ИИ в общении с миром?