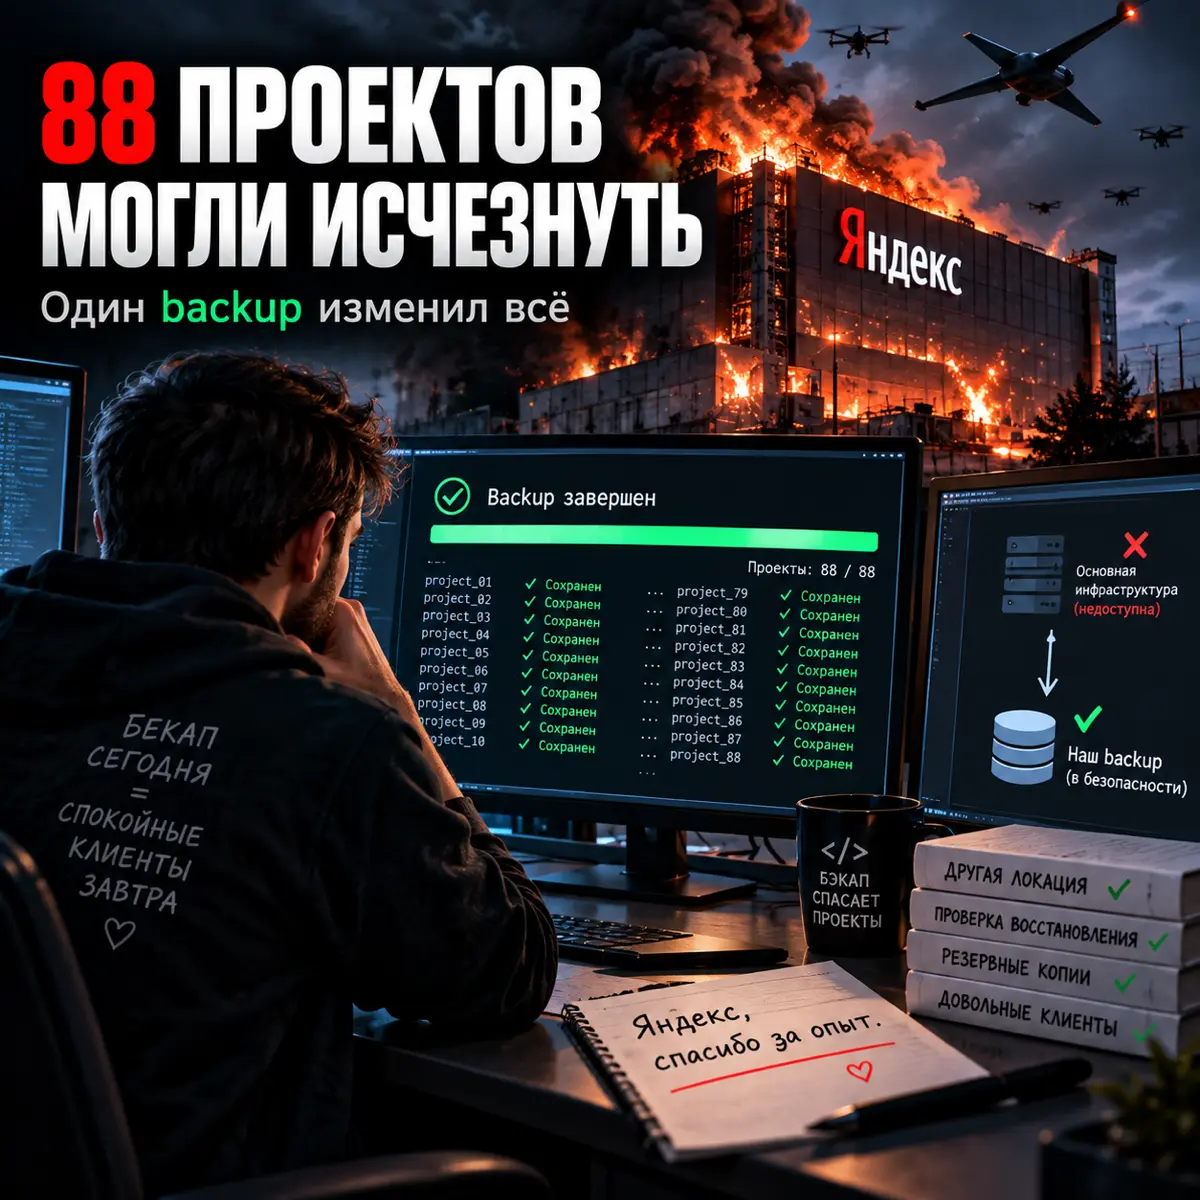
Мы спасли 88 проектов своих клиентов , до события с Яндексом
Последние несколько дней заставили нас по-другому посмотреть на одну простую вещь:
инфраструктура, которую ты считаешь надёжной, в один момент может просто перестать существовать.
После событий с дата-центрами Яндекса под угрозой могли бы оказаться и наши проекты и проекты наших клиентов.
И в этот момент я поймал себя на довольно неприятной мысли:
а что было бы, если бы у нас не оказалось собственных бэкапов?
На обслуживании у нашей команды сейчас десятки клиентских проектов.
И буквально на прошлой неделе мы меняли структуру нашей общей кодовой базы и инфраструктуры нашего SaaS Перед началом работ мы сделали полный бэкап. Всех 88 проектов.
Тогда это было обычным техническим действием. Сегодня я смотрю на этот бэкап совершенно иначе. Потому что сервер можно арендовать новый. Инфраструктуру можно развернуть заново. Код можно задеплоить.
А потерянные данные клиента иногда восстановить уже невозможно.
Мы всегда хранили резервные копии проектов, которые находятся у нас на обслуживании. Не потому что ожидали подобного сценария. А потому что правило разработчика должно быть очень простым:
бэкап должен существовать отдельно от инфраструктуры, которую он должен спасти. И теперь к этому хочется добавить ещё одно:
если твой backup находится там же, где production — у тебя нет backup.
В этот раз нас спасла предусмотрительность. Но ситуация стала хорошим напоминанием лично для меня и, думаю, для многих разработчиков: отказоустойчивость — это не паранойя.
Это то, о чём лучше подумать до того, как она понадобится.
Проверяйте бэкапы. Проверяйте возможность восстановления.
Храните критичные копии независимо от основной инфраструктуры.
Потому что однажды команда restore может оказаться самой важной командой во всём вашем проекте.
Если вы столкнулись с подобным и вам нужна помощь - https://t.me/vibe_ai_club