Почему закрытая страница остаётся в поиске
Добавили запрет в robots.txt, поставили noindex, а адрес страницы всё ещё находится в поиске. Иногда эти две настройки мешают друг другу: поисковый робот не может открыть страницу и прочитать запрет на её индексацию.
Disallow в robots.txt управляет обходом. Директива noindex сообщает, что страницу нужно исключить из поисковой выдачи. Чтобы увидеть её в HTML или HTTP-заголовке, робот должен получить ответ страницы. Google прямо предупреждает об этом. В документации Яндекса тоже сказано: ограниченный в robots.txt адрес может участвовать в поиске.
Представим учебный пример. У компании есть общедоступная страница с программой прошедшего вебинара. Посетителям по прямой ссылке она ещё нужна, но показывать её в поиске больше не хочется. Разработчик добавляет noindex и одновременно закрывает адрес через Disallow. При следующем обходе робот останавливается на запрете и до новой инструкции не добирается.
Для такой страницы я бы действовал по порядку.
1. Проверил содержимое. Если там есть закрытые документы или личные данные, сначала ограничил бы доступ на сервере. Открывать их ради поискового робота нельзя.
2. Для общедоступной страницы настроил бы метатег в разделе head: <meta name="robots" content="noindex">
3. Убрал бы правило Disallow, которое мешает обходу именно этого адреса. Перед изменением общего правила проверил бы, какие ещё страницы оно затрагивает.
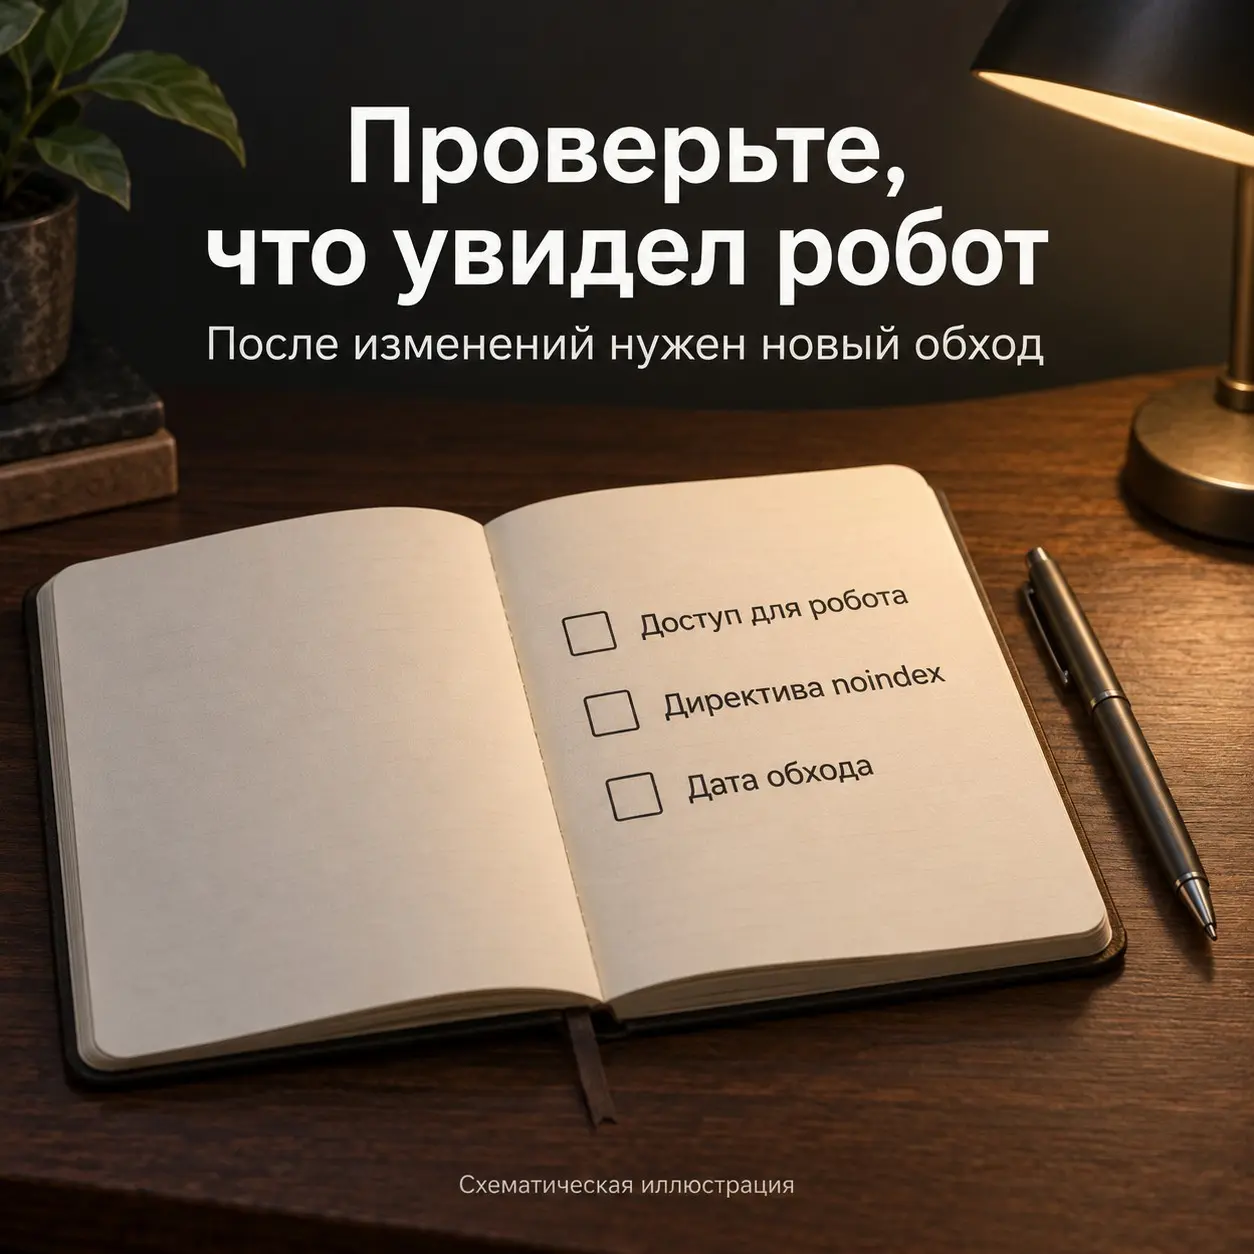
4. Проверил бы фактический ответ сайта: доступна ли страница роботу и присутствует ли noindex в полученном HTML. У сохранённой галочки в CMS и ответа рабочего сайта иногда расходятся планы.
Для PDF можно передать noindex через HTTP-заголовок X-Robots-Tag. Сам PDF должен оставаться доступным роботу, чтобы тот получил этот заголовок. Вписывать Noindex отдельной строкой в robots.txt для Google бесполезно: такой способ не поддерживается.
Если материал конфиденциальный
Доступ к нему нужно ограничить авторизацией с проверкой прав на сервере. Ни robots.txt, ни noindex не защищают содержимое от человека, у которого есть прямая ссылка. Удаление адреса из выдачи также не закрывает сам файл. Если страница окончательно удалена, серверу следует возвращать корректный код 404 или 410.
Как проверить результат
В Google Search Console посмотрите через проверку URL, что получил Googlebot и когда он обходил страницу. В Яндекс Вебмастере проверьте доступность адреса и состояние в поиске. После изменения настроек поисковику нужен новый обход; обещать исчезновение ссылки через час оснований нет.
При срочном удалении у Google есть инструмент временного скрытия URL. Его действие ограничено по времени, поэтому постоянное решение на сайте всё равно потребуется. Запрос на скрытие тоже нужно проверять по статусу.
Я бы сохранял дату изменения и результат следующего обхода. Так проще понять, где задержка: в настройке сайта или в обновлении поисковой базы.
Источники: Google Search Central, справка Search Console и Яндекс Вебмастера. Документация проверена 13 октября 2026 года. Изображения показывают условные схемы.
У вас бывало, что страницу закрыли, а она продолжала появляться в поиске?