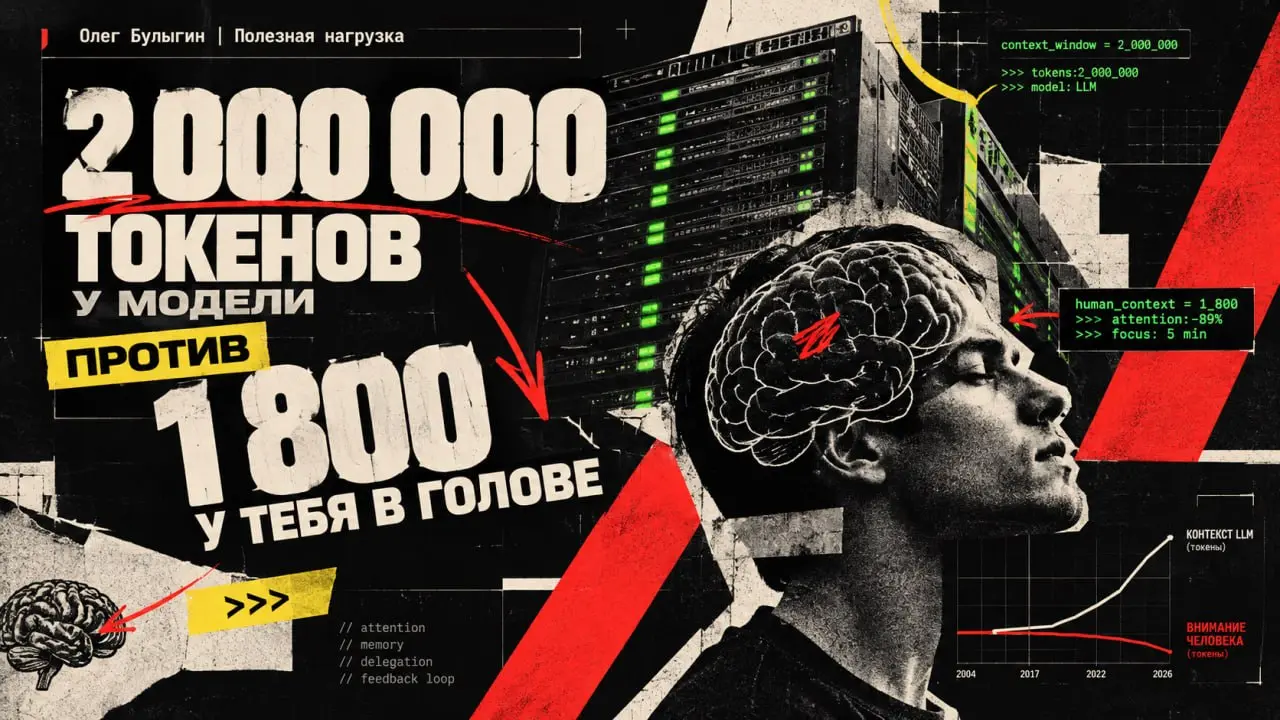
2 000 000 токенов у модели против 1 800 у тебя в голове 🧠📉
Пока контекстные окна нейросетей улетают в космос, человеческая способность удерживать фокус стремительно деградирует. Но главная засада даже не в сухих цифрах разрыва, а в «петле делегирования»: мы начали скармливать сеткам микрозадачи на 30 секунд мышления, запуская самоподдерживающуюся атрофию мозгов.
Недавно вышло интересное исследование: «The Cognitive Divergence: AI Context Windows, Human Attention Decline, and the Delegation Feedback Loop». Автор свел на одном графике эволюцию размера контекста LLM и когнитивные метрики человека за последние 20 лет.
Когнитивная дивергенция в цифрах 🔵 В 2017 году оригинальный трансформер оперировал скромным окном в 512 токенов. К 2026 году контекст раскатали до 2 000 000 токенов (удвоение каждые 14 месяцев — это значительно быстрее закона Мура). 🔵 Человеческий эффективный контекст авторы рассчитали через скорость чтения и среднюю длительность непрерывного удержания внимания на задаче. В 2004 году емкость человека составляла около 16 000 токенов (примерно 25 минут сессионной работы с документом). В 2026 году — это жалкие ~1 800 токенов (около 5 минут кумулятивного чтения до полного расфокуса).
Точка кроссовера произошла в конце 2022 года на релизе ChatGPT. Сейчас «сырой» разрыв между архитектурной памятью машины и рабочей памятью человека составляет почти 1000 раз.
Причем исследование Глории Марк по офисным сотрудникам показывает занятную деталь: среднее время непрерывного удержания взгляда на одном экране сейчас стабилизировалось на отметке в 47 секунд. И 49% переключений внимания — не внешние пуши или звонки коллег, а собственная внутренняя чесотка перескочить на другую вкладку.
Что там с деградацией контекста?
Сравнивать максимальный контекст модели с реальным поведенческим фокусом человека — методологически спорная история, автор статьи это честно признает.
Никуда не делась проблема «lost in the middle». Реальное качество извлечения данных у современных флагманов держится на уровне 100 000–200 000 токенов.
Но даже если сделать поправку на этот «контекстный тухляк», модель удерживает в оперативной памяти в 50–100 раз больше связного контекста, чем средний специалист.
Куда опаснее другой концепт из статьи 👇 Петля делегирования ➿
Классическая сцена из современного офиса: человек открывает чат с моделью и вбивает промпт: «Напиши вежливый отказ от созвона в два предложения».
Это задача, требующая ровно тридцать секунд элементарного когнитивного усилия. Однако порог делегирования пробил дно, и люди отдают на аутсорс даже то, на что не требуется никаких специфических навыков.
Дальше захлопывается капкан:
1️⃣ Модель становится доступнее, быстрее и дешевле -> порог делегирования падает до задач околонулевой сложности. 2️⃣ Задачи уходят на аутсорс -> исчезает так называемая уместная когнитивная нагрузка, необходимая для синтеза понятийных структур в голове. 3️⃣ Биология работает по принципу use it or lose it: дорсолатеральная префронтальная кора без нагрузки снижает активность, рабочая память усыхает, накапливается «когнитивный долг» (что уже подтверждают свежие эксперименты на пишущих студентах). 4️⃣ Собственная емкость мышления падает -> порог делегирования падает еще ниже, и человеку становится лень думать над задачей уже из одного абзаца.
Петля замкнулась. Нейросети не отупляют сами по себе. Калькулятор не уничтожил математику, а компиляторы не убили понимание архитектуры процессоров у тех, кому это действительно нужно. Но если вы используете LLM не для снятия рутины и работы с массивами информации, недоступными человеческому объему внимания, а как протез для ленивого мозга, чтобы не формулировать собственные мысли, — вы добровольно встаете на рельсы деквалификации.
Инструмент должен быть экзоскелетом, усиливающим мышцы, а не инвалидной коляской при здоровых ногах. 🧠
Делитесь самой идиотски-примитивной задачей, которую вы отдавали нейронке из-за собственной лени👇