🤖 Одна модель против команды ИИ: кто лучше пишет код?
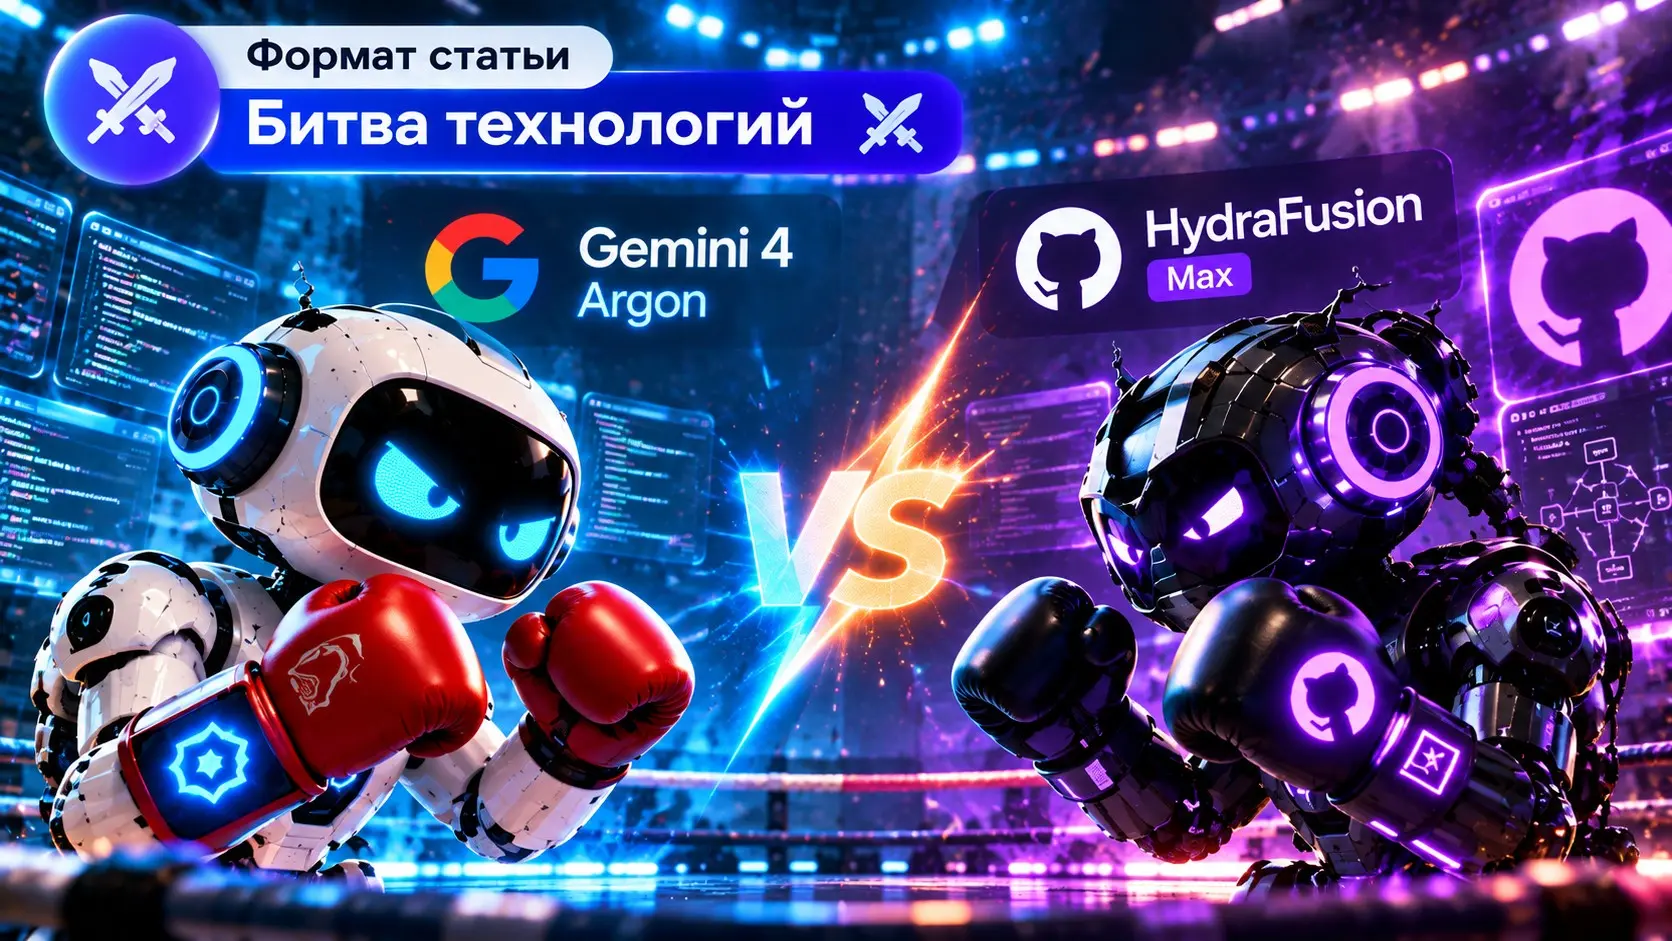
В гонке нейросетей принято спрашивать: «Какая модель сильнее?». Но новости этой недели подсказывают другой вопрос: а что, если хороший результат зависит не только от модели, но и от того, как организована её работа? 13 октября Google открыла доступ к Gemini 4 Argon. На следующий день GitHub обновила HydraFusion и представила режим Max. Это не дуэль двух одинаковых продуктов. Это два подхода к сложным задачам.
🔵 Подход №1. Одна сильная модель
Gemini 4 Argon рассчитана на длительные многошаговые задачи: программирование, анализ документов и работу с инструментами. В опубликованной Google карточке модели есть интересная деталь. На тесте DeepSWE v1.1 Argon получила 77,9%, а Claude Opus 5.5 — 74,2%. Но на FrontierSWE v2 картина обратная: 55% у Argon против 62,3% у Opus. Это результаты из документации Google, а не моего независимого тестирования. Они показывают главное: лидер в одном испытании необязательно выигрывает другое.
🟣 Подход №2. Команда моделей
HydraFusion — не ещё одна базовая нейросеть. Это система, которая распределяет этапы работы между моделями. По описанию GitHub, она может поручить одной модели первый вариант решения, затем проверить его другой и запросить исправление при необходимости. В обновлении появился HydraFusion Max — вариант для более требовательных задач с повышенным вниманием к глубине анализа. Но «несколько моделей» не означает автоматически «лучше». Дополнительные проверки могут стоить времени и ресурсов. И даже согласие нескольких ИИ не гарантирует правильность.
⚔️ Кто побеждает?
На сегодня публичные анонсы не дают оснований объявлять победителя между Gemini 4 Argon и HydraFusion Max. Прямого независимого сравнения в одинаковых условиях здесь нет. И это полезнее громкого рейтинга. Представьте задачу: агент должен исправить ошибку авторизации на сайте. Один подход — дать сильной модели код, тесты и требования. Другой — организовать отдельные этапы: исправление, критический просмотр, повторная проверка. Оба варианта нужно оценивать не по красоте объяснений, а по результату.
🧪 Как проверить на своём проекте
Возьмите одну и ту же задачу и одинаковые исходные файлы. Для каждого подхода зафиксируйте: Прошли ли автоматические тесты. Не появились ли побочные изменения. Сколько понадобилось ручных исправлений. Сколько заняли работа и проверка. Сколько это стоило. Особенно важно проверить не только успешный сценарий, но и ошибочные входные данные, отсутствие прав и повторный запуск.
🎯 Мой вывод
Следующая конкуренция в AI-разработке — не только между моделями, но и между способами организовать их работу. Сильная модель помогает найти решение. Хорошо устроенный процесс помогает понять, можно ли этому решению доверять. 💬 А что выбрали бы вы для сложной задачи: одну мощную модель или команду ИИ с взаимной проверкой? #AIEngineering #AIAgents #Разработка #Автоматизация