🧠 Большие языковые модели — не универсальный молоток. Каждый день мы слышим о выпуске новых языковых моделей. Голова кругом от новинок и сравнительных таблиц. И в этой гонке мы тащим самую мощную модель туда, где нужно не «подумать и написать», а быстро решить: да/нет, оценка, порог, выбор.
В конвейере «поиск + генерация» это особенно дорого. Сортировка найденных фрагментов, проверка на подмену указаний, сверка ответа с источником — на каждый шаг вызов большой модели. Она тратит ресурсы и время ради одного числа или логического значения. При этом очень важно проверять корректность рассуждений и не давать модели уходить в неправильные ветки — но делать это той же большой моделью дорого и медленно.
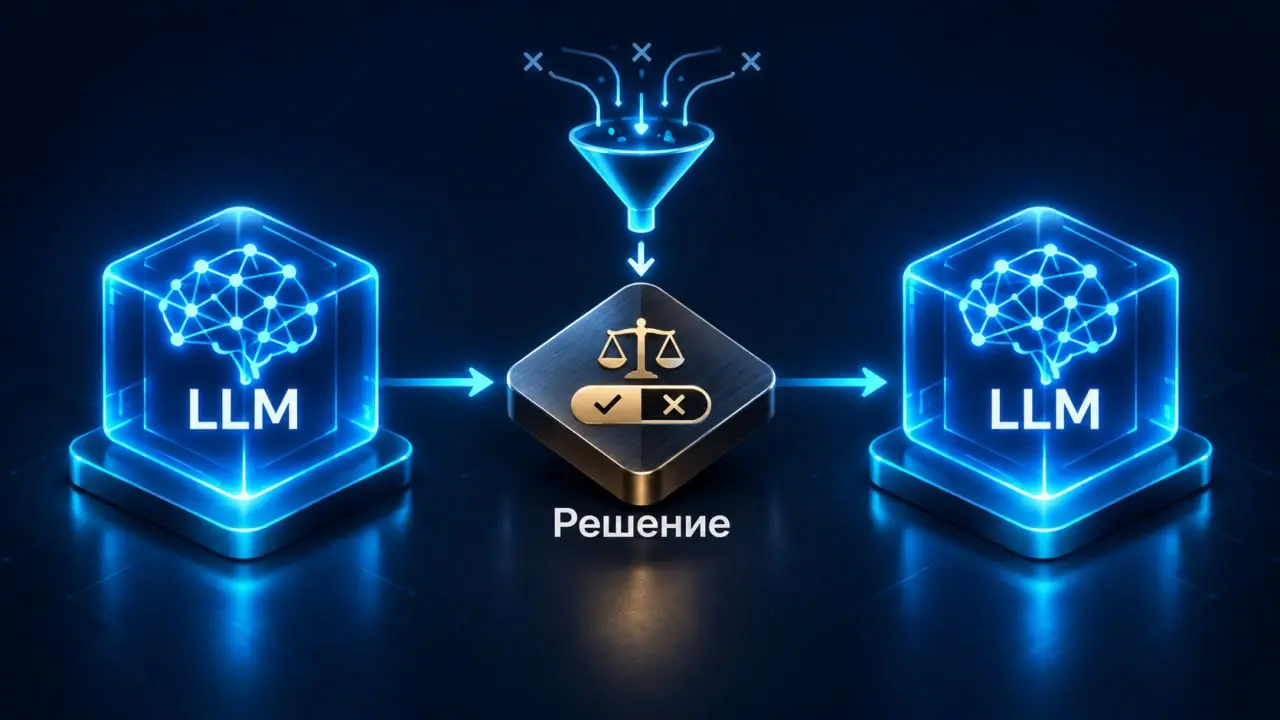
Идея JEV — добавить новый слой принятия решений для отдельных участков конвейера. JEV даёт промежуточные вердикты: оценить соответствие запросу, отсечь вредный текст, подтвердить факт источником. Большая модель подключается только для финального ответа.
По сути, мы возвращаем то, что давно и хорошо работает: принятие решения на основе множества параметров. Именно так устроены банки и страховые — выдать кредит или нет, одобрить страховку или отказать. Простые классические нейросети считают вероятность и выдают чёткий вердикт. Теперь этот «старичок» возвращается в активное использование — для проверки своих старших больших языковых моделей.
Что это даёт: • меньше задержки на тяжёлых запросах; • ниже расходы; • меньше хрупкого разбора вывода модели; • больше строгих типов ответов.
Генеративные модели должны генерировать. Оценивать и выбирать — задача моделей принятия решений.
#ИИ #ЯзыковыеМодели #Архитектура #ПоискИГенерация
В этом посте были ссылки, но мы их удалили по правилам Сетки