


robots.txt, noindex и canonical: в чём разница
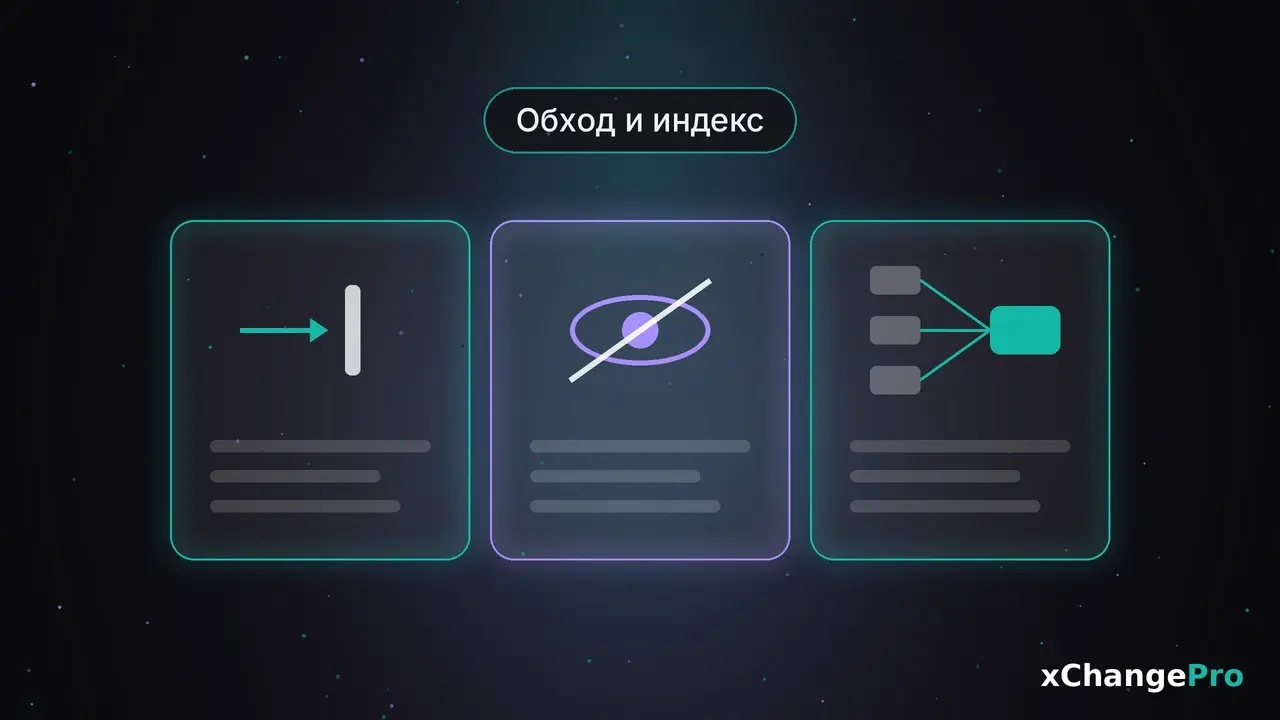
Одна строка в robots.txt может спрятать от поисковика ваш noindex. И страница, которую вы хотели убрать из выдачи, в ней останется. robots.txt, noindex и canonical путают даже опытные команды. Все три влияют на то, как сайт попадает в поиск, но отвечают за разное: за обход, за индексацию и за выбор основной версии страницы. Ошибка стоит дорого: можно случайно убрать из Яндекса и Google рабочие страницы или, наоборот, засорить индекс мусором. robots.txt управляет обходом Он говорит роботу: «сюда не ходи». Но не гарантирует, что URL не появится в выдаче: если на страницу ссылаются, она может попасть в индекс без содержимого. Google прямо пишет, что правило noindex внутри robots.txt не поддерживает. noindex управляет индексацией Ставится в meta robots или в HTTP-заголовке X-Robots-Tag. Заголовок удобен там, где нет HTML, например для PDF-файлов. Чтобы прочитать запрет, робот должен страницу открыть. Отсюда главная ловушка: если закрыть страницу в robots.txt и одновременно поставить noindex, робот noindex не увидит. Это описано в документации Google. canonical выбирает основную версию среди дублей Это подсказка: «из похожих страниц показывай вот эту». Поисковик может с ней не согласиться, если другие сигналы противоречат. robots.txt, noindex или canonical: короткая шпаргалка — Не нужно, чтобы робот ходил в раздел? robots.txt. — Нужно убрать страницу из поиска? noindex, и не закрывать её при этом в robots.txt. — Есть несколько похожих версий одной страницы? canonical на основную. Как я это применяю — Личные кабинеты, внутренний поиск, служебные разделы закрываю от обхода или ставлю noindex. Выбор зависит от того, нужно ли убрать уже проиндексированное. — Страницы, которым не место в выдаче, но которые доступны по ссылке, получают noindex без запрета в robots.txt. — Дубли из-за сортировок и UTM-меток получают canonical на основную версию. Для Яндекса дополнительно есть директива Clean-param в robots.txt: она сообщает роботу, какие GET-параметры не меняют содержимое страницы. Ошибки, которые чаще всего всплывают после релиза — Disallow и noindex на одной странице одновременно: noindex робот не увидит. — noindex, оставшийся с тестового стенда. — canonical у уникальной страницы, который по ошибке указывает на другой адрес. Проверка за полчаса Возьмите 10 ключевых URL сайта и для каждого ответьте на три вопроса: 1. Разрешён ли обход в robots.txt? 2. Нет ли noindex в meta robots или в X-Robots-Tag? 3. На себя ли указывает canonical? Смотреть удобно в проверке URL в Search Console и в Яндекс Вебмастере. Это полчаса работы, и она регулярно находит ошибки после релизов. Мой вывод: robots.txt, noindex и canonical не заменяют друг друга. Обход, индексация и выбор основной версии — три разных вопроса, и на каждый нужен свой инструмент. Какой из трёх инструментов в вашем проекте настроен «как-то исторически»? Напишите в комментариях: robots.txt, noindex или canonical — и что с ним не так. #SEO #техническоеSEO #robotstxt #индексация #вебразработка















· 16.10
Про видимость верно: если проект никто не находит, его как будто нет. У меня он заметен по сути — большая игра по собственной книге, вокруг студия и организация, привлекаю инвестиции.
Пишите, если интересно.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён