


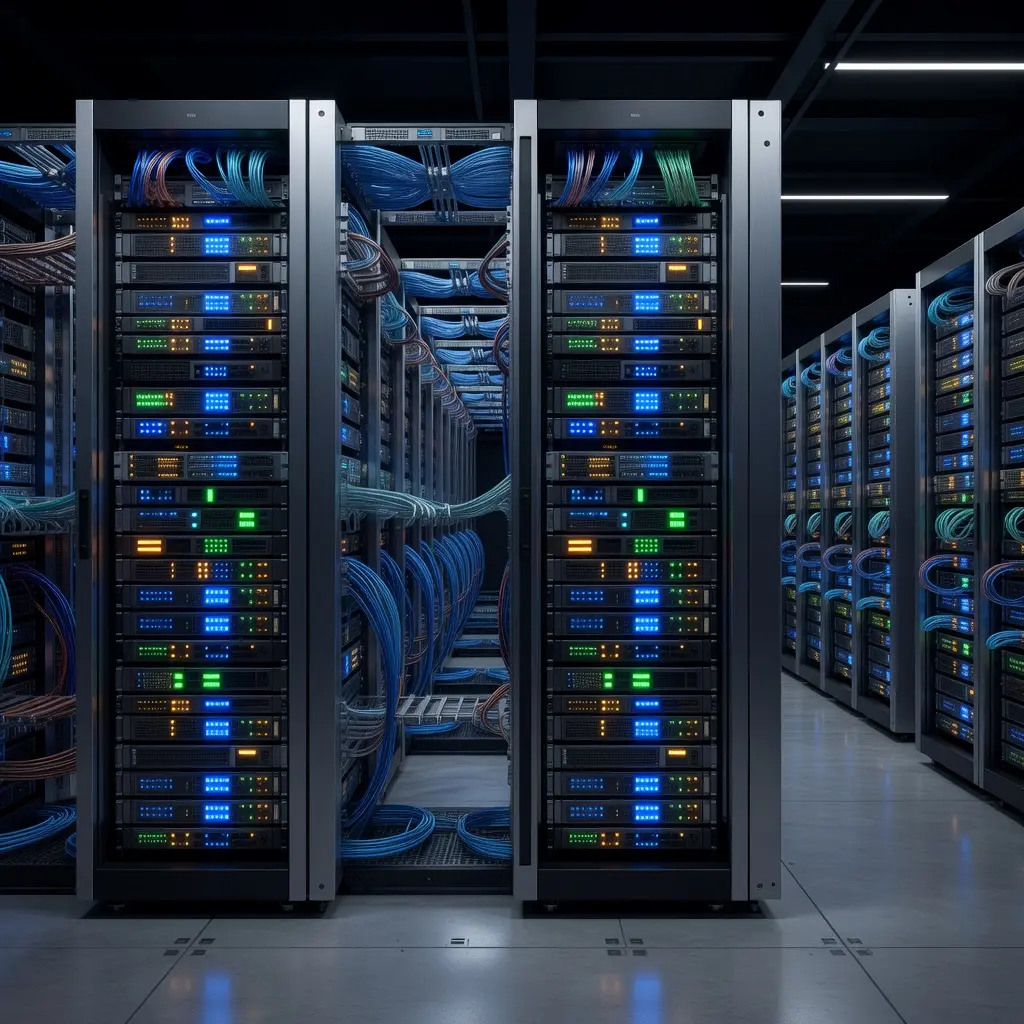
Инфраструктурный кошмар ИИ: уроки жестких кейсов
Большинство менеджеров до сих пор думают, что внедрить ИИ в компанию означает просто подключить API от OpenAI или Яндекса. Нажал кнопку, и всё работает в невесомом цифровом облаке.
Последние события разрушили иллюзию до основания.
Физическое выведение из строя трех крупнейших дата-центров Яндекса и МегаЦОДа Сбера наглядно доказали: любой сверхразумный ИИ намертво привязан к физическому железу, оптике и системам охлаждения в конкретной географической точке.
Когда инфраструктура ложится, падает не просто чат-бот. Рушится связность сквозных бизнес-процессов сотен Enterprise-клиентов: встают заказы в ритейле, сбоит финтех и парализуется логистика. На восстановление и замену дефицитных чипов уйдут месяцы.
Для PM и ИТ-директоров мы получили жесткий урок по Disaster Recovery (аварийному восстановлению).
Три вывода для управления рисками ИИ-проектов:
1. Облако без резерва считается халатностью. Если ваша мультиагентная система завязана на одного облачного провайдера без распределенного резервирования (Multi-Cloud), вы находитесь в зоне максимального риска. У проекта должен быть аварийный план экстренного перенаправления данных на независимые платформы.
2. Пакетный коллапс при миграции. Пытаясь экстренно перевезти поврежденную ИИ-инфраструктуру, компании сталкиваются с сетевым коллапсом. Нагрузка на оставшиеся магистральные каналы связи возрастает кратно, вызывая дикие задержки (Latency) в основных транзакциях.
3. Юридический форс-мажор. Провайдеры уже официально добавляют подобные инциденты в перечень форс-мажоров, снимая с себя ответственность за доступность сервисов. Переводя процессы на ИИ, PM обязан закладывать в архитектуру сценарий полной автономной работы бизнеса вообще без участия внешних нейросетей.
Мой итог: ИИ-трансформация представляет собой на 80% проект по модернизации сетей, железной инфраструктуры и отказоустойчивости, и только на 20% работу с промптами.
Коллеги, ваш план Disaster Recovery готов к сценарию, если завтра у вашего ИИ-провайдера полностью отрубится ЦОД? Как резервируете критические?
#projectmanagement #цод #datacenter #управлениерисками #сетка #ит #технологии #инфраструктура #риски


















· вчера
Резервирование - наше все, особенно в системах класса Business Critical и выше. Как минимум два географически распределенных ЦОДа с возможностью переключения между ними.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён
· вчера
Валерия, полностью согласен. Для систем класса Business Critical геораспределенность считается базовым стандартом выживания.
Внедрение ИИ добавляет в этот процесс новые инфраструктурные вызовы. Обычной репликации баз данных между двумя ЦОД становится недостаточно.
Появляется проблема синхронизации тяжелых контекстов и весов моделей. Переключение трафика инференса на резервную площадку в момент аварии способно вызвать пакетный коллапс на магистральных каналах связи.
Наличие двух географических точек обязано дополняться жесткими сценариями изоляции локальных вычислительных контуров. Без автономной работы каждого узла отказоустойчивость превращается в декларацию на бумаге.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён