Эмбеддинги: близкий по смыслу текст ещё не ответ
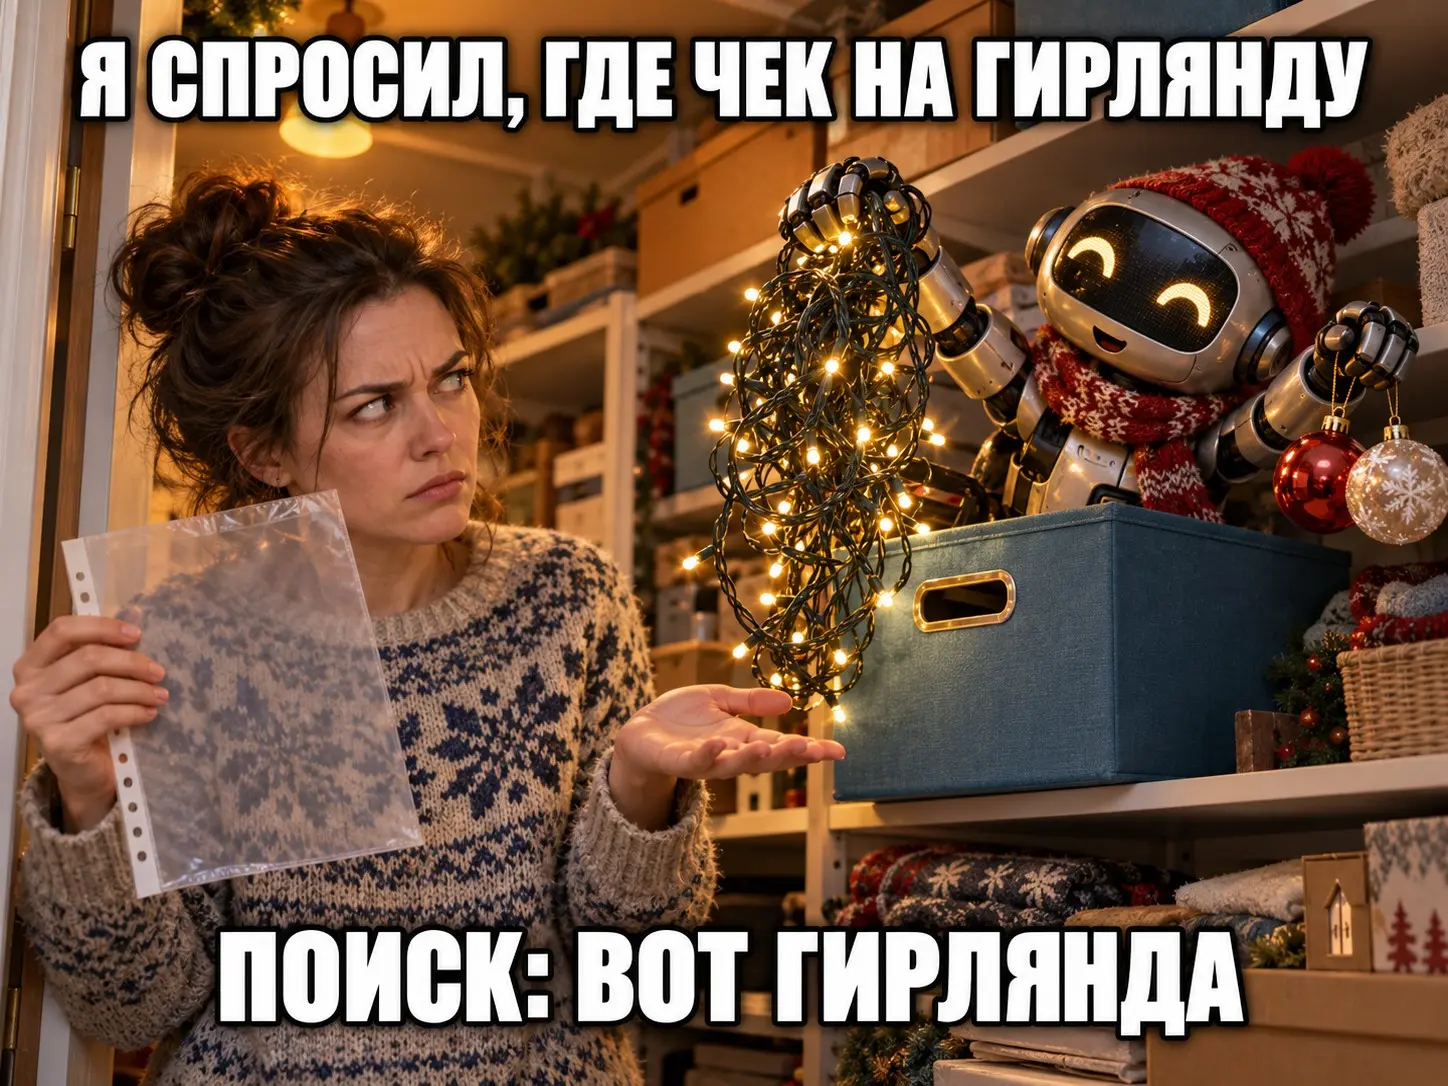
Если поиск по базе знаний выдал близкий документ, легко принять его за готовый ответ. В новой статье показываю, почему это разные вещи, на учебном примере с четырьмя заметками. Вопрос: «Куда убрали ёлочные украшения?». Нужная заметка — про гирлянду и стеклянные шары в синем ящике на верхней полке кладовки. Слово «украшения» встречается в другой записи, про день рождения. Чтобы сопоставить такие формулировки не только по буквальному совпадению слов, модель переводит вопрос и записи в числовые представления — эмбеддинги. Программа сравнивает эти списки чисел, выстраивает кандидатов по оценке близости и по идентификатору достаёт из базы готовый исходный текст. В демонстрационном прогоне модели для статьи на вопрос про ёлочные украшения система поставила запись про гирлянду на первое место, но на вопрос «Где чек на покупку гирлянды?» первой оказалась она же — хотя про чек в базе вообще ничего не написано. Близость не означает правильность ответа. Даже подходящая по теме заметка может не содержать нужного факта или оказаться устаревшей. Поиск только отбирает сохранённый текст. Генерация нового ответа в RAG подключается отдельно и не превращает отсутствующий факт в известный. Разбор эмбеддингов в блоге