


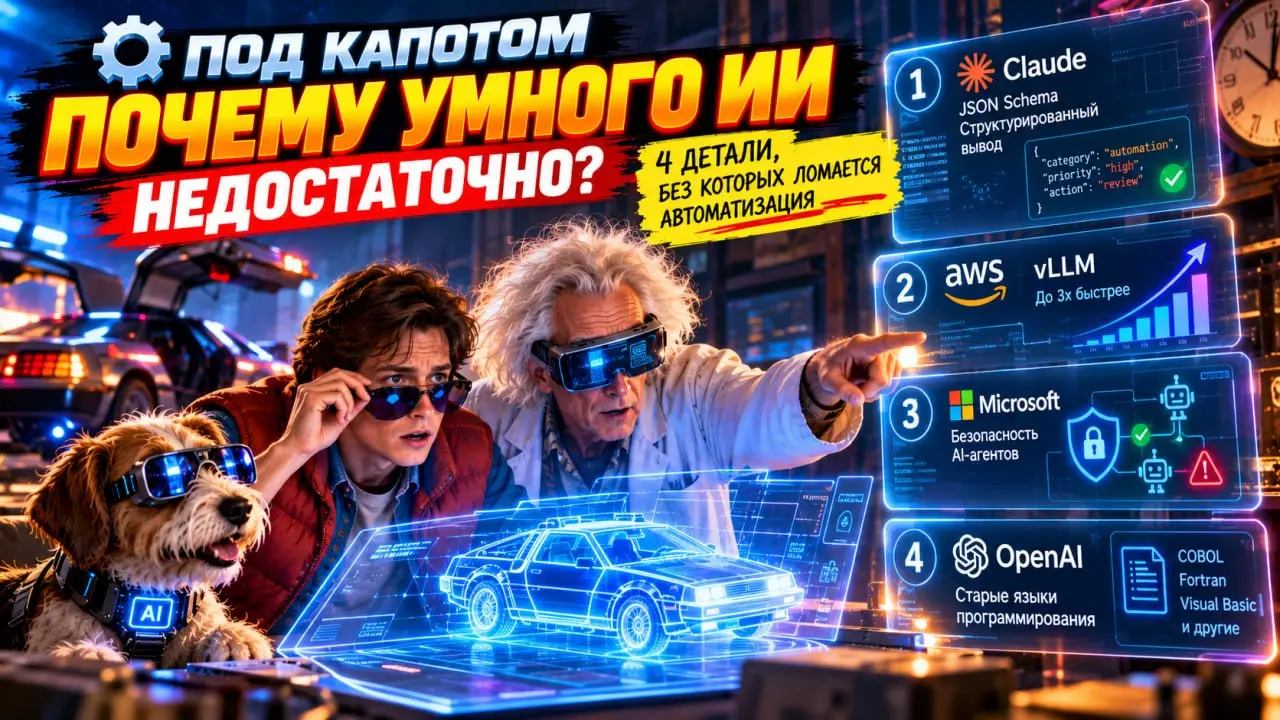
🔧 ПОД КАПОТОМ | Почему умного ИИ недостаточно: 4 детали, без которых ломается автоматизация Представьте: нейросеть правильно поняла задачу, но вернула ответ не в том формате. Или AI-агент выполнил поручение, получив доступ к данным, которые ему вообще не требовались. Снаружи всё выглядит как «ошибка ИИ». Но часто проблема глубже — в устройстве системы вокруг модели. 19 октября появились сразу несколько технических публикаций, которые показывают, над чем сейчас работают разработчики. Я выделил четыре важных направления. 🧩 1. Правильный формат — ещё не правильное решение AWS сообщила, что модели Claude в Amazon Bedrock теперь поддерживают структурированный вывод по JSON Schema. Раньше разработчик мог попросить модель вернуть JSON, а затем отдельно проверять, не пропущено ли поле и не перепутан ли тип данных. Теперь формат ограничивается прямо во время генерации. Например, автоматизация обработки заявок может требовать строго определённые поля: категория, приоритет и необходимость вмешательства человека. Но есть принципиальная граница: корректная структура не гарантирует верную классификацию. Кроме того, отдельные ограничения схемы не применяются при генерации, а обрывы ответа и отказы всё ещё требуют обработки. Мой вывод: схема защищает интеграцию от части технических ошибок, но не заменяет проверку смысла. ⚡️ 2. Скорость ИИ зависит не только от модели В техническом материале AWS описан новый механизм передачи KV-кеша в vLLM — движке для запуска языковых моделей. Если упростить, KV-кеш позволяет не пересчитывать некоторые уже обработанные данные. При распределённой работе его нужно передавать между узлами. Изменение порядка передачи сократило задержки: в конкретных тестах время до первого токена улучшилось до трёх раз, а время генерации одного токена — до 30%. Это результаты определённой конфигурации, не обещание ускорения любого чат-бота. Но идея важная: иногда производительность растёт не после покупки более мощной модели, а после грамотной инженерной настройки. 🔐 3. AI-агент — не сотрудник с безграничным доступом Microsoft опубликовала материал о безопасности внутренних AI-агентов. Главная проблема: агенту дают инструменты, права и доступ к данным, а затем начинают доверять ему как обычной программе. Но поведение модели может меняться в зависимости от контекста. Компания описывает подход с контролем идентичности, разрешений и действий агента, включая проект Project Perception. Я бы сформулировал правило так: выдавайте агенту только необходимые права, фиксируйте действия и требуйте подтверждения опасных операций. 🛠 4. ИИ учится работать со старым кодом OpenAI представила результаты тестирования моделей на COBOL, Fortran и других языках, для которых доступно меньше обучающих материалов. На тесте MultiLangBench модель GPT-6 Astra прошла в среднем 87,4% проверок по 20 языкам. Это опубликованный результат тестирования, а не гарантия успешной модернизации любого проекта. Особенно важно сохранять поведение старых систем: небольшая разница в округлении финансовых расчётов способна превратиться в серьёзную ошибку. 🎯 Что объединяет эти новости? Для меня зрелая AI-система — это не просто сильная модель. Это правильный формат данных, измеримая скорость, минимальные права доступа и тесты, которые доказывают, что результат действительно верный. Чем самостоятельнее становится ИИ, тем больше значения приобретает инженерная дисциплина вокруг него. 💬 А что в AI-автоматизации вы считаете самым сложным: надёжность ответов, безопасность или интеграцию с существующими системами? #ПодКапотом #ИскусственныйИнтеллект #AIAgents #Автоматизация

















· 20.10
К этому списку добавил бы поведение при повторном запуске: если агент не получил подтверждение операции, он не должен выполнять её заново вслепую. Для заявок и платежей важно отдельно хранить идентификатор действия и уметь сверять фактический результат после сбоя.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён