Проверка дороже выдачи
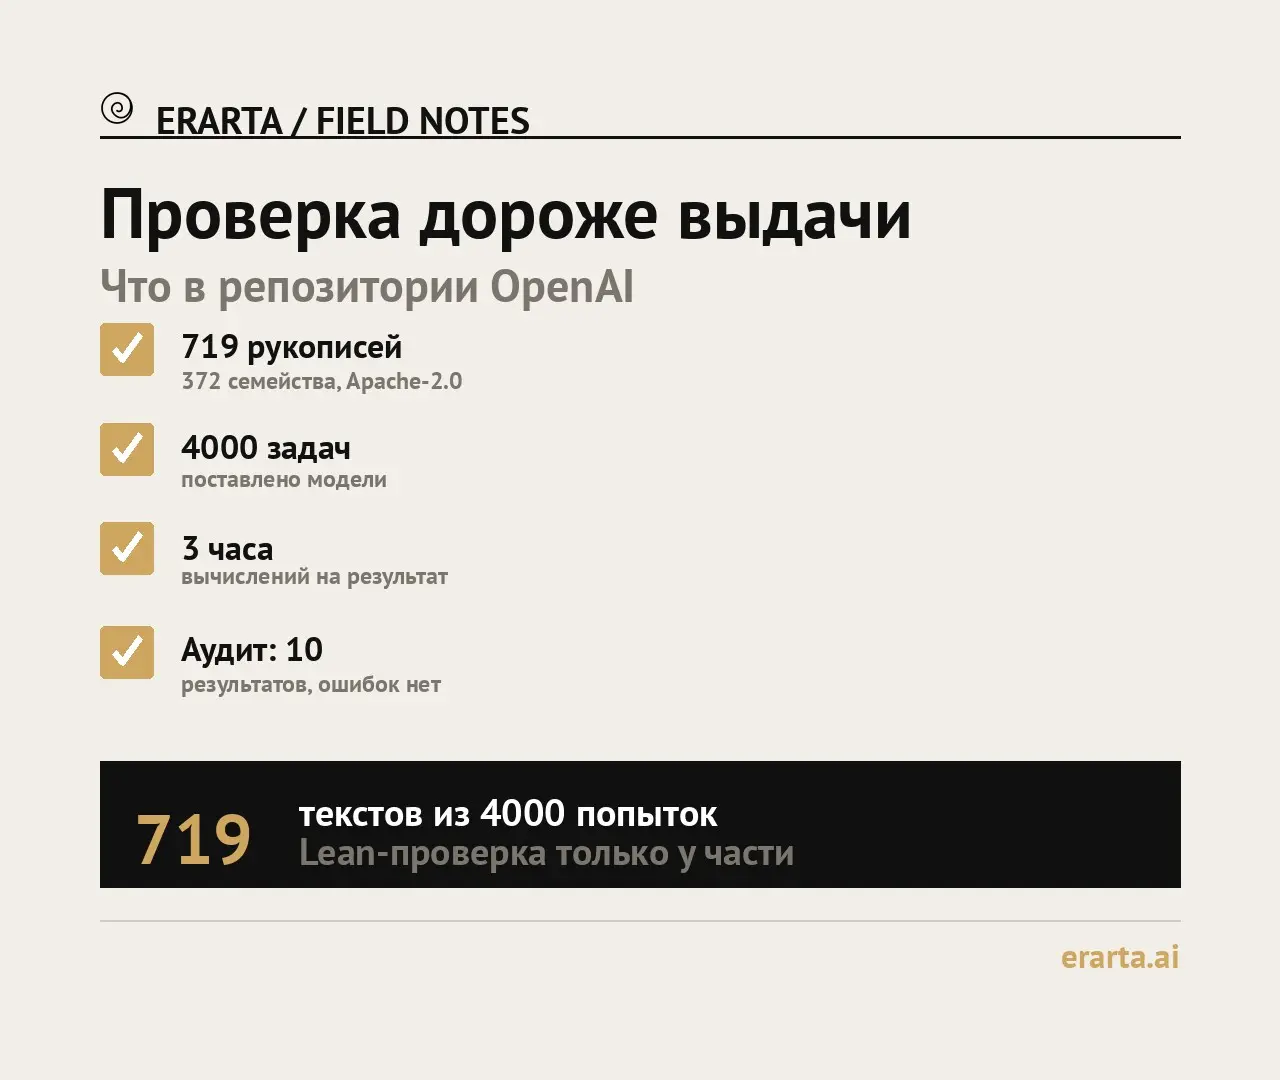
6 октября 2026 года OpenAI открыла репозиторий с результатами неназванной внутренней модели: 719 рукописей в 372 семействах результатов, модели поставили около 4000 задач, на один результат уходило в среднем три часа вычислений уровня ChatGPT Pro. Часть результатов формализована в Lean и проверена машиной, часть пока только в тексте, и авторы прямо пишут, что в неформализованных работах возможны ошибки.
Привычная реакция: ИИ решает открытые задачи, людям-математикам пора расходиться. Цифры говорят о другом: из 4000 попыток в каталог попали 719 текстов, и доверие к каждому держится на проверке, которую машина делает только для части из них.
Что показала независимая проверка предыдущей партии. Аудит десяти результатов, анонсированных OpenAI 1 августа 2026 года, не нашёл подтверждённой содержательной ошибки в главных утверждениях, при этом глубина проверки по главам различалась, одна глава потребовала серьёзной переработки сжатых выкладок, а ещё в одной «ошибка» оказалась потерянной чертой над символом при вёрстке.
Как это переносится на любую компанию, где ИИ пишет код или анализ: 1. Производство результата подешевело до часов вычислений. Проверка результата осталась на людях и формальных инструментах. Узкое место переехало из «придумать» в «убедиться».
Что проверить в своём процессе: - какая доля результатов ИИ у вас проходит проверку, сопоставимую с Lean: тесты, типы, воспроизведение; - кто отвечает за результат, у которого проверки нет, и знает ли он об этом; - сколько стоит час проверки против часа генерации и в какую сторону меняется это соотношение.
Модель выдала 4000 попыток, в каталог вошли 719, проверены машиной меньше. Тот же конвейер теперь стоит в каждой команде, которая принимает код от агентов.