Prompt Caching: токены LLM в 10 раз дешевле — но за счёт чего? На момент, когда я пишу эту статью, закэшированные входные токены стоят в долларах за токен примерно в 10 раз дешевле обычных входных токенов — как в API OpenAI, так и Anthropic.
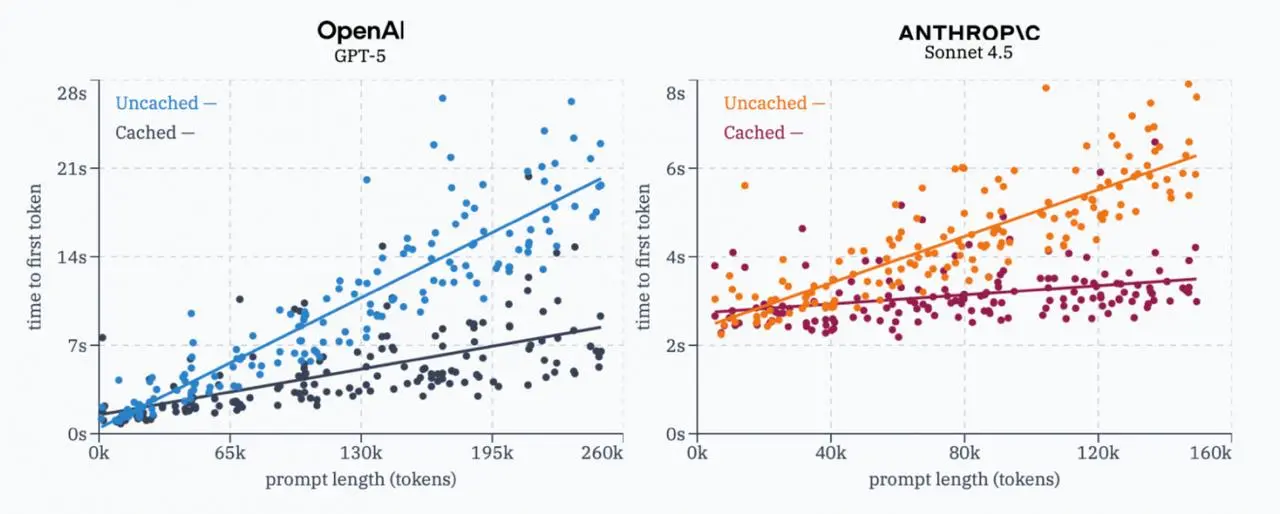
Anthropic даже заявляет, что кэширование промптов может снизить задержку «до 85% для длинных промптов», и в моих собственных тестах я убедился, что при достаточно длинном промпте это действительно так. Я отправил сотни запросов и в Anthropic, и в OpenAI и заметил существенное сокращение задержки до первого токена для промптов, в которых все входные токены брались из кэша.
👉️️️️️️ https://habr.com/ru/articles/978498/
👮♂️ Злой полицейский
В этом посте были ссылки, но мы их удалили по правилам Сетки