Prompt Caching AI-агентов
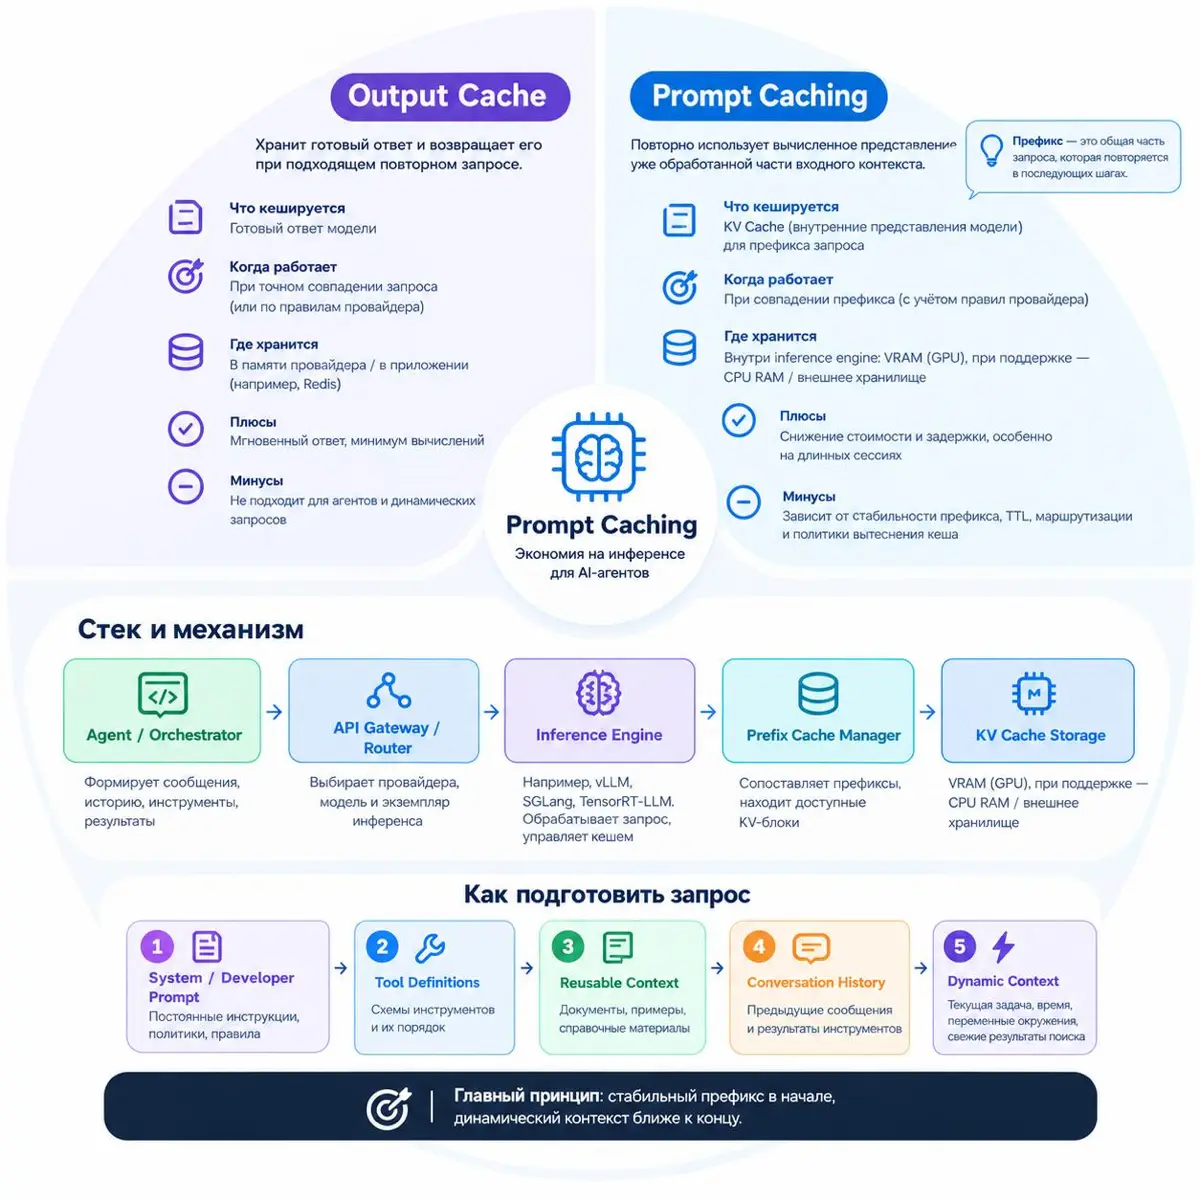
Архитектор должен обеспечить три условия: Стабильный префикс → повторное использование KV Cache → измеримый экономический эффект.
Prompt Caching позволяет повторно использовать вычисления для уже обработанной части запроса. Разберём, где хранится кеш, как устроен стек и почему в production он иногда не работает так, как ожидает разработчик.
Кешируется вход, а не ответ При инференсе Transformer выполняет этапы prefill и decode. На этапе prefill модель обрабатывает входную последовательность токенов и рассчитывает промежуточные представления Attention — ключи и значения, известные как KV Cache. Если следующий запрос содержит уже обработанный префикс и соответствующие данные сохранились, inference engine может повторно использовать KV Cache вместо пересчёта этого префикса.
Это принципиально отличается от Output Cache: Output Cache — хранит готовый ответ для повторного использования. Prompt Caching — повторно использует вычисления для общей части входного контекста.
Запрос по-прежнему передаётся системе инференса, новые токены обрабатываются, а ответ генерируется заново. Без кеширования каждый запрос может требовать обработки всей переданной истории. При линейном росте контекста суммарный объём входных токенов за сессию растёт примерно квадратично по числу шагов. С Prompt Caching повторно используемый префикс может обходиться значительно дешевле обычного ввода. В зависимости от модели и тарифа экономия на кешированных токенах может быть очень существенной.
Где хранится кеш
В self-hosted окружении механизм реализуется внутри inference engine. Типичный стек: 1. Agent Harness / Orchestrator Формирует сообщения, управляет историей, инструментами и результатами вызовов. 2. API Gateway / Inference Router Выбирает провайдера, модель и экземпляр инференса. В распределённой системе может учитывать расположение кеша. 3. Inference Engine Например, vLLM, SGLang или TensorRT-LLM. Обрабатывает запрос и управляет повторным использованием префиксов. 4. Prefix Cache Manager Сопоставляет входные префиксы или блоки по токенам и их хешам, находит доступные KV-блоки. 5. KV Cache Storage В обычной конфигурации self-hosted инференса KV-тензоры размещаются в VRAM видеокарты. Поддерживаемые движки могут также использовать CPU RAM или дополнительные уровни хранения. При нехватке памяти кешированные блоки могут вытесняться. Поэтому наличие кеша не гарантирует попадание в него при каждом запросе.
Как подготовить запрос к кешированию Главный принцип — стабильный префикс в начале и динамический контекст ближе к концу.
Рекомендуемая последовательность: - System / Developer Prompt — постоянные инструкции и политики. - Tool Definitions — стабильные схемы инструментов и их порядок. - Reusable Context — неизменяемые документы и справочные данные. - Conversation History — предыдущие сообщения и результаты инструментов. - Dynamic Context — текущая задача, время, переменные окружения и свежие результаты поиска.
Первые четыре блока должны сохранять максимально длинный общий префикс между последовательными запросами.
Ошибки, которые снижают cache hit rate - Динамика в начале промпта. Timestamp, случайный идентификатор или изменившиеся инструкции могут нарушить совпадение всего последующего префикса. - Переписывание истории. Изменение старых сообщений, результатов инструментов или схем функций уменьшает объём повторно используемого контекста. - Игнорирование TTL и маршрутизации. Кеш может истечь или оказаться недоступным на выбранном экземпляре инференса. Время хранения и поведение маршрутизации зависят от платформы. - Compaction также требует внимания: если агент переписывает большую часть истории, новый контекст уже не совпадает с прежним префиксом в изменённой области.
Пример: В vLLM: Включается флагом --enable-prefix-caching
Phy: messages = [ # — ЭТО ПРЕФИКС SYSTEM_PROMPT— {“role”: “system”, “content”: SYSTEM_PROMPT}, # >1024 токенов {“role”: “user”, “content”: “Какое главное правило безопасности?”}, ]