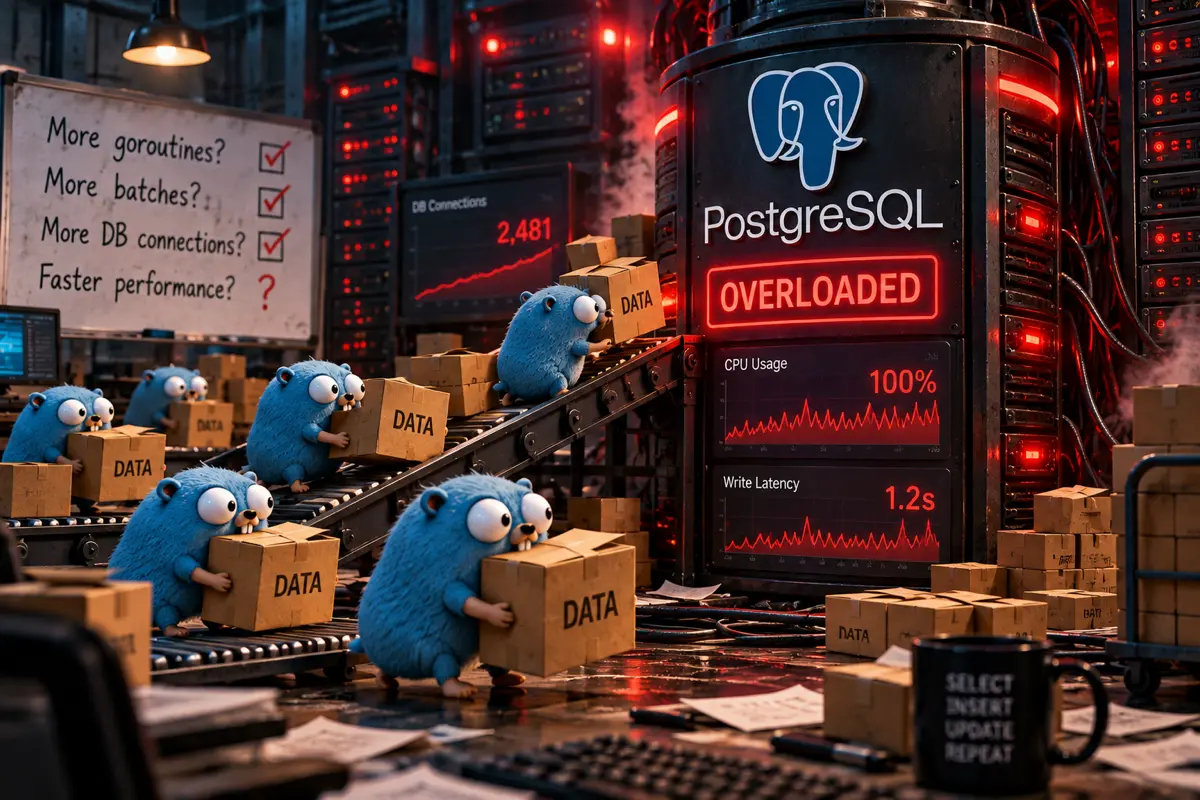
Больше горутин, больше батчей, больше подключений к базе.
Postgre SQL работать все медленнее, под растущей нагрузкой. С такой проблемой я столкнулся при разработке высоконагруженного сервиса синхронизации данных на Go. Сервис обрабатывал миллионы исторических записей от нескольких внешних провайдеров, постоянно добавляя новые данные и обновляя существующие. Изначально казалось логичным обрабатывать как можно больше данных параллельно. Но с ростом конкурентности нагрузка на PostgreSQL становилась слишком высокой. Больше горутин не означало лучшую производительность. В какой-то момент они просто начинали конкурировать за одни и те же ресурсы базы данных. Вот что помогло нам решить эту проблему.
1. Batch processing Вместо того чтобы вставлять записи по одной, мы начали объединять их в батчи. Подбор оптимального размера батча потребовал экспериментов. Маленькие батчи создавали слишком много накладных расходов, а большие увеличивали продолжительность транзакций и нагрузку на базу данных.
2. Worker Pool и управление конкурентностью Я реализовал планировщик синхронизации с ограниченным пулом воркеров на Go. Планировщик распределял задачи синхронизации между фиксированным количеством воркеров, что позволяло контролировать число одновременно выполняемых операций. Благодаря этому нагрузка стала более предсказуемой, а риск перегрузки PostgreSQL снизился.
3. Распределённая координация через Consul Поскольку сервис работал в нескольких инстансах, нужно было исключить ситуацию, когда разные инстансы одновременно синхронизируют одни и те же данные. Для координации задач между инстансами мы использовали распределённые блокировки через Consul.
4. Обработка дубликатов и обновлений Ещё одной проблемой была консистентность данных. Разные провайдеры иногда возвращали дубликаты, пропущенные значения или исправления исторических данных. Мы нормализовали входящие данные и использовали идемпотентные операции с базой, чтобы безопасно добавлять и обновлять записи, не создавая дубликатов. Что я вынес из этого опыта Когда база данных перегружена, одной оптимизации SQL-запросов не всегда достаточно. Иногда настоящая проблема заключается в том, как само приложение управляет нагрузкой. Важно учитывать размер батчей, ограничения конкурентности, количество подключений к базе и координацию между инстансами сервиса. Увеличить параллелизм легко. Гораздо сложнее найти его оптимальный уровень. И зачастую именно это сильнее всего влияет на производительность системы. #Golang #PostgreSQL #BackendEngineering #DistributedSystems