Как работает CAG на примере общего справочника
Допустим, в компании есть общий справочник правил, который редко меняется. Сотрудники обращаются к нему через ИИ-помощника: один хочет узнать, как подать заявку на отпуск, а другой — как подать расходы после командировки.
В векторном RAG документ заранее делят на фрагменты и вычисляют эмбеддинги — числовые представления смысла. Для вопроса тоже считают эмбеддинг, через индекс находят нужные фрагменты и передают их текст модели.
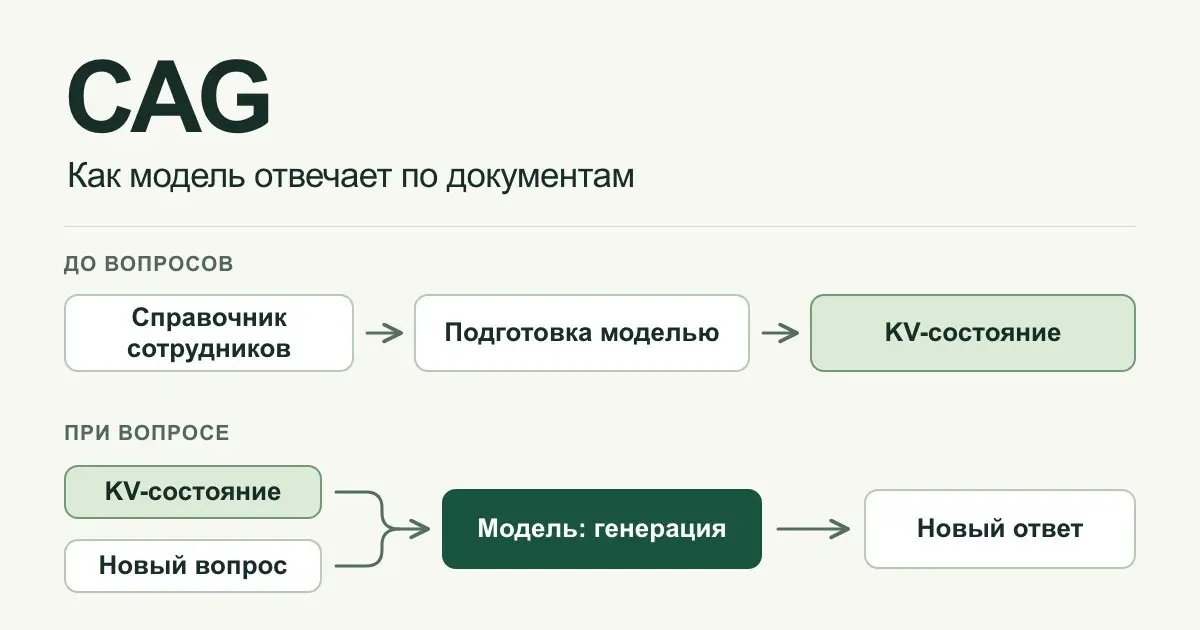
Но если справочник целиком помещается в контекст (объём текста, который модель принимает за раз), искать абзацы под каждый запрос не обязательно. В подходе CAG (Cache-Augmented Generation) весь текст заранее проводят через модель и сохраняют вычисленное KV-состояние.
Этот KV-кэш не обучает модель и не хранит готовые ответы — в нём лежат внутренние расчёты для уже прочитанного документа. Когда спрашивают про отпуск, отдельный поиск не запускается. А когда следом спрашивают про командировку, модель берёт то же состояние справочника, досчитывает только новый вопрос и заново генерирует ответ. Это не гарантирует безошибочных ответов, а при изменении справочника сохранённое состояние нужно обновить.