Codex жрёт лимиты как не в себя
Об этом не написал только ленивый. Вот и я с этим столкнулся, когда за 20 минут пятичасовые лимиты улетали просто на каких-то базовых тасках.
Я пытался с этим бороться в тупую — использовал более старые модели, наивно полагая, что чем старше модель, значит тем она хуже, значит тем она дешевле, значит её должно хватать подольше. Ставь лайк если тоже так думал.
Я бы не писал этот пост, если бы чудо произошло. А оно не произошло — лимитов мне всё равно не хватало.
Поэтому я догадался спросить у ChatGPT, а в чем, собственно дело.
И ответ меня просто шокировал!
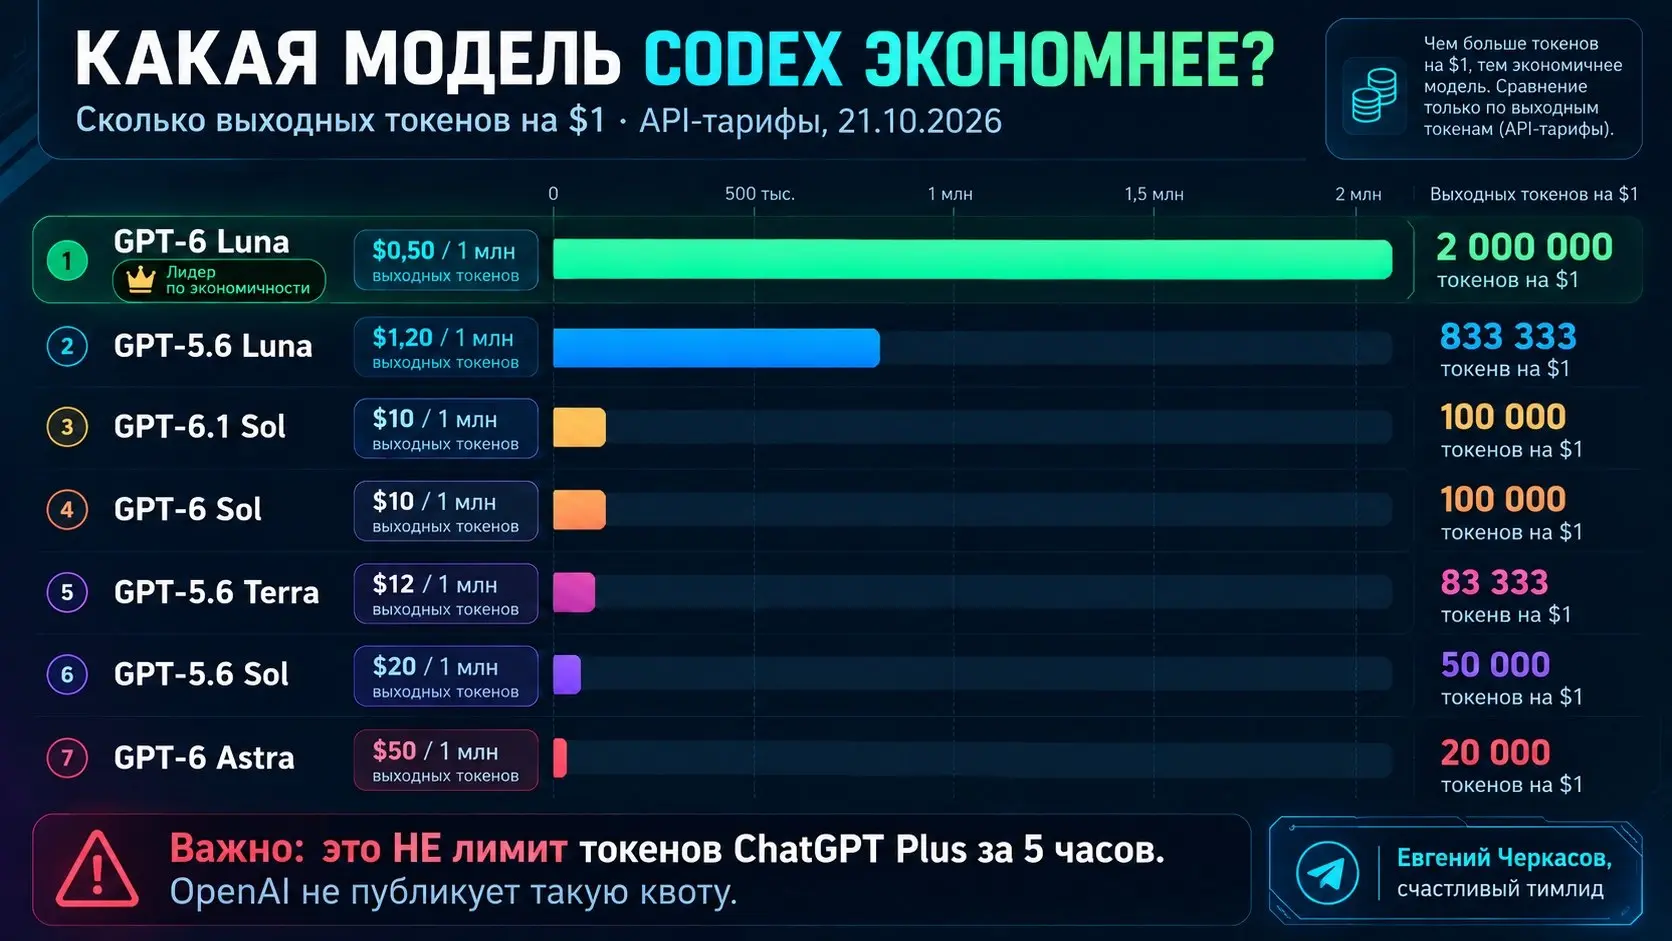
Оказывается, стоимость токена вообще не привязана к качеству модели. Более старые и тупые могут жрать токены в разы быстрее, чем более новые и более умные.
Просто представьте, GPT-6 Luna экономичнее в 100 раз чем GPT-6 Astra. А древний GPT-5.6 Sol жрет в 5 раз больше, чем его новенький брат GPT-6.1 Sol. Это что за беспредел вообще?
Вы посмотрите на эту картинку и всё поймёте.
Репостни братишке, который на кодексе, пусть тоже знает 😉
В этом посте были ссылки, но мы их удалили по правилам Сетки