


Мы научились защищать зависимости в софте ✅
Теперь нам нужно научиться защищать зависимости в ИИ.
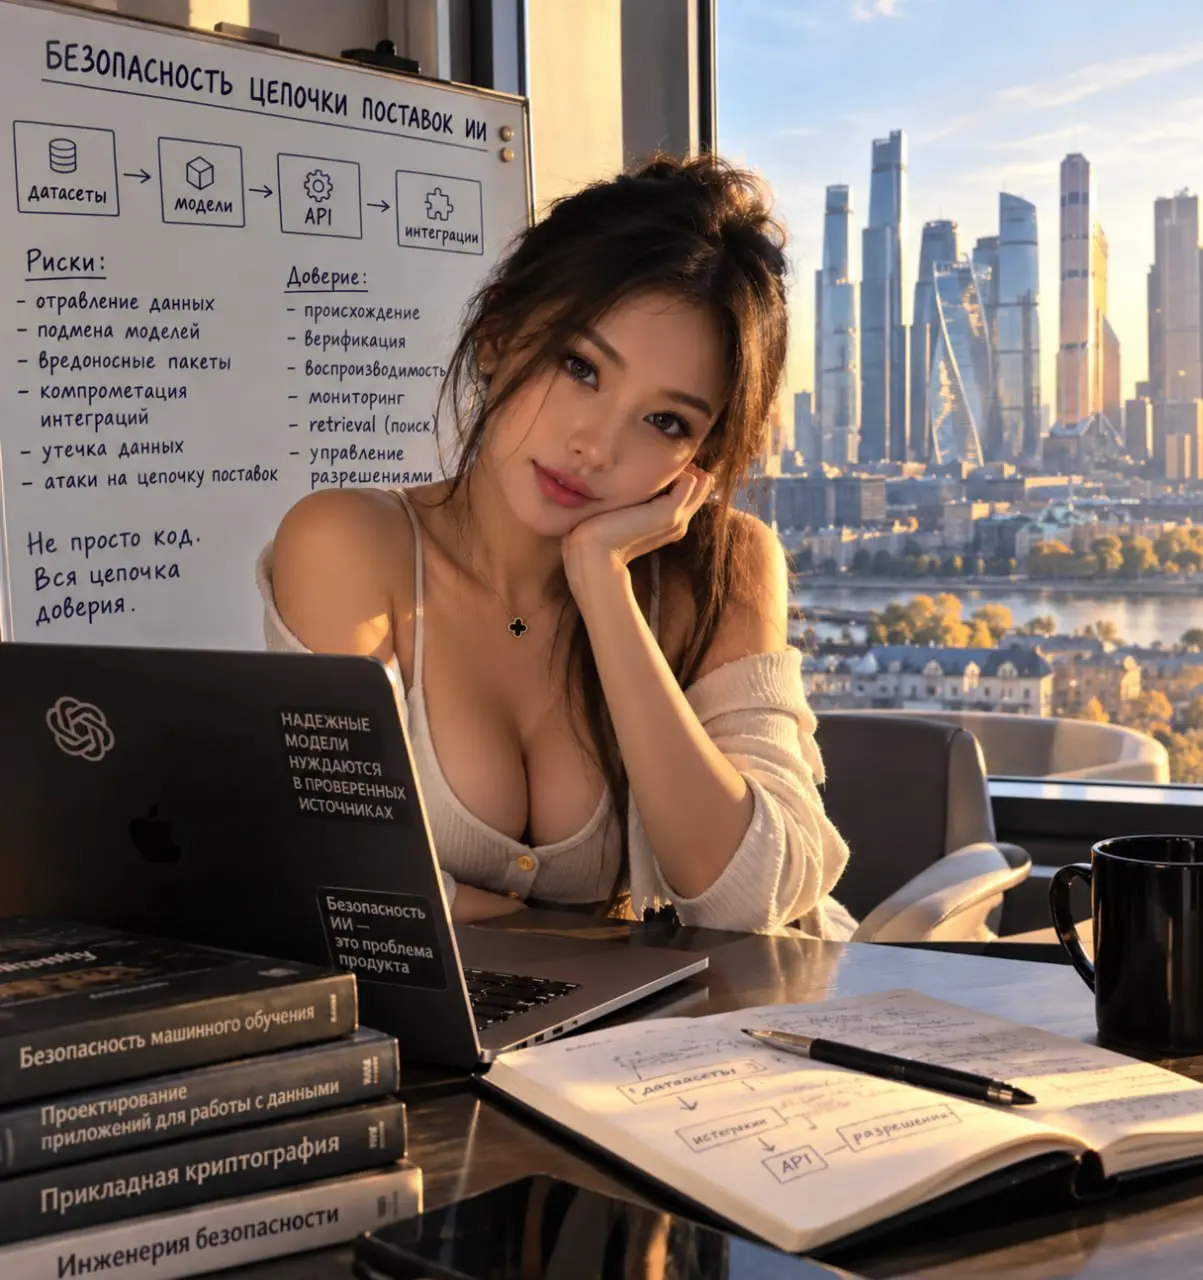
Если задуматься, современное AI-приложение может опираться на предобученную модель, сторонние датасеты, embedding-модели, внешние API, open-source пакеты и community-интеграции. ⚙️
Каждый такой компонент — это доверие. А каждое доверие — это риск.
Мы годами выстраивали практики безопасности вокруг классической цепочки поставок ПО. 🔗
Сканирование зависимостей. Подпись пакетов. Управление уязвимостями. Воспроизводимые сборки.
Но экосистема ИИ добавляет важное усложнение.
Компоненту не обязательно содержать вредоносный код, чтобы скомпрометировать систему. 🦠
Отравленный датасет может повлиять на то, чему обучается модель. Подменённый артефакт модели может изменить её поведение. Скомпрометированный источник для retrieval может исказить то, что ассистент считает надёжной информацией.
А сторонняя интеграция может незаметно расширить реальные полномочия системы. ➡️
Что особенно интересно?
Многие из этих угроз не выглядят как традиционные уязвимости ПО. Они выглядят как вполне легитимная функциональность.
Именно поэтому, как мне кажется, безопасность AI supply chain заслуживает гораздо большего внимания. ❗️
Важно защищать не только код, который запускает ИИ.
Важно защищать всю цепочку доверия, которая вообще делает ИИ возможным. ✅
Следующее поколение security engineering будет задавать не только вопрос:
«Уязвим ли этот компонент?»
Но и другой, не менее важный:
«Почему мы вообще доверяем тому, что этот компонент нам сообщает?» ❓
















· вчера
Для AI-компонентов пригодился бы аналог SBOM: версия модели и эмбеддингов, хэш датасета, источник retrieval-данных, перечень инструментов и фактические права на момент релиза. Тогда вопрос доверия превращается в проверяемый реестр, а изменение любого звена запускает повторную оценку рисков.
1
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён
· вчера
Никита, полностью согласен! По сути, речь идёт о переходе от классического SBOM к AI-BOM/ML-BOM с отслеживанием происхождения и целостности компонентов.
Причём я бы пошёл ещё дальше: одного реестра недостаточно. Важно контролировать не только состав системы на момент релиза, но и изменения в runtime.
Например, модель осталась прежней, но изменился retrieval-источник или набор доступных инструментов — формально версия приложения та же, а фактическая поверхность атаки уже другая.
Поэтому вижу здесь три ключевых направления: provenance и проверка целостности артефактов, контроль полномочий инструментов и непрерывная переоценка рисков при изменении цепочки доверия.
Особенно интересно, как всё это автоматизировать в CI/CD и MLOps без превращения security-проверок в узкое место для разработки.
Как думаешь, насколько реалистично внедрить такую модель контроля в крупных корпоративных AI-системах?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
ответ удалён