


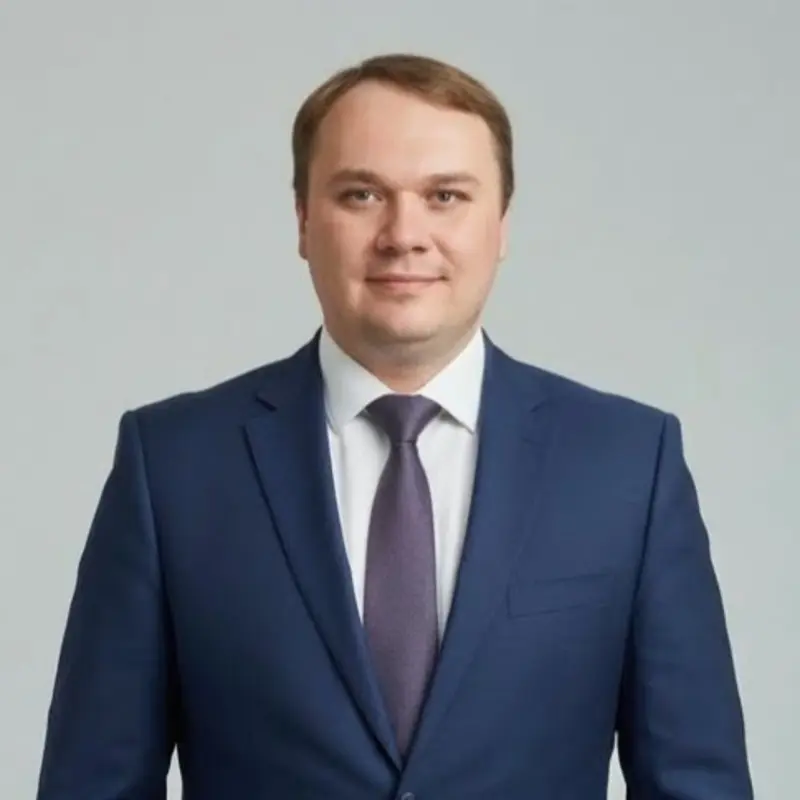
Чанкинг документов: размер, границы и перекрытие
Мы с вами уже разобрали в прошлом посте, как работает RAG. Коротко напомню: мы заранее загружаем документы, система извлекает из них текст, делит длинные тексты на небольшие фрагменты и подготавливает их для поиска. Когда мы задаём вопрос, она находит подходящие фрагменты и передаёт их текст языковой модели вместе с вопросом. Модель использует этот текст, чтобы составить ответ.
Вот эти фрагменты и называют чанками, а сам процесс разбиения — чанкингом. Но как выбрать размер такого куска и где его закончить? Просто отсчитать определённое количество символов или ориентироваться на предложения, заголовки и разделы?
В статье про чанкинг я разобрал эти способы и на короткой вымышленной библиотечной памятке показал, что меняется при разных границах. В ней обычную книгу выдают на 14 дней, а альбом с красной наклейкой из того же фонда — только на три. Если разрезать текст между этими правилами, в одном фрагменте останется общий срок, а в другом — исключение.
Можно увеличить размер чанка или сделать перекрытие, когда часть текста повторяется в соседнем фрагменте. Но это не универсальное решение: увеличенный фрагмент может захватить оба срока и при этом закончиться посередине следующего правила. Поэтому размер и способ деления подбирают под документы и вопросы к ним.
При этом разные чанки ещё не означают, что исключение потеряется: поиск может найти обе части и передать модели вместе. В статье разобрал и этот путь: что сохраняется после нарезки, что может найти поиск и какой текст в итоге передают модели для ответа.
















· 24.10
Перекрытие в 10–15% обычно спасает больше, чем точный размер чанка: смысл часто рвётся на границе, а не в середине. Проверяли на своих документах?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён