


Инференс подешевел в 280 раз, но маржа ИИ-продуктов сама не
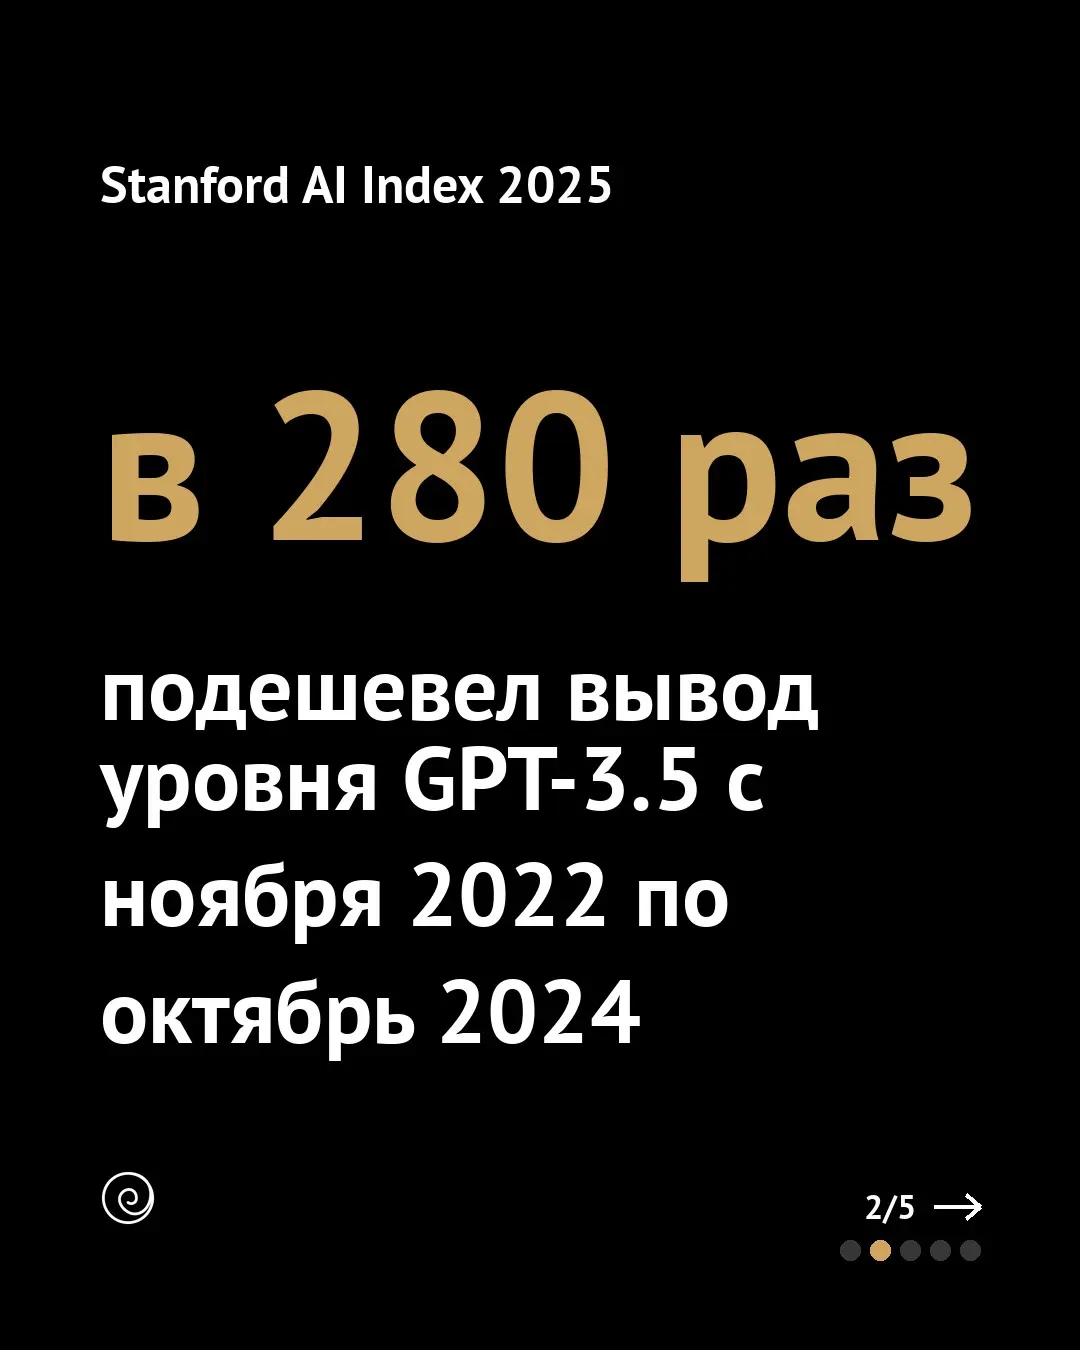
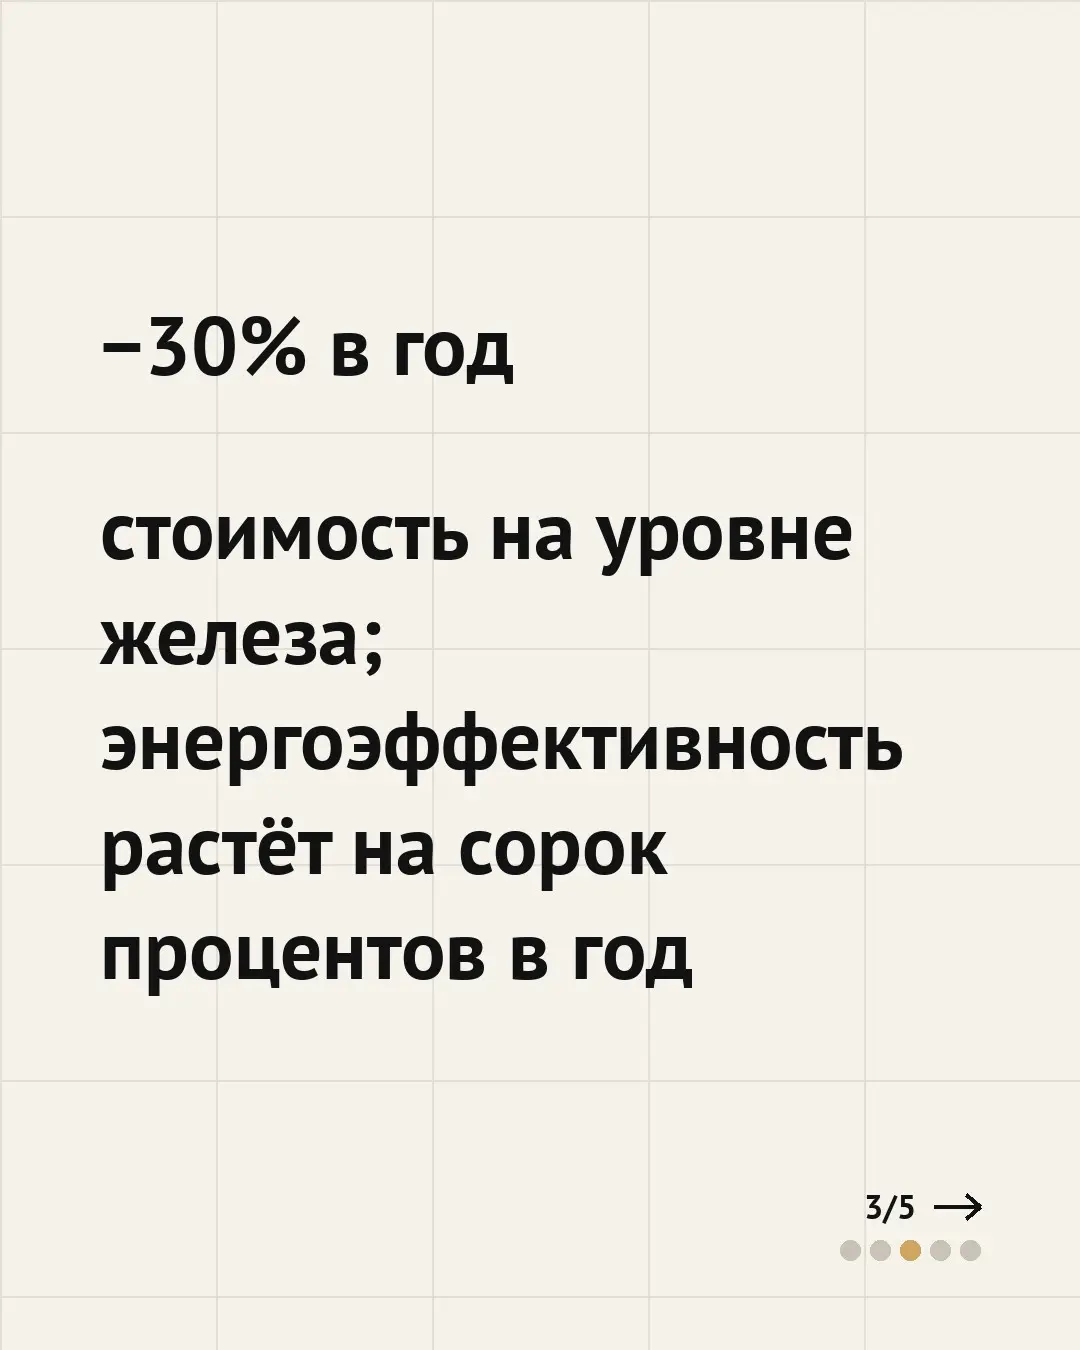
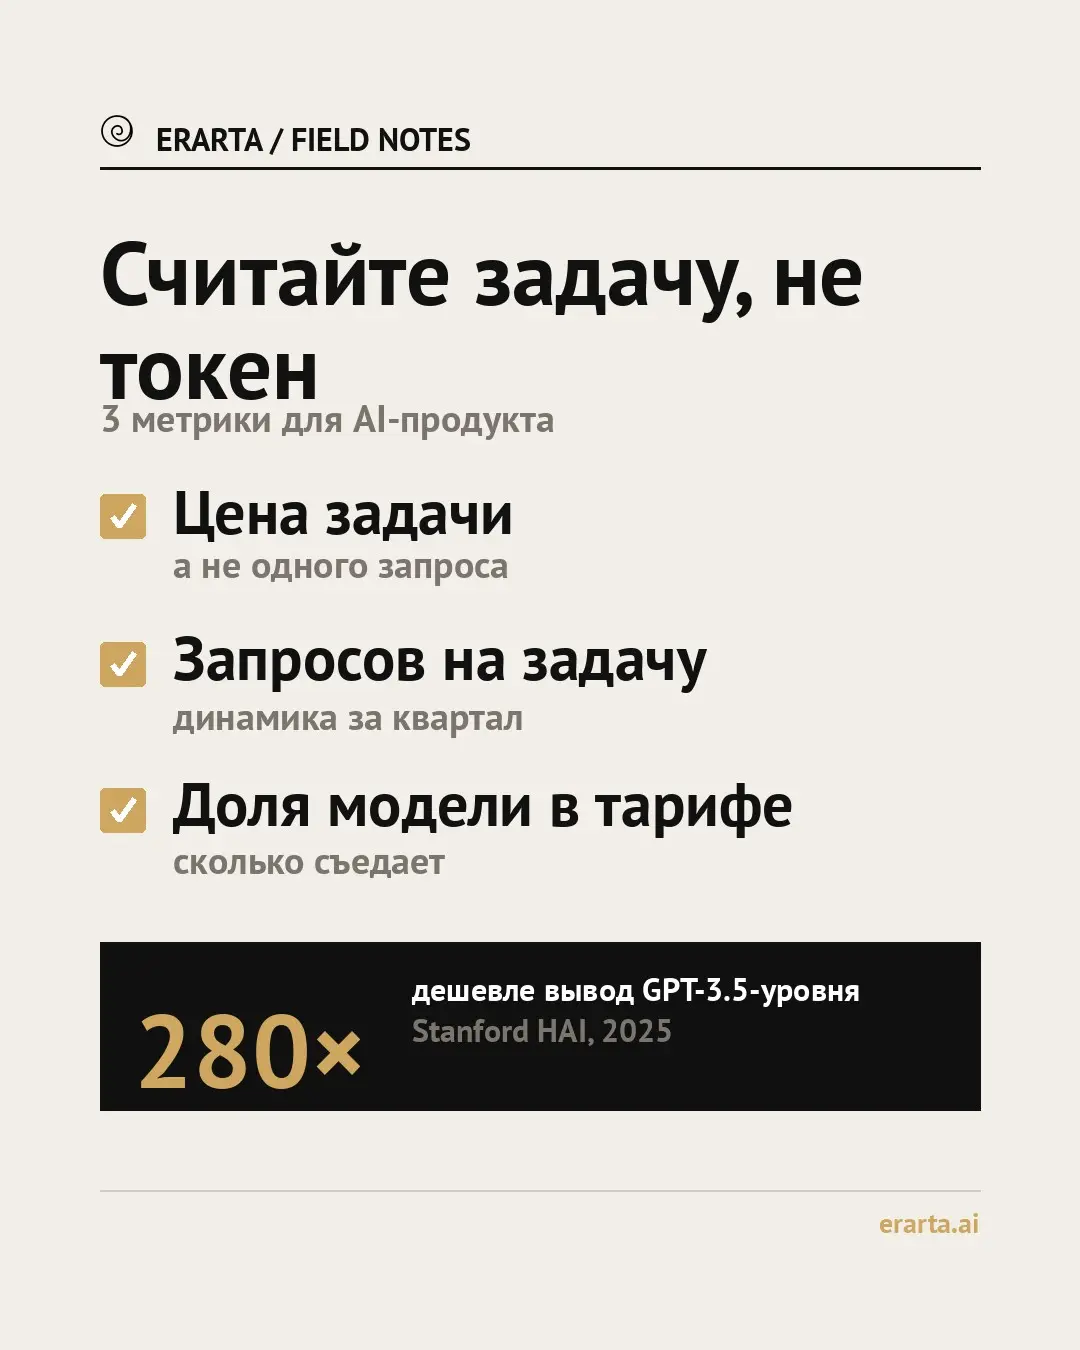
Stanford HAI в отчёте AI Index 2025 сообщил: стоимость инференса для систем уровня GPT-3.5 рухнула более чем в 280 раз с ноября 2022 по октябрь 2024 года. Причины понятны: небольшие модели стали заметно умнее, а железо прогрессирует — затраты на уровне оборудования падают на 30% в год, энергоэффективность растет на 40%.
Кажется логичным: вычисления дешевеют, значит, экономика любого AI-продукта сойдется сама собой. Но есть и другая реальность, о которой пишут a16z: спрос на вычисления сейчас превышает предложение примерно в 10 раз. Токены дешевеют, но на решение одной задачи их теперь нужно намного больше, потому что сами продукты усложняются.
Как это работает на практике: 1. Продукт переводят на легкую модель, стоимость одного запроса падает. В погоне за качеством команда вешает сверху агентов, расширяет контекст и запускает проверки ответов. Расход токенов на одну пользовательскую задачу вырастает в десятки раз. Итоговый счет за инфраструктуру растет, хотя отдельно взятый токен стоит копейки.
На что смотреть вместо цены за токен: - себестоимость готового результата для пользователя, а не отдельного вызова API; - среднее число запросов на одну задачу и его динамику за квартал; - реальную долю затрат на модель в стоимости подписки.
Дешевый токен позволяет запустить продукт. Но бизнес начинается там, где сошлась себестоимость решения задачи.
Ещё разборы без воды — в Telegram: https://t.me/evgeniydubskiy



















· вчера
В агенте каждый новый шаг заново отправляет в модель всю накопленную историю, поэтому счёт растёт быстрее, чем число шагов. Я первым делом смотрю в логах, какая часть входящих токенов повторяется от шага к шагу, и кэширую её. Сколько шагов ваш агент сделал на задаче, которую человек закрыл бы одним письмом, когда вы впервые открыли его логи?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён