


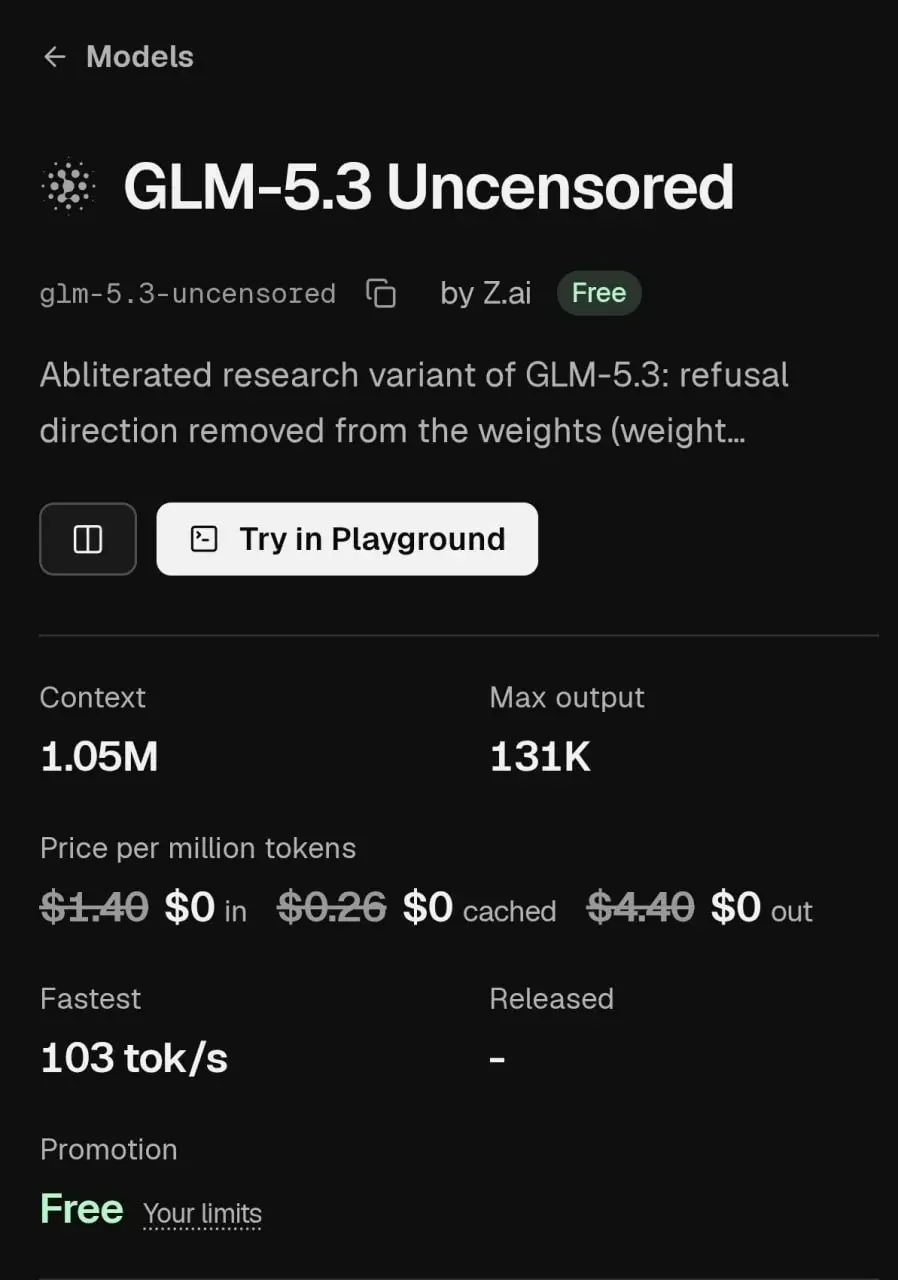
🤯 GLM-5.3: 1 млн токенов контекста, 131K выдача — и это можно потрогать бесплатно
Проверил характеристики «монстра», о котором шумят. Вот что сходится, а что — маркетинг:
✅ Контекст 1 048 576 токенов — официальная цифра. Это буквально ~1500 страниц А4 в одном запросе. ✅ Максимальная выдача 131 072 токена — тоже подтверждается спецификацией. ⚠️ Скорость 108 ток/с — реально достижима на некоторых конфигурациях (например, Flash-сборках с thinking), но у официального API чаще ~70 ток/с. Так что «шустрая», но не всегда «ракета». ✅ OpenAI-совместимый API — да, есть бесплатные тиры у нескольких провайдеров (InferAll, freetheai и др.). ⚠️ «Без цензуры» — существуют нецензурированные сборки (UNCENSORED, abliterated) на Hugging Face, но официальная модель всё же имеет встроенные ограничения. В нецензурированных версиях ответственность за запросы — полностью на вас.
PhoenixNeon✅
#GLM53 #Нейросети #БезЦензуры #AI #LLM
В этом посте были ссылки, но мы их удалили по правилам Сетки
















· 10 ч
Миллион токенов контекста звучит красиво, а что с качеством ближе к концу окна? Деградацию обычно видно только на своих данных. Вы на реальных документах пробовали или только по спецификации?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён