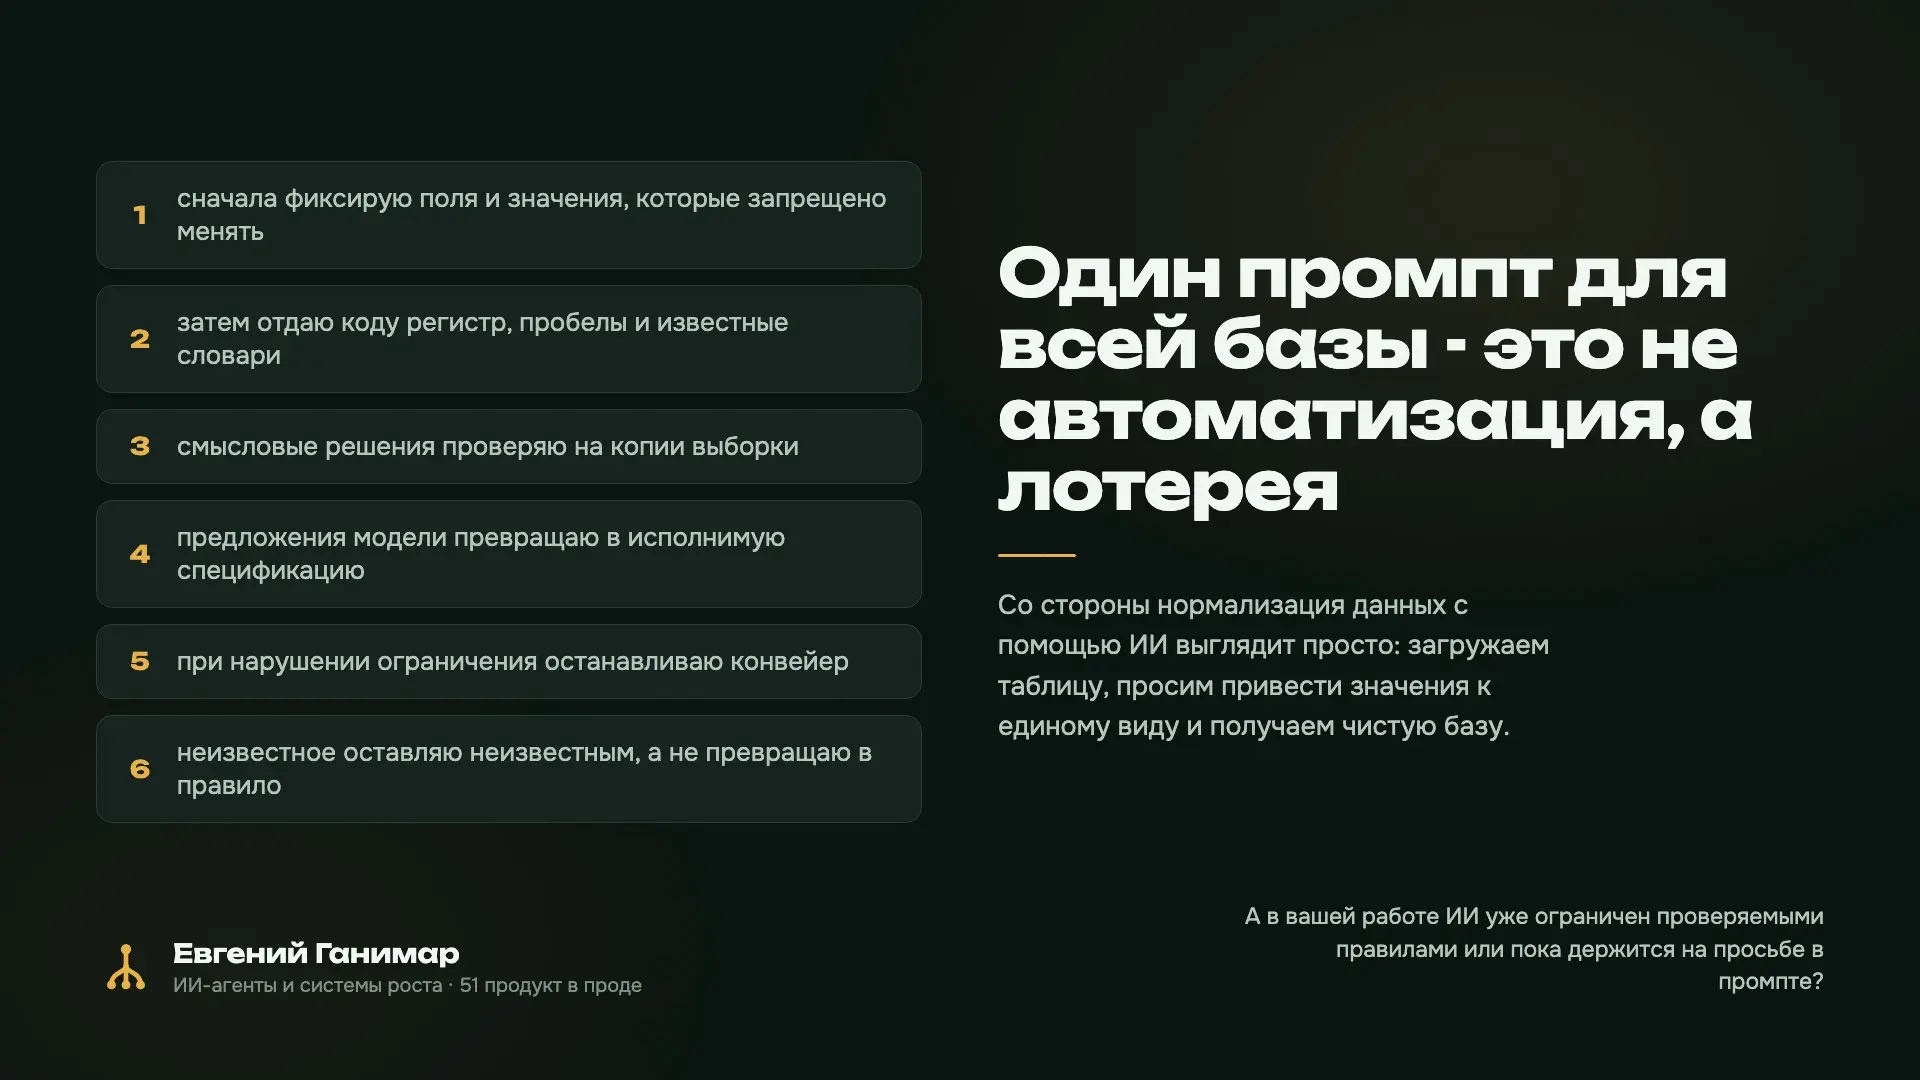
Один промпт для всей базы - это не автоматизация, а лотерея
Со стороны нормализация данных с помощью ИИ выглядит просто: загружаем таблицу, просим привести значения к единому виду и получаем чистую базу.
На самом деле между исходником и результатом должен стоять конвейер проверок. Иначе модель одновременно изучает данные, придумывает правила, меняет значения и оценивает собственную работу.
В НЕВОДе (мой контент-завод: из одной темы пишет статью и посты под каждую площадку и публикует после моей кнопки) я придерживаюсь того же принципа: модель предлагает, а код решает, можно ли пропустить результат дальше.
Изнанка процесса выглядит так:
Исходное значение: сохраняется без изменений.
Предложение модели: записывается отдельно.
Правило: переводится из свободного текста в форму, которую способен проверить код.
Причина: модель объясняет, зачем нужна замена.
Статус: применить, отклонить или отправить на ручную проверку.
Вот что тут обычно стыдно показывать: первая версия правил почти всегда выглядит убедительнее, чем работает. На выборке обнаруживаются конфликтующие замены, неоднозначные сокращения и случаи, где модель уверенно исправляет то, что менять запрещено.
Но именно эти промежуточные версии и журнал отказов полезнее красивого финала. Они показывают, где ИИ начал додумывать, какое правило оказалось слишком широким и почему обработка остановилась.
Цель не в том, чтобы модель ни разу не ошиблась. Цель - сделать так, чтобы её ошибка не добралась до следующей пачки данных.
Моя рабочая схема:
- сначала фиксирую поля и значения, которые запрещено менять; - затем отдаю коду регистр, пробелы и известные словари; - смысловые решения проверяю на копии выборки; - предложения модели превращаю в исполнимую спецификацию; - при нарушении ограничения останавливаю конвейер; - неизвестное оставляю неизвестным, а не превращаю в правило.
Подробно разобрал этот процесс по шагам здесь.
Живые примеры я складываю в витрину кейсов.
А в вашей работе ИИ уже ограничен проверяемыми правилами или пока держится на просьбе в промпте?