Поднять LLM по туториалу можно за пять минут. А вот добиться стабильных ответов под нагрузкой — уже отдельная инженерная дисциплина ⚙️
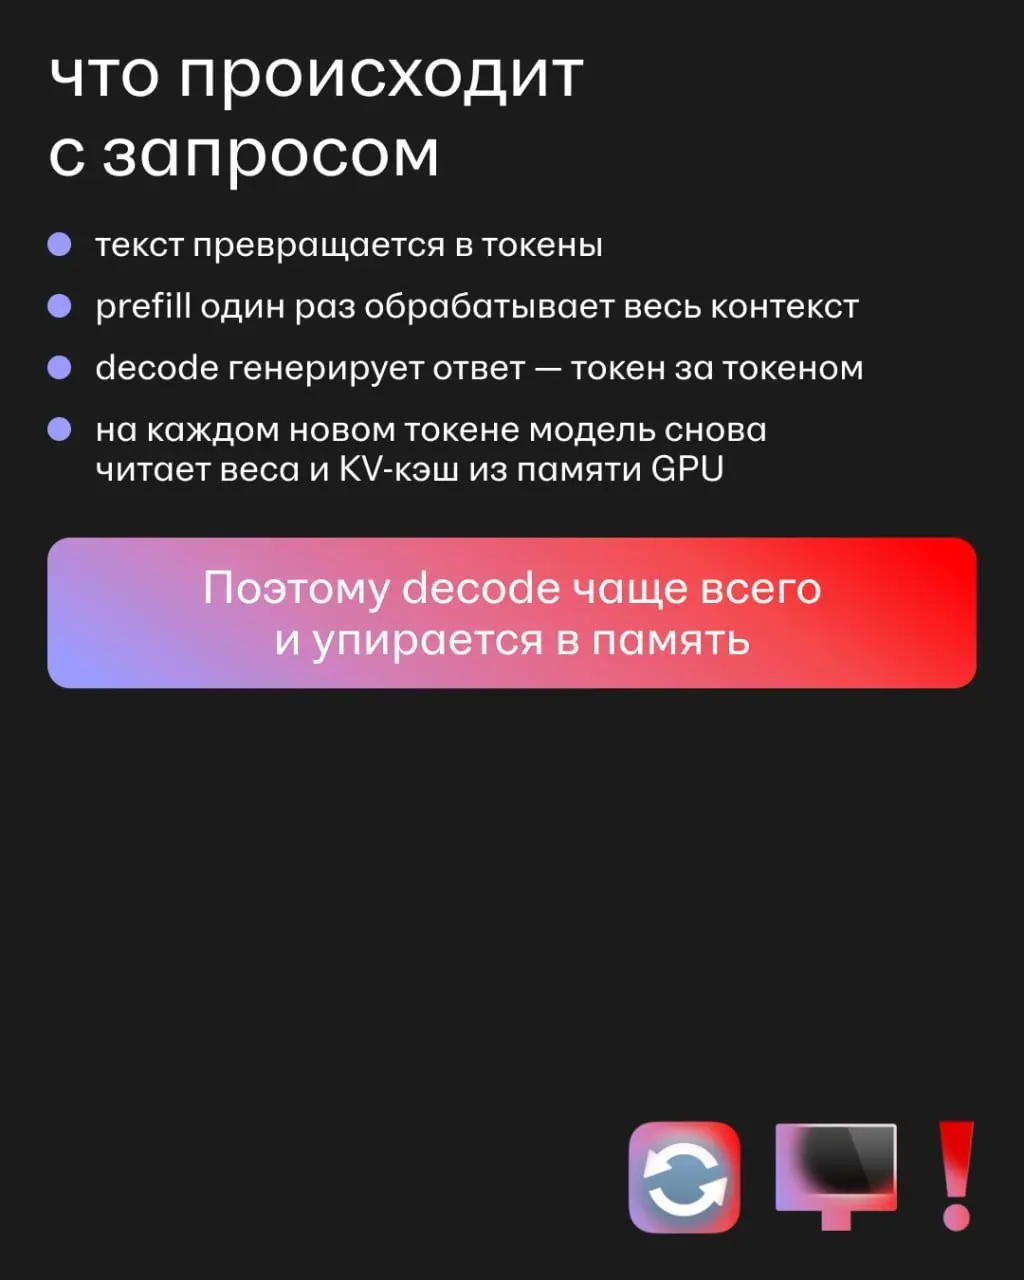
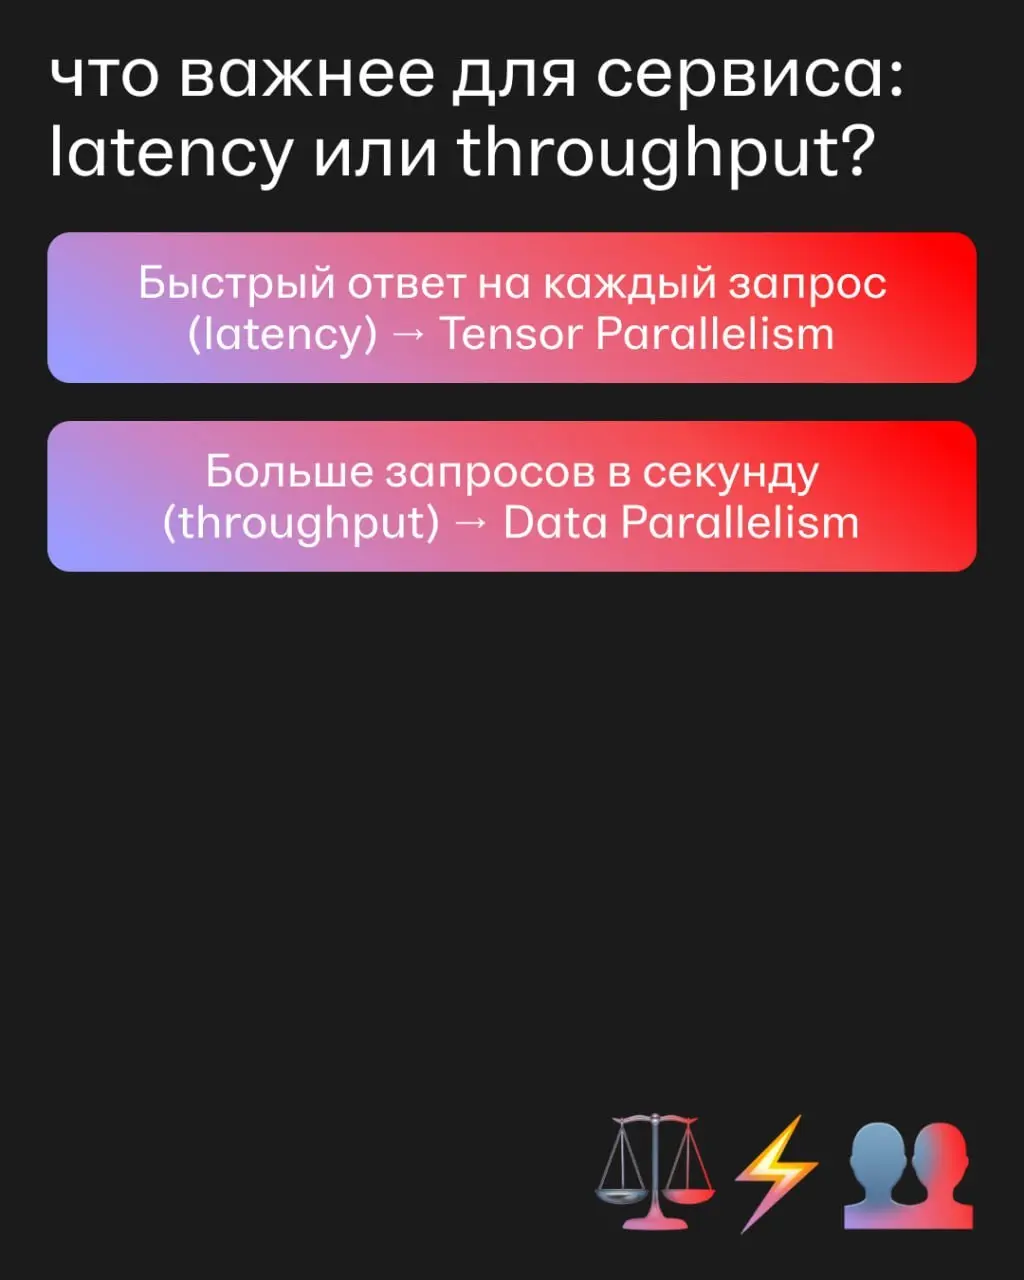
В инференсе LLM узким местом часто становятся не вычисления, а память. Причём важны две вещи: как быстро модель читает из неё данные и сколько этих данных в неё помещается. При генерации каждого нового токена модель снова читает веса и KV-кэш из видеопамяти — поэтому скорость чтения ограничивает скорость ответа. А от объёма памяти под KV-кэш зависит, сколько запросов можно обрабатывать одновременно.
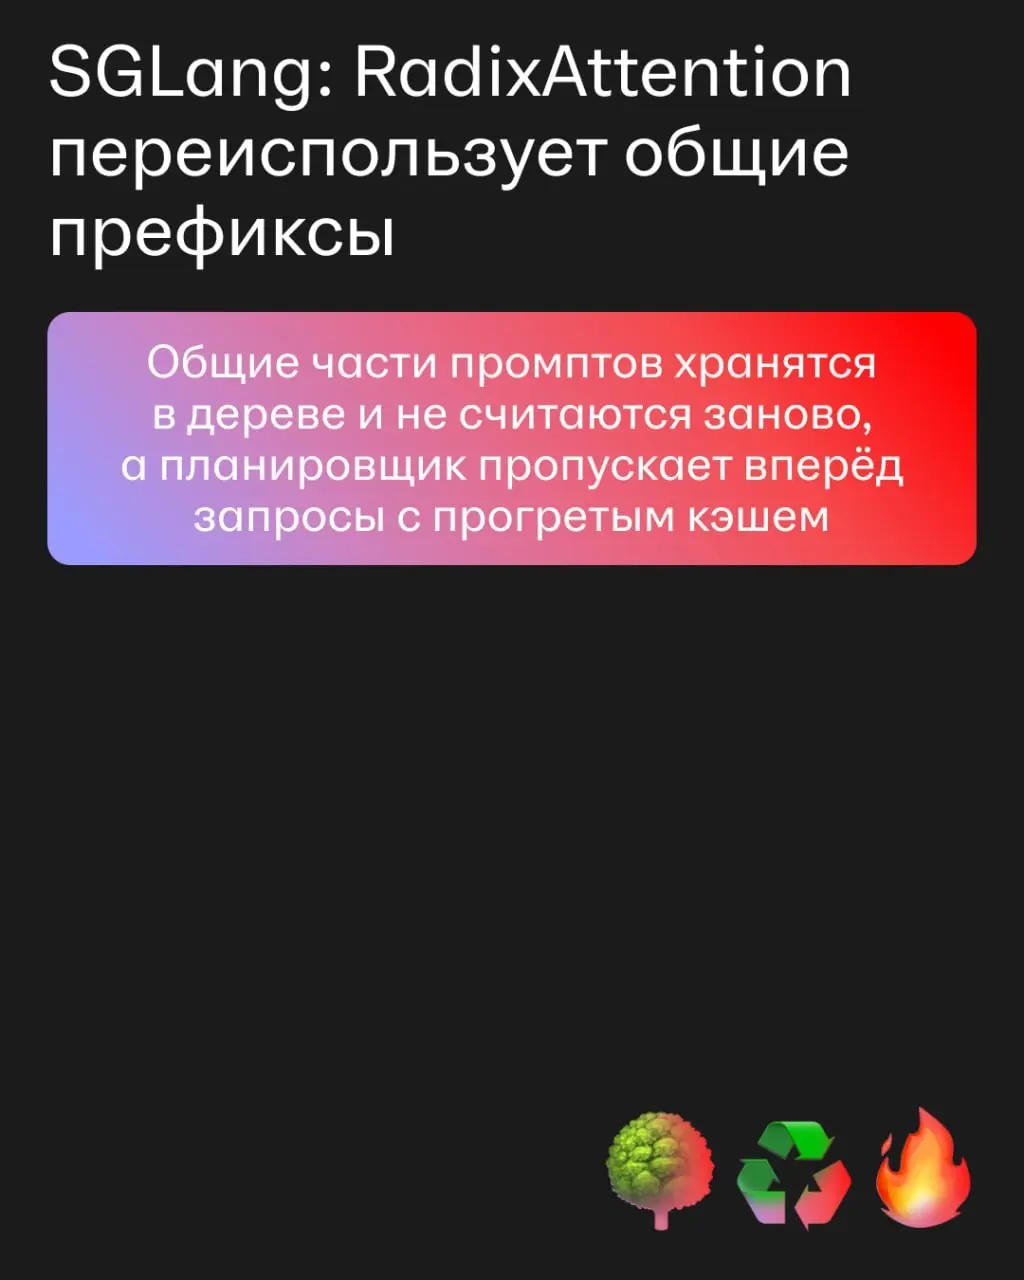
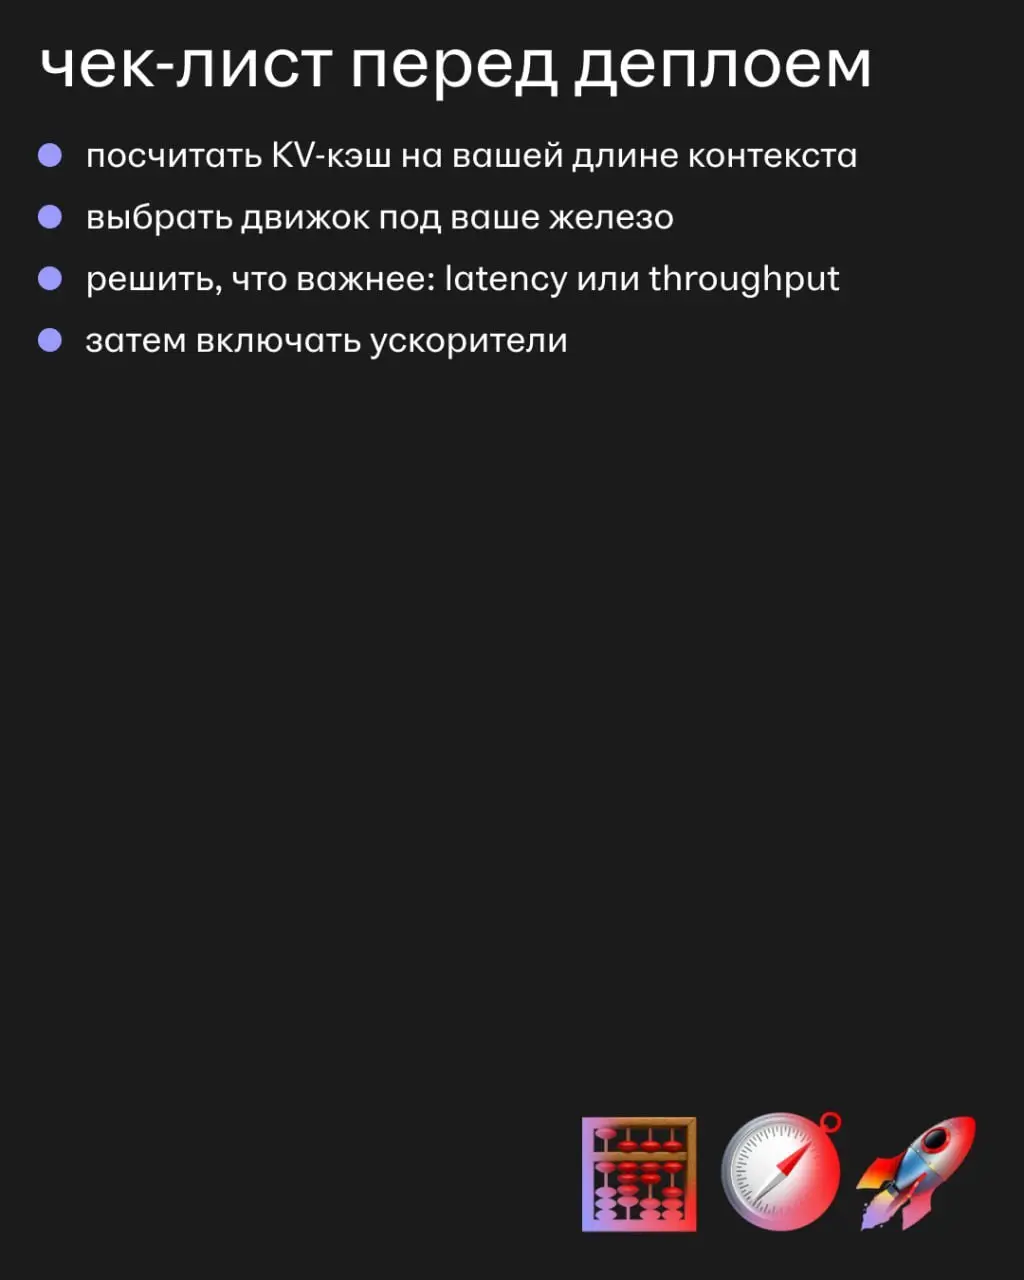
Как с этим работают vLLM и SGLang, какой движок выбрать под своё железо и как выбирать между скоростью ответа и пропускной способностью? Собрали в карточках главное из статьи Александра Рыжова, MLOps-инженера hh.ru.