


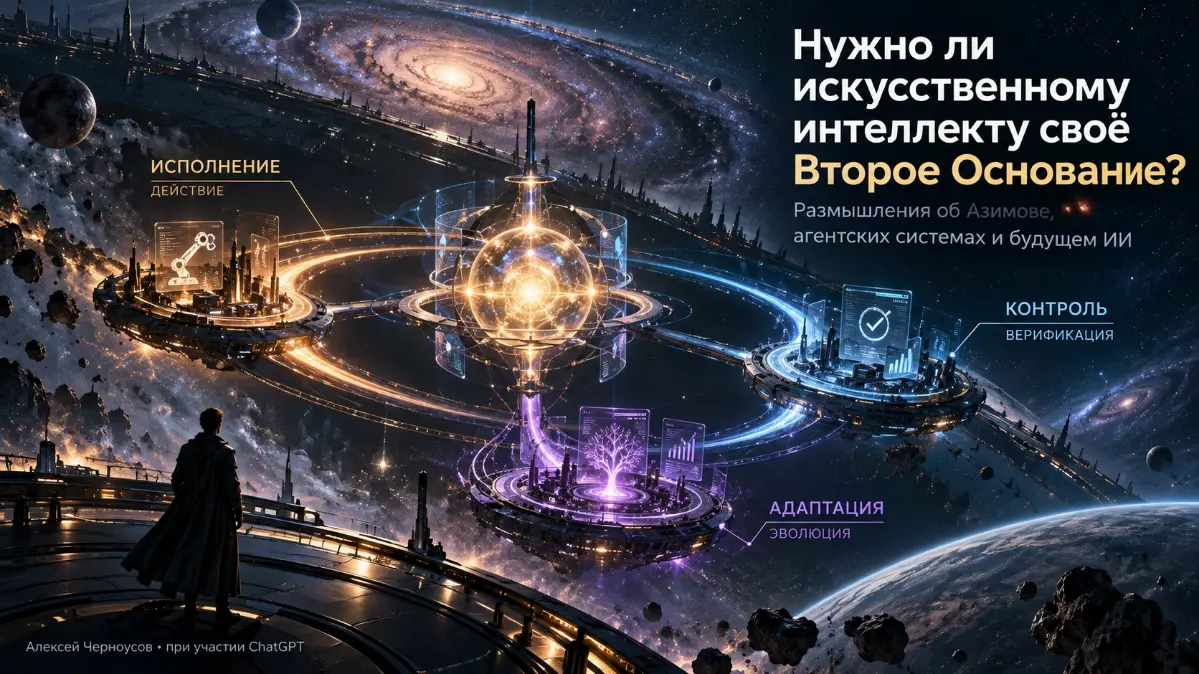
А нужно ли искусственному интеллекту своё Второе Основание?
Недавно, перечитывая цикл «Основание» Айзека Азимова и размышляя об архитектуре современных ИИ-систем, наткнулся на интересную параллель. Сегодня мы создаём всё более сложные мультиагентные системы, подключаем LLM, инструменты и оркестраторы. Но кто контролирует качество их решений? И главное, кто проверяет, не ошибочны ли сами принципы, по которым эти решения принимаются? Попробовал перенести концепцию Первого и Второго Оснований, а также Геи, на архитектуру искусственного интеллекта. Получилась гипотеза трёх взаимосвязанных контуров: Исполнение → Контроль → Адаптация. С независимой проверкой результатов, механизмами самокоррекции и элементами эволюционной оптимизации. Часть этой архитектуры уже реализую в собственной локальной мультиагентной системе. Остальное предстоит проверить экспериментально. Написал небольшую статью на стыке научной фантастики и AI Engineering. Без претензий на изобретение велосипеда, скорее попытка взглянуть на знакомые технологии под другим углом. Кому интересны ИИ, агентские архитектуры и Азимов, приглашаю почитать. Готов к обсуждению, аргументированной критике и обмену опытом. Особенно интересно мнение тех, кто уже экспериментирует с подобными архитектурами или видит в этой концепции потенциальные слабые места.
Полная статья: по ссылке
#ИИ #LLM #AIEngineering #МультиагентныеСистемы #Азимов #Основание
















· 27.10
Техническая реализация. Acer GN100. Стек - Qwen 3.8 Flash-Next + vLLM + Hermes Agent (Harness), OpenCode, Pi и MCP-инструменты. Архитектура. Execution → Verification → Adaptation. Gatekeeper. Изолированные UID/process, проверка policy/criteria, immutable snapshots, evidence-based acceptance, audit log, fail-closed. Прототип прошёл тесты, интеграция в runtime продолжается. Следующий этап, Evaluator (LLM-as-Judge + тесты), DSPy/GEPA (reflective prompt optimization, Pareto selection), risk-based routing и Adversarial Review. Моя главная цель на текущий момент - минимизировать correlated LLM failures и false acceptance rate при контролируемых затратах на inference (latency, tokens, KV-cache).
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён