Как развернуть локальный ИИ и не потратить деньги впустую? Часть 2 🛠
В прошлом посте обсуждали, почему локальные ИИ-модели становятся всё популярнее и почему не стоит начинать их внедрение с покупки железа.
Теперь давайте разберёмся, как к этому подходить на практике.
У нас уже были проекты, где мы разворачивали и дообучали локальные модели. И сейчас рекомендуем двигаться по следующему плану.
1️⃣ Сначала определяем задачи Собираем весь список процессов, которые хотим автоматизировать с помощью ИИ.
Причём важно не просто написать «хотим AI-аналитика», а понять, что конкретно он должен делать, на каких данных работать и какой результат выдавать.
2️⃣ Проверяем задачи на облачных моделях Прежде чем инвестировать в оборудование, нужно убедиться, что задача вообще решается.
Для этого можно использовать облачные модели и даже синтетические данные.
Наша цель — проверить гипотезу и добиться нужного качества результата.
3️⃣ Считаем экономику и требования к скорости Это очень важный этап, о котором многие забывают.
Представьте, что вы развернули локальную модель для аналитики, а она обрабатывает задачу сутки. При этом живой аналитик раньше справлялся за 6 часов.
В чём тогда смысл автоматизации?
Поэтому заранее определяем допустимое время ответа, нагрузку, требования к качеству и стоимость эксплуатации.
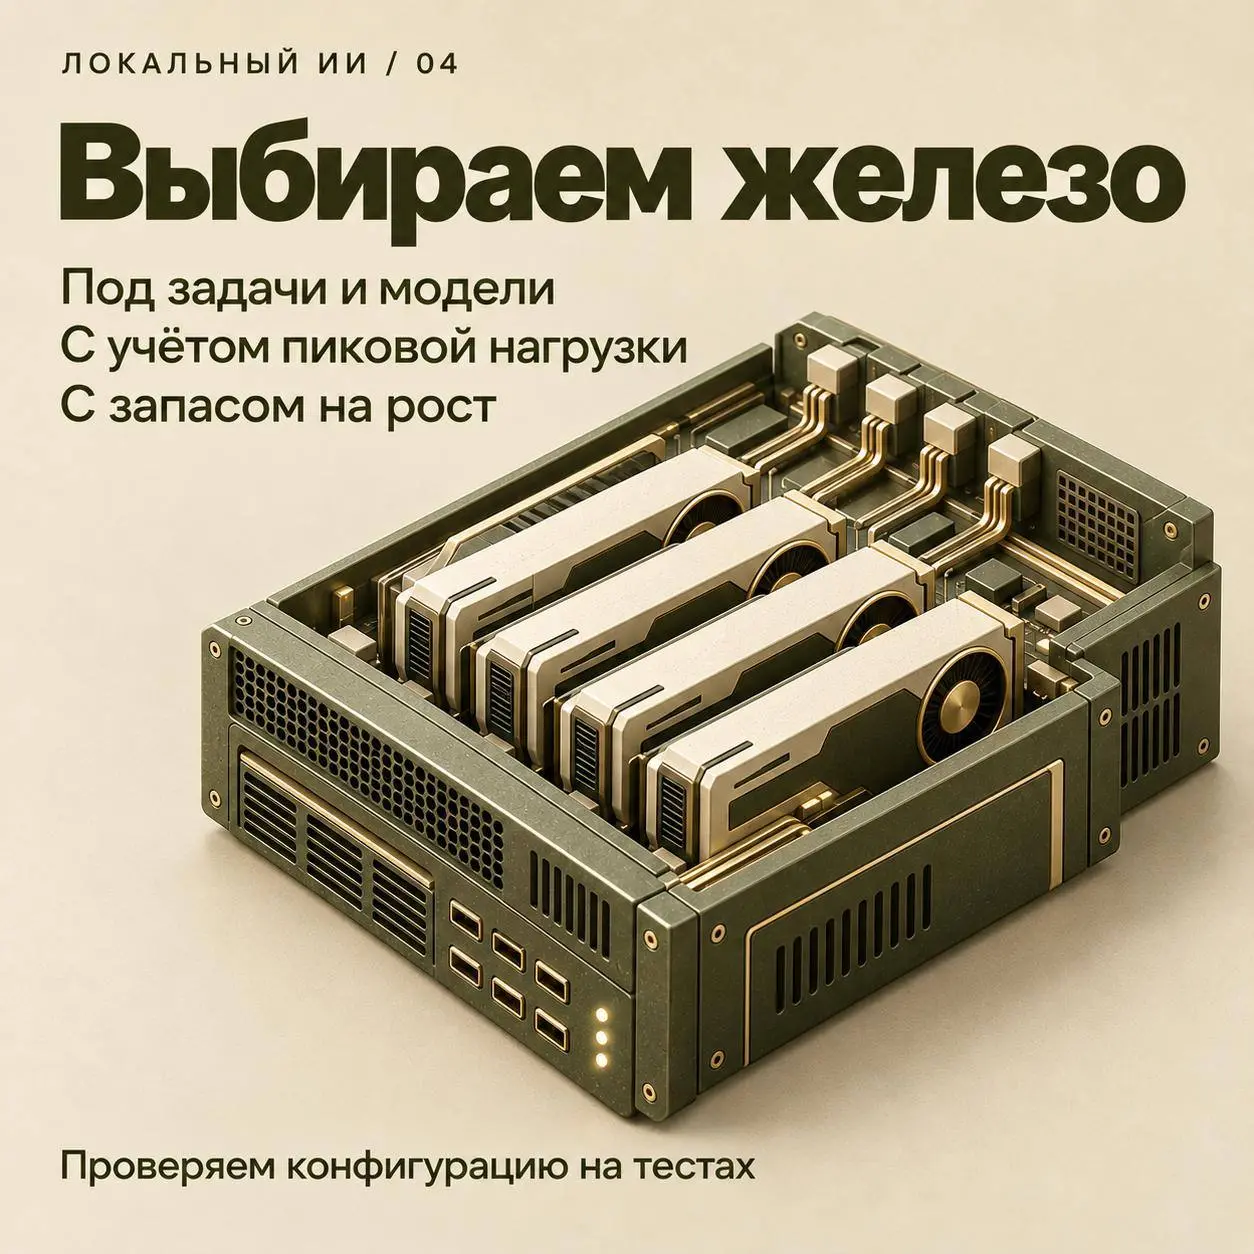
4️⃣ Только теперь выбираем железо Подбираем оборудование под конкретные задачи и модели.
При этом мы рекомендуем закладывать ориентировочно 15–25% запаса мощности с дополнительной проверкой реальных пиковых нагрузок.
Новые модели, увеличение числа запросов, дообучение — всё это может потребовать дополнительных ресурсов.
И лучше подумать об этом заранее, чем через полгода снова искать сервер.
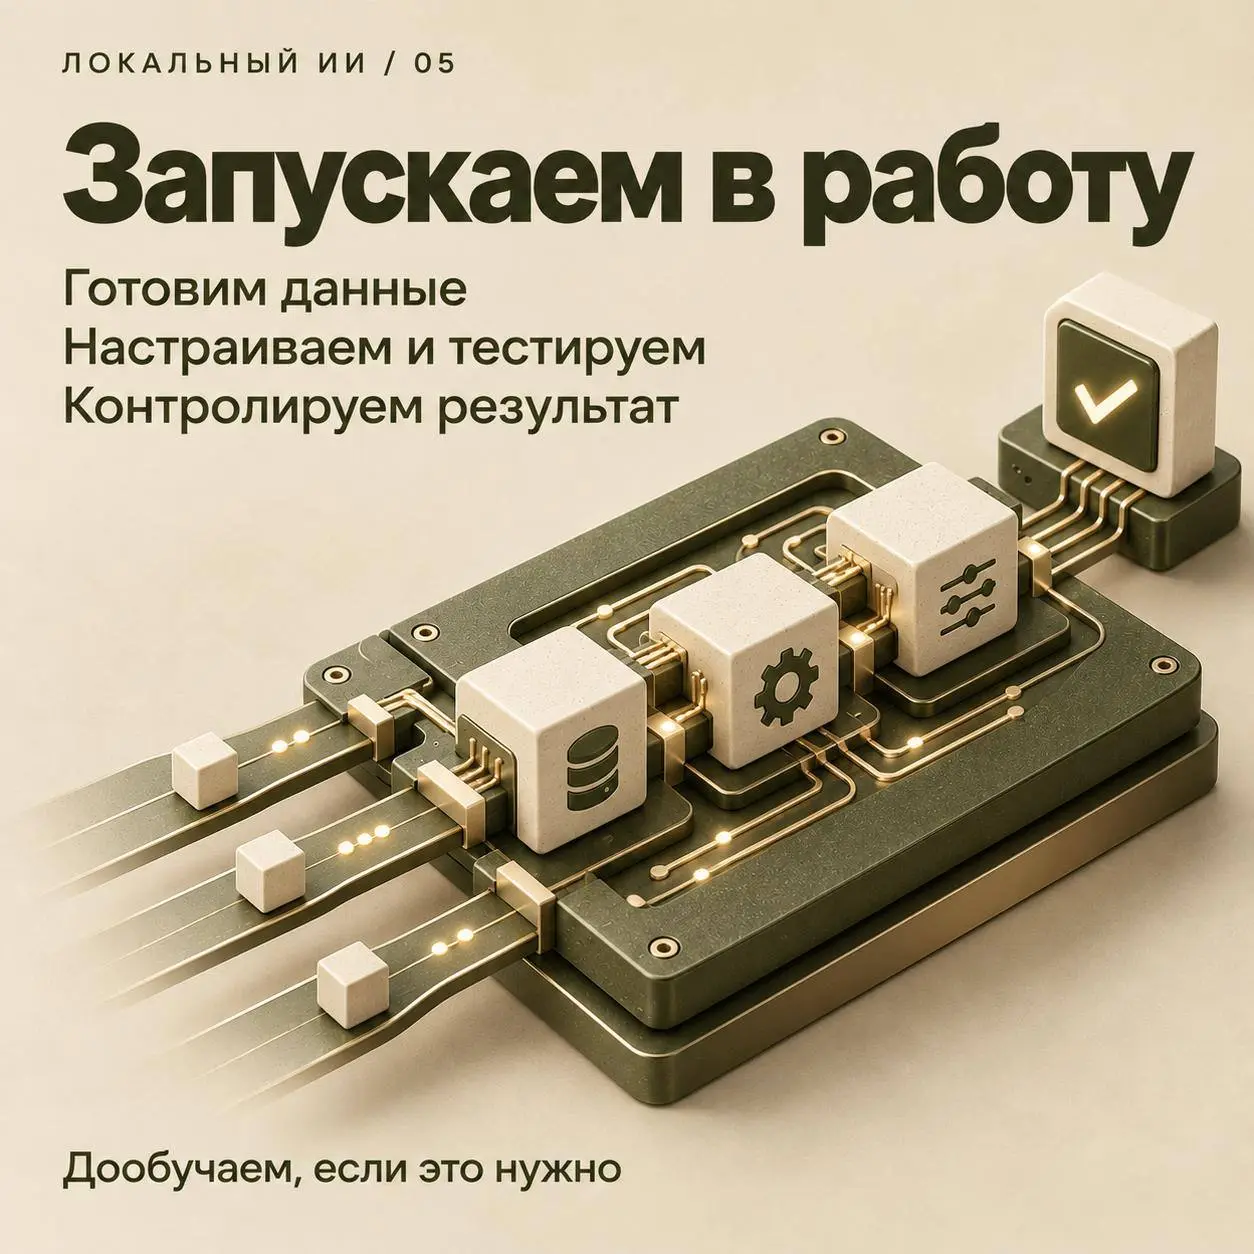
5️⃣ Разворачиваем модель и выводим в эксплуатацию Готовим датасет, устанавливаем модель, при необходимости дообучаем её на собственных данных, тестируем и только после этого запускаем в промышленную эксплуатацию.
А если бюджет или задачи пока не позволяют?
Я бы рекомендовал сначала рассмотреть облачные решения с защитой данных: обезличивание, DLP-контуры и другие инструменты безопасности.
Локальное развёртывание — не самоцель. Важно, чтобы выбранное решение действительно было эффективным.
⚡️Кстати, у нас есть интересный кейс: локальная модель, которая занимается детекцией вредоносных ботов на сайте клиента.
По нашим тестам, качество её работы существенно превосходит результаты ряда специализированных инструментов. Позже отдельно расскажу про архитектуру, результаты и особенности этого проекта.
Главная мысль: собственная модель должна решать бизнес-задачу, а не просто стоять на дорогом сервере. 👀А если вы уже рассматриваете внедрение локальных моделей, расскажите, какие задачи хотите на них перенести. Интересно посмотреть, насколько разные сейчас сценарии использования.