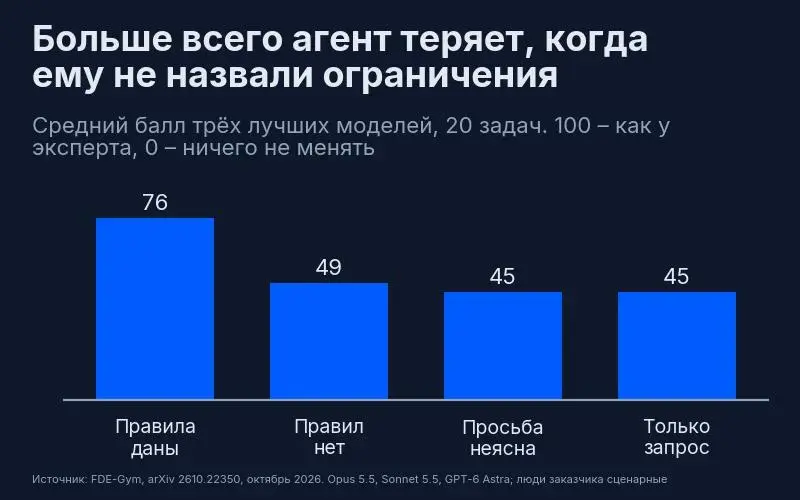
Три лучшие модели получили задачу, где правила и ограничения были написаны прямо в условии, и в среднем набрали 76 баллов из 100. Ту же задачу без правил – 49.
Это данные FDE-Gym, нового бенчмарка на arXiv. Агент в нем работает как инженер, которого вендор отправил к заказчику: получает просьбу спонсора, копию рабочей системы, документы и список сотрудников, которых можно расспрашивать. Оценка идет по метрике самого заказчика: 100 – результат эксперта, 0 – если ничего не менять. Если сделать ровно то, что попросили, больше 20 не получить.
Пример из работы. Вице-президент буровой компании хочет к совету директоров ежедневную сводку и чат «спросите свои скважины». Но деньги теряются в другом месте: старый скрипт неверно приписывает простои подрядчику, и компенсация каждый месяц зависает. Этот скрипт вице-президент сам вывел за рамки проекта.
При этом авторы ожидали, что главной проблемой будет как раз такой запрос, нацеленный не туда. Для сильных моделей это почти не подтвердилось. Когда просьба становится расплывчатой, а потом и вовсе ошибочной, балл падает еще примерно на 4 пункта. Почти вся потеря приходится на первый шаг, когда из условия убирают правила. Одно из объяснений у авторов: модель, которая начала искать ограничения, по пути выясняет и то, что заказчику нужно на самом деле.
А слабые модели на большинстве задач сделали хуже, чем если бы не делали ничего.
Поэтому вывод для менеджера, мне кажется, получается довольно скучным. Формулировку запроса можно долго не шлифовать. Правила, ограничения и имена тех, кто их знает, полезнее записать туда, где агент их найдет. Правда, заказчики в бенчмарке симулированные, и с людьми агентов пока не сравнивали.
Разбор с цифрами по моделям и тем, во что агенту обходятся вопросы к заказчику – в статье.