Baidu выпустила Unlimited-OCR 2: распознавание тысяч страниц без роста потребления памяти
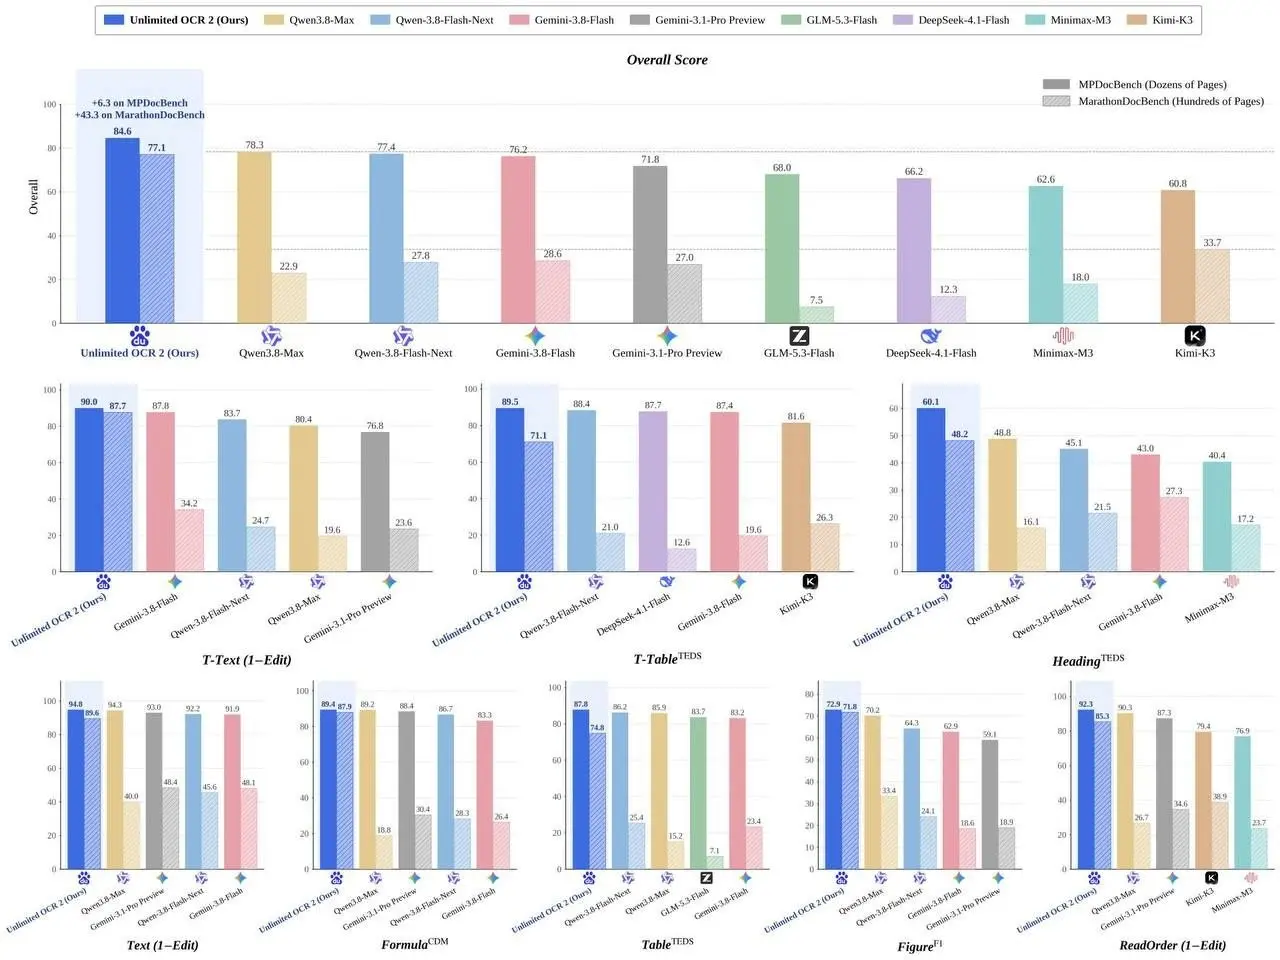
Компания Baidu опубликовала модель Unlimited-OCR 2 с открытым исходным кодом. Технология предназначена для извлечения текста, таблиц и формул из PDF-файлов и сканированных изображений.
Как это работает В основе лежит механизм Sparse Reference Sliding Window Attention (SR-SWA). В отличие от классических систем, модель не перечитывает документ целиком, а обращается только к необходимым визуальным фрагментам.
- Это позволяет сохранять расход памяти и задержку на каждом шаге декодирования практически постоянными, независимо от объема данных.
- Механизм Unlimited-Horizon Decoding освобождает участки кэша, которые больше не нужны.
Результаты тестирования ► Масштаб: за один проход успешно обработано более 3600 страниц (полная серия книг о Гарри Поттере). ► Производительность: отдельные этапы обработки ускорились до 7 раз. ► Доступность: модель распространяется бесплатно под лицензией MIT.
https://github.com/baidu/Unlimited-OCR
#UnlimitedOCR #Baidu #OCR #AI #РаспознаваниеТекста #OpenSource