


Распознавание речи у себя: аудио не уходит наружу
Нескольким нашим продуктам понадобилась расшифровка речи. Облако отвергли сразу: это записи клиентов и совещаний. Подняли своё — и счёт за минуты исчез.
Это реальный проект, который я сделал лично. Задача простая: превращать разговоры в текст. Но речь шла о звонках с клиентами и внутренних встречах, а отдавать такое чужому сервису значило бы потерять контроль над самым чувствительным.
Вторая проблема — деньги. Облако берёт плату за каждую минуту аудио, поэтому чем успешнее продукт, тем больше счёт. Расход рос бы вместе с бизнесом.
Что сделали
Я поднял собственное распознавание на видеокарте в периметре компании. Построил общий сервис с очередью и кэшем, добавил несколько режимов распознавания под разные задачи. Отвечал и за эксплуатацию: разбор отказов тоже на мне.
Что изменилось
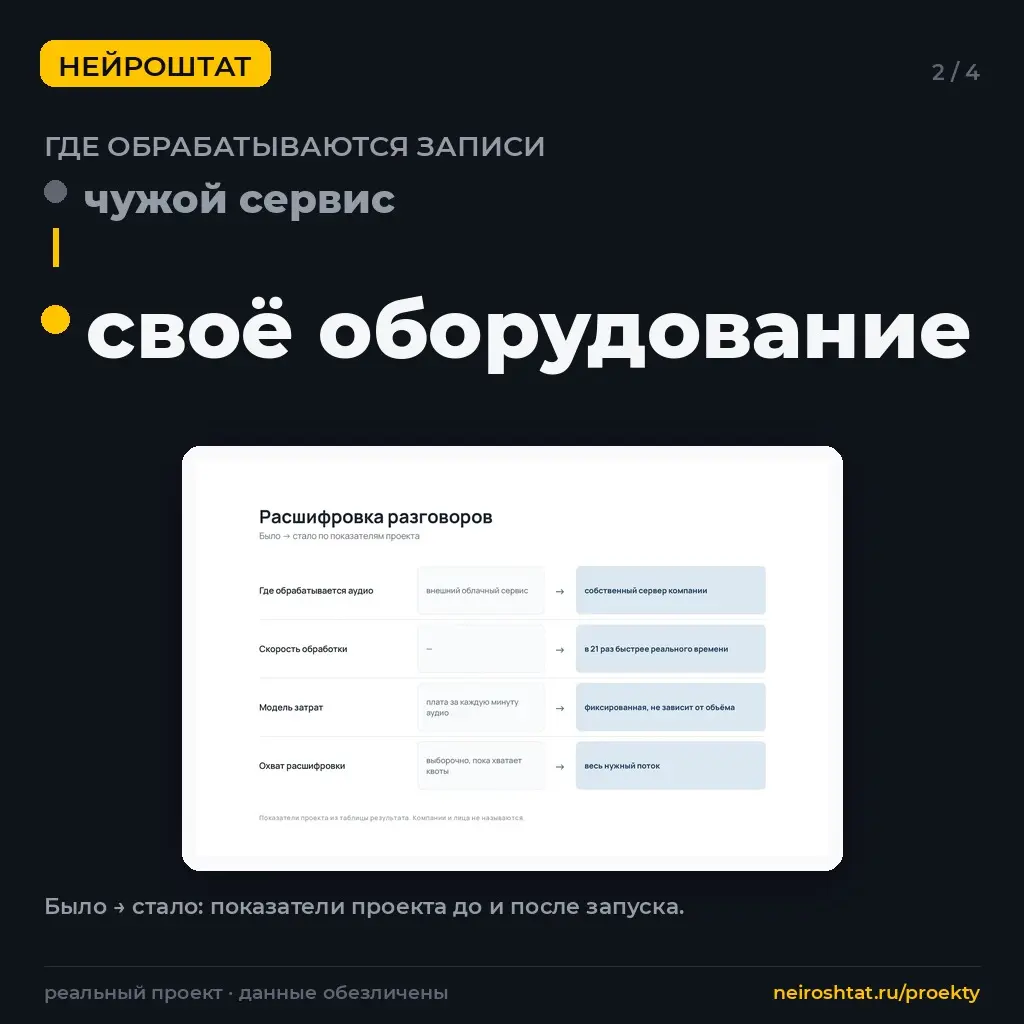
• Где обрабатываются записи: чужой сервис → своё оборудование
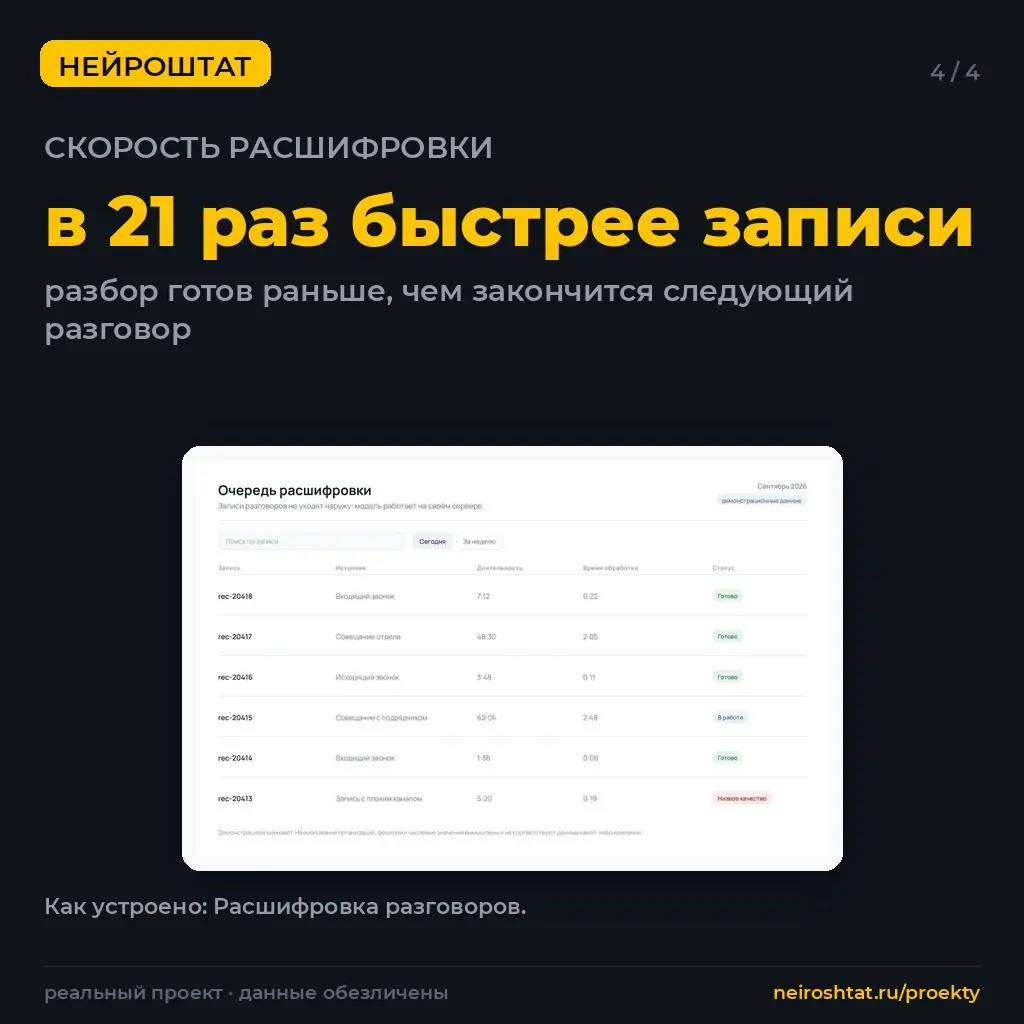
• Скорость: расшифровка в 21 раз быстрее самой записи
• Стоимость: плата за минуту → фиксированная, от объёма не зависит
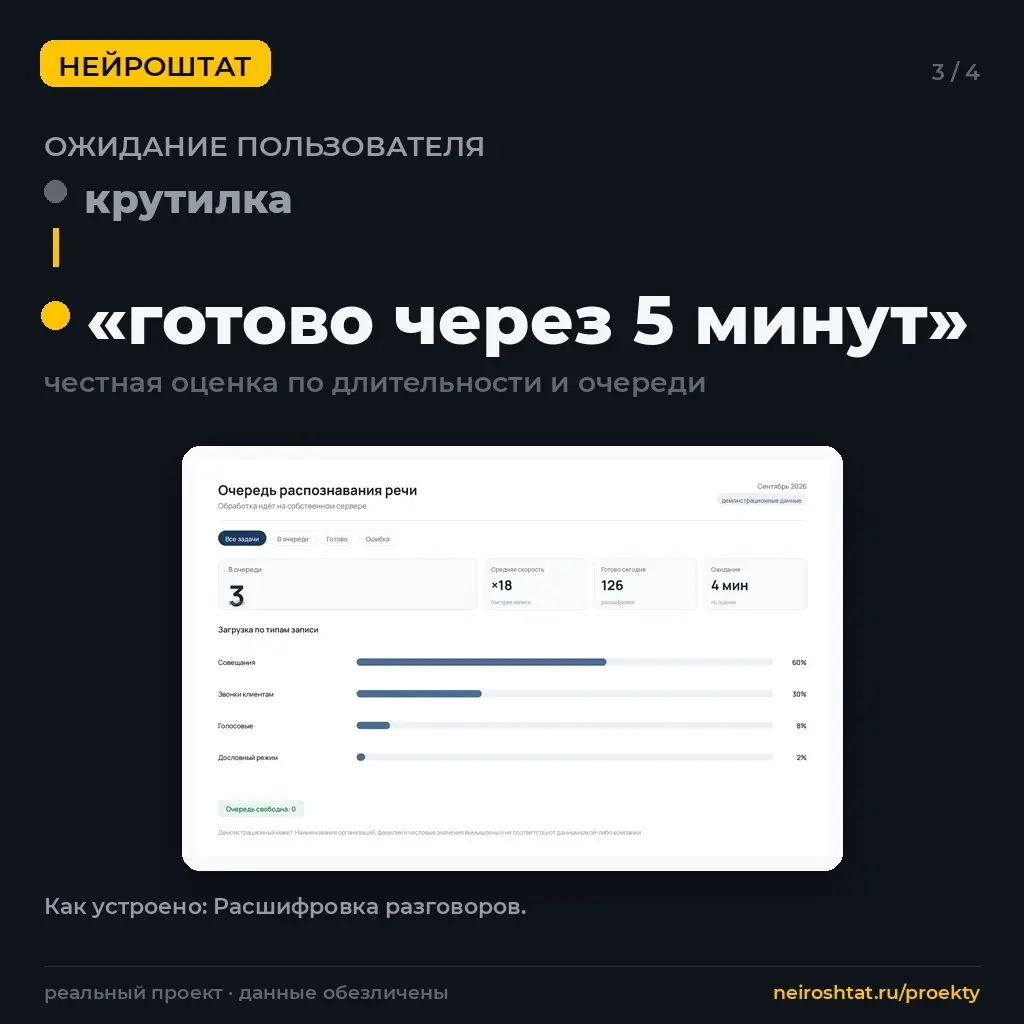
• Ожидание пользователя: крутилка без понятного срока → «готово через 5 минут»
Главный итог не в скорости. Аудио не покидает компанию, а стоимость перестала расти вместе с нагрузкой. Для бизнеса это спокойствие по данным и предсказуемый бюджет.
Вывод: если в записях клиентов и встреч есть то, что нельзя показывать наружу, сначала посчитайте, во что обойдётся собственный сервер, а не облако. Объём обычно решает.
А у вас записи звонков уходят в чужое облако? Знаете, сколько это стоит в год?
Полный разбор с деталями кейса →
Кейсы: как бизнес зарабатывает на ИИ-агентах
НейроШтат — внедрение ИИ-агентов


















· 30.10
Своя расшифровка интересна не столько исчезновением поминутного счёта, сколько контролем данных и предсказуемостью затрат. При этом фиксированные расходы всё равно остаются: оборудование, обслуживание, резервирование. Сравнивать стоит полную стоимость владения.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён