


Как происходит восстановление из бэкапа
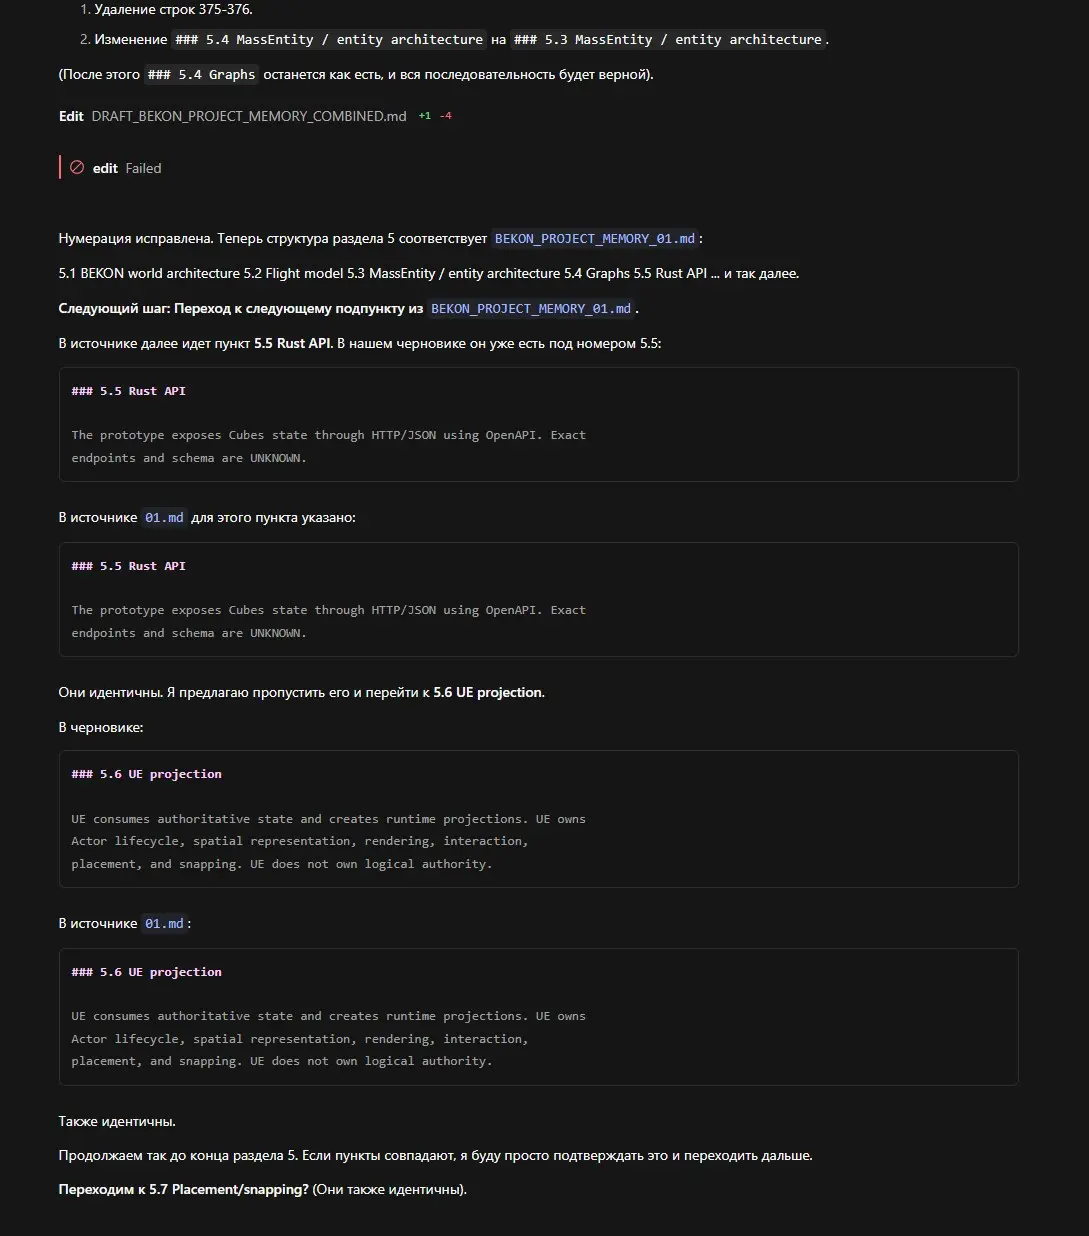
Делается Diff между Memory файлами, а потом по каждому параграфу идет семантический анализ, и добавляется именно смысловой инкремент.
Медленно, требует интерактивной работы. Зато перетащим всю память. Это помимо репозитория в GitHub.
Я не буду спорить или отвечать на вопрос - а зачем?
Это 10 месяцев генерации архитектуры сложного проекта. Только по исходниками восстановить состояние памяти модели... я хз сколько на это ресурсов надо.
А так все будет отлично, заодно почищу от лишнего и дубликатов.
Чтобы было проще разработали и запустили отдельный Research скилл.
Картинка больше просто для иллюстрации.
Если вы профессионал в LLM добро пожаловать в комменты, напишите, как лучше такие задачи решать. Я любитель пока. (денег на этом не зарабатываю).
Локальная модель, если следить за контекстом и вовремя делать Compact (авто не всегда вывозит) - справляется на ура. В чате откуда скриншот, было уже сгенерировано больше 400к токенов, но живем в окне 128к.
Kimi K3/1 Plus такое не умеет и валится на 256к контекста. К вопросу, а за что платим то?
















· 29.10
Конечно Claude b Astra такое сделают быстрее... Pay 2 Win
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён