На обучении GPT видит всю фразу — но не может подсмотреть вправо
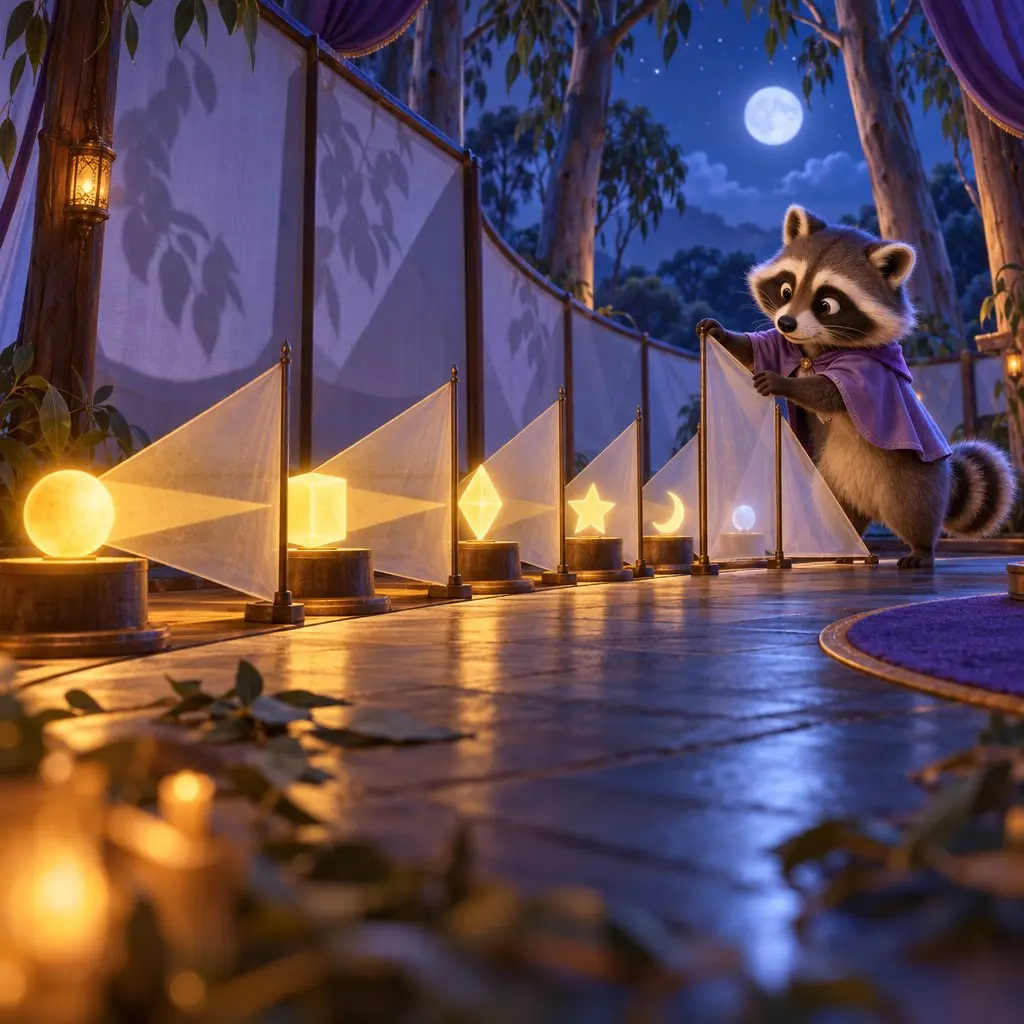
Текст обычно подают модели целиком, поэтому возникает вопрос: что мешает ей просто увидеть следующее слово? Каузальная маска внимания. Она закрывает для каждой позиции все будущие токены: представление текущего фрагмента может учитывать только его самого и то, что стояло раньше.
При этом модель вычисляет множество таких позиций параллельно — обучение не обязано идти слово за словом. А во время обычной генерации будущего текста ещё нет, поэтому ответ действительно появляется последовательно.
Такая маска — не цензура, а правило времени: сначала контекст, потом продолжение.