


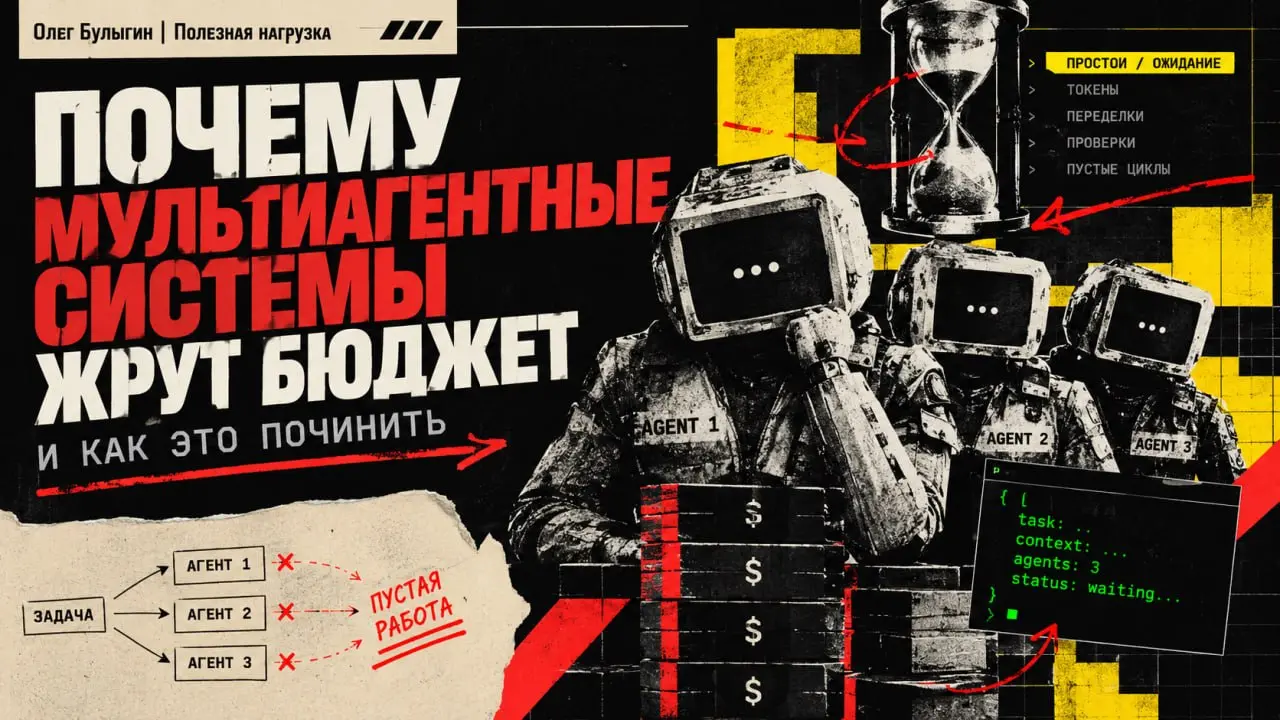
Почему мультиагентные системы жрут бюджет и как это починить Включение нативных сабагентов в Claude Code или Codex делает решение задач в разы дороже, часто медленнее, а иногда и вовсе роняет качество на треть. Исследователи из Стэнфорда в свежем препринте показали, что классический подход с «агентом-начальником» порочен в своей основе, и предложили фреймворк DeLM, получив ускорение до 2.5× при росте точности на 10–18%.
Вся текущая индустрия мультиагентных систем больна одной бедой — пузырями простоя. Это процессорное время и токены, которые тратятся не на написание кода, а на ожидание или переделывание чужой работы:
1️⃣ Независимые агенты (best-of-n, repeated sampling) не ждут никого, но не делятся контекстом. В итоге три агента параллельно наступают на одни и те же грабли и тратят бюджет на проверку тупиковых гипотез. 2️⃣ Синхронные раунды (дебаты агентов) упираются в барьер синхронизации: все ждут ответа самого медленного участника, а затраты на пересылку сообщений растут как квадрат от числа агентов. 3️⃣ Централизованный оркестратор (те самые subagents в Claude Code, Codex, AOrchestra) — худший вариант. Главный агент раздает подзадачи и... тупо ждет.
На длинной задаче из Terminal-Bench 4.0 главный агент Claude Code провел 73% своего времени в ожидании ответов от сабагентов. Пока сабагент ковыряет код, босс курит. 🚬
Дальше включается испорченный телефон: результаты сабагента сжимаются в саммари для контекста главного агента, важные детали теряются, а соседи-сабагенты вообще не знают о существовании друг друга.
На бенчмарке DeepSWE v1.1 включение нативных сабагентов в Claude Code обвалило точность с 71.7% до 50.0%, взвинтив задержку и увеличив расходы на 65%. Агенты упирались в таймауты ожидания и плодили бесконечные циклы «проверь-перепроверь».
Что сделали в Стэнфорде? Авторы выкинули центрального координатора и внедрили следующие подходы: 🔵 Task Queue (децентрализованная очередь задач). Агенты сами асинхронно берут таски по принципу first-claim-wins. Залочил задачу — решаешь. Никакого менеджера, распределяющего нагрузку. 🔵 Shared Context (append-only лог находок). Общая доска, куда агенты скидывают компактные заметки трех типов: FACT (проверенный факт), FAIL (опровергнутая гипотеза или ошибка) и PATCH_SUMMARY. 🔵 Файлы по ссылке (demand paging). Вместо того чтобы засорять контекст простынями кода, агент прикладывает ссылки на файлы. Коллеги смотрят только диффы через команду expand, а в свой воркспейс затягивают через apply только то, что реально нужно. На чтение общего контекста уходит всего 2–4% от общих токенов задачи.
В тесте на фикс бага в Sympy первый агент понял, что фикс нерабочий, и запушил это в лог. Второй агент мгновенно прочитал это, вычеркнул тупиковое направление и через минуту локализовал реальный баг. Без этого каждый агент сжег бы по $0.40 на проверку одной и той же очевидной, но неверной идеи.
Результаты на длинных тасках (где агенты реально должны думать и кодить часами, а не править опечатки в ридми) такие: Terminal-Bench 4.0 (10 сложных задач): DeLM на Claude Opus 5.5 выдал 93.3% точности против 81.7% у базового Claude Code и 80.0% у варианта с сабагентами, отработав в 2.02 раза быстрее и сожрав меньше денег ($17.91 против $20.31 на задачу).
SWE-bench Verified (Gemini 3 Flash): DeLM с 4 агентами показал 66.1% (против 55.3% у оркестратора AOrchestra и 49.3% у Claude Code), работая в 2.12 раза быстрее.
Экономический нокаут: DeLM на дешевой модели DeepSeek-V4.1-Flash на задачах DeepSWE показал 88.33% точности. Ровно столько же, сколько базовый Codex на топовой GPT-6-Astra. Только у GPT-6 задача стоила $9.40, а у DeepSeek через DeLM — $0.33. В 28 раз дешевле за тот же результат.
В общем, параллелить LLM-агентов имеет смысл только тогда, когда у них есть прозрачная среда коммуникации и обмен ошибками.
Забавно, как архитектура AI-систем в очередной раз повторяет законы реальной жизни: убираешь неэффективного тимлида-микроменеджера, вешаешь прозрачную канбан-доску, заставляешь открыто писать о факапах — и внезапно команда перформит в два раза быстрее за меньшие деньги 🙃
















· вчера
Про пузыри простоя у агентов звучит убедительно, на практике и правда часто три агента копают одно и то же. Интересно, как DeLM делит контекст между ними.
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён