


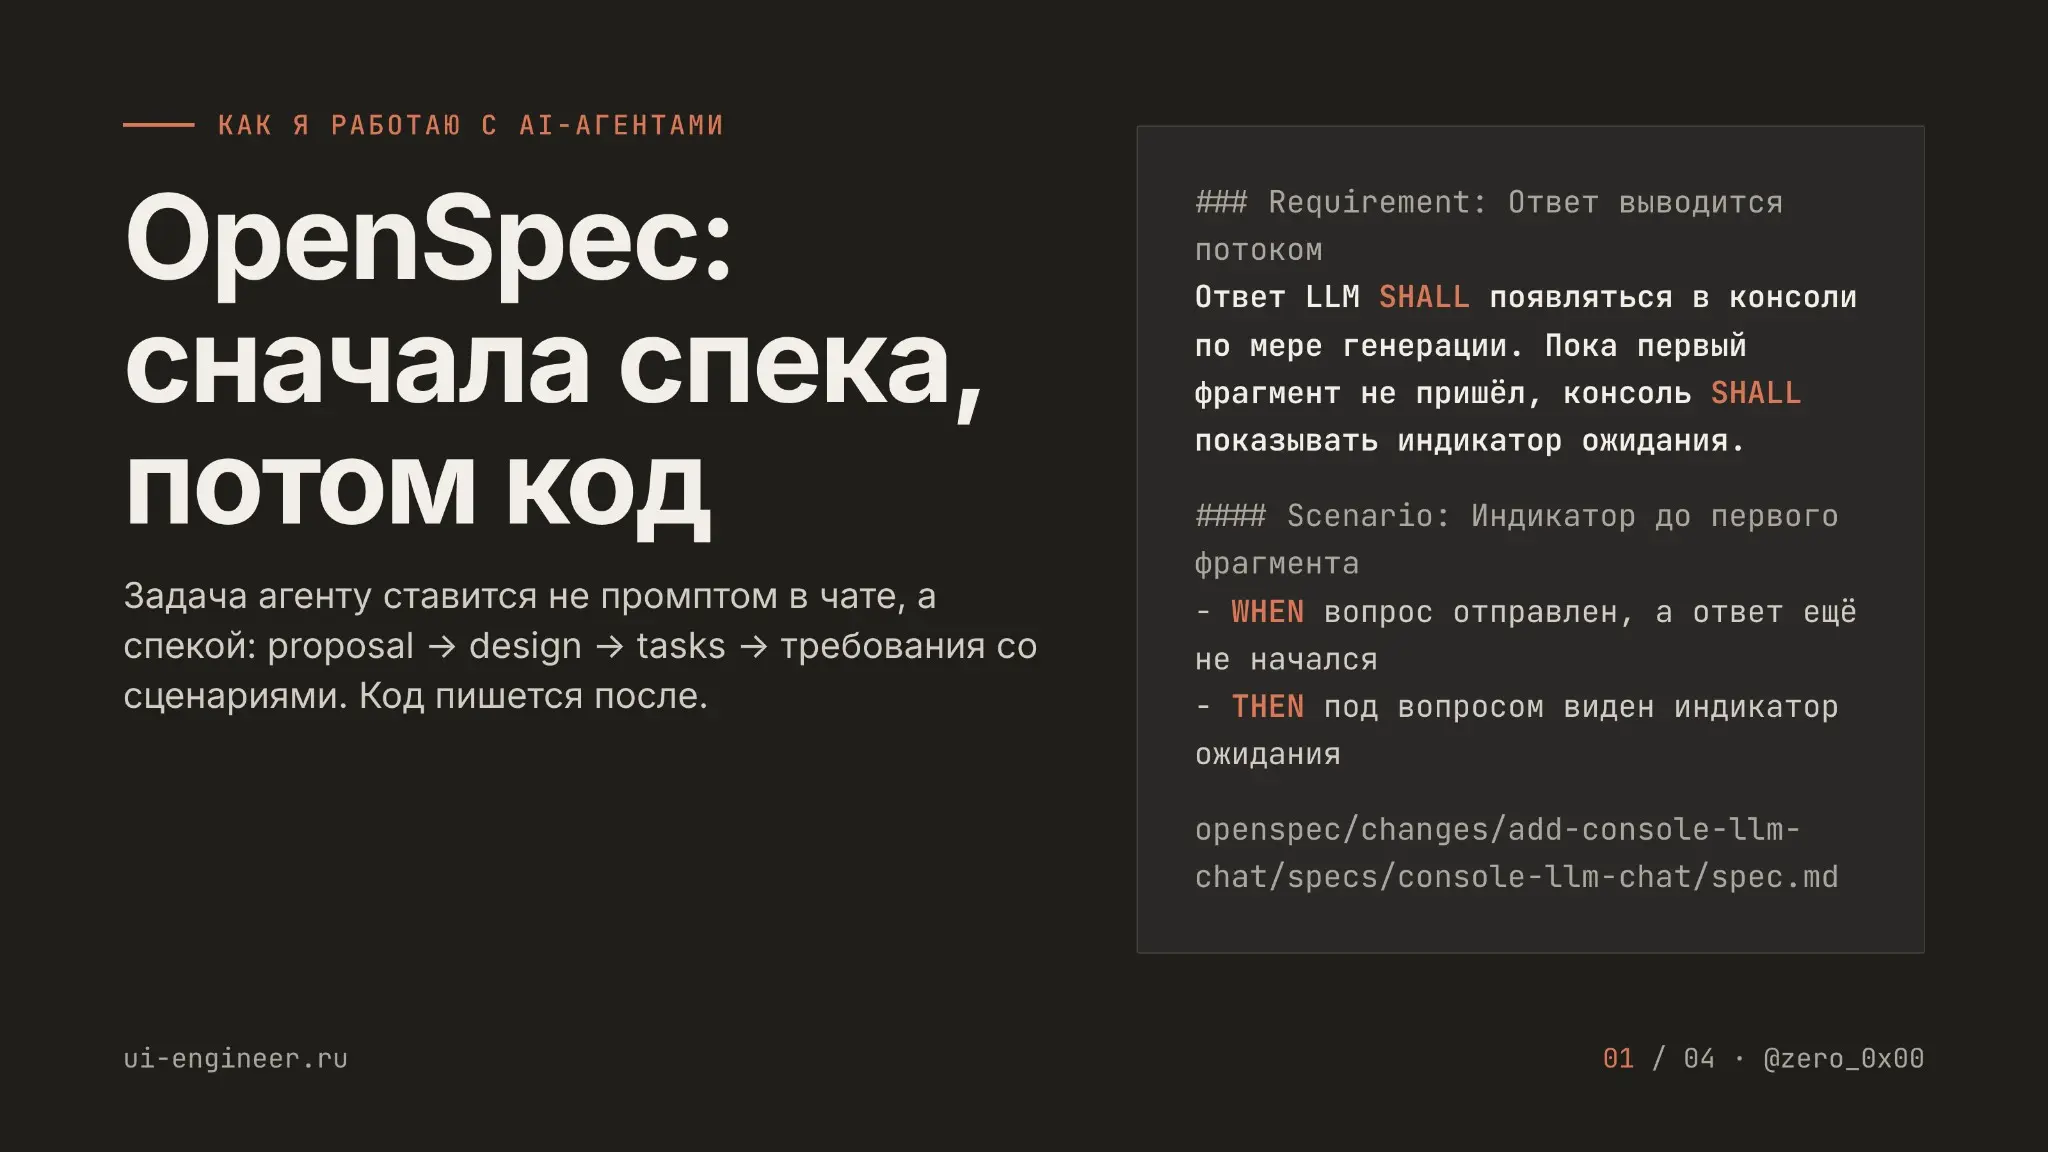
OpenSpec: сначала спека, потом код
Проблема. Агент делает то, что понял из трёх строчек в чате, а не то, что вы имели в виду. Договорённости живут в истории диалога и теряются с новым контекстом. Через месяц никто не помнит, почему сделано именно так. Решение. Использовать OpenSpec: github.com/Fission-AI/OpenSpec.
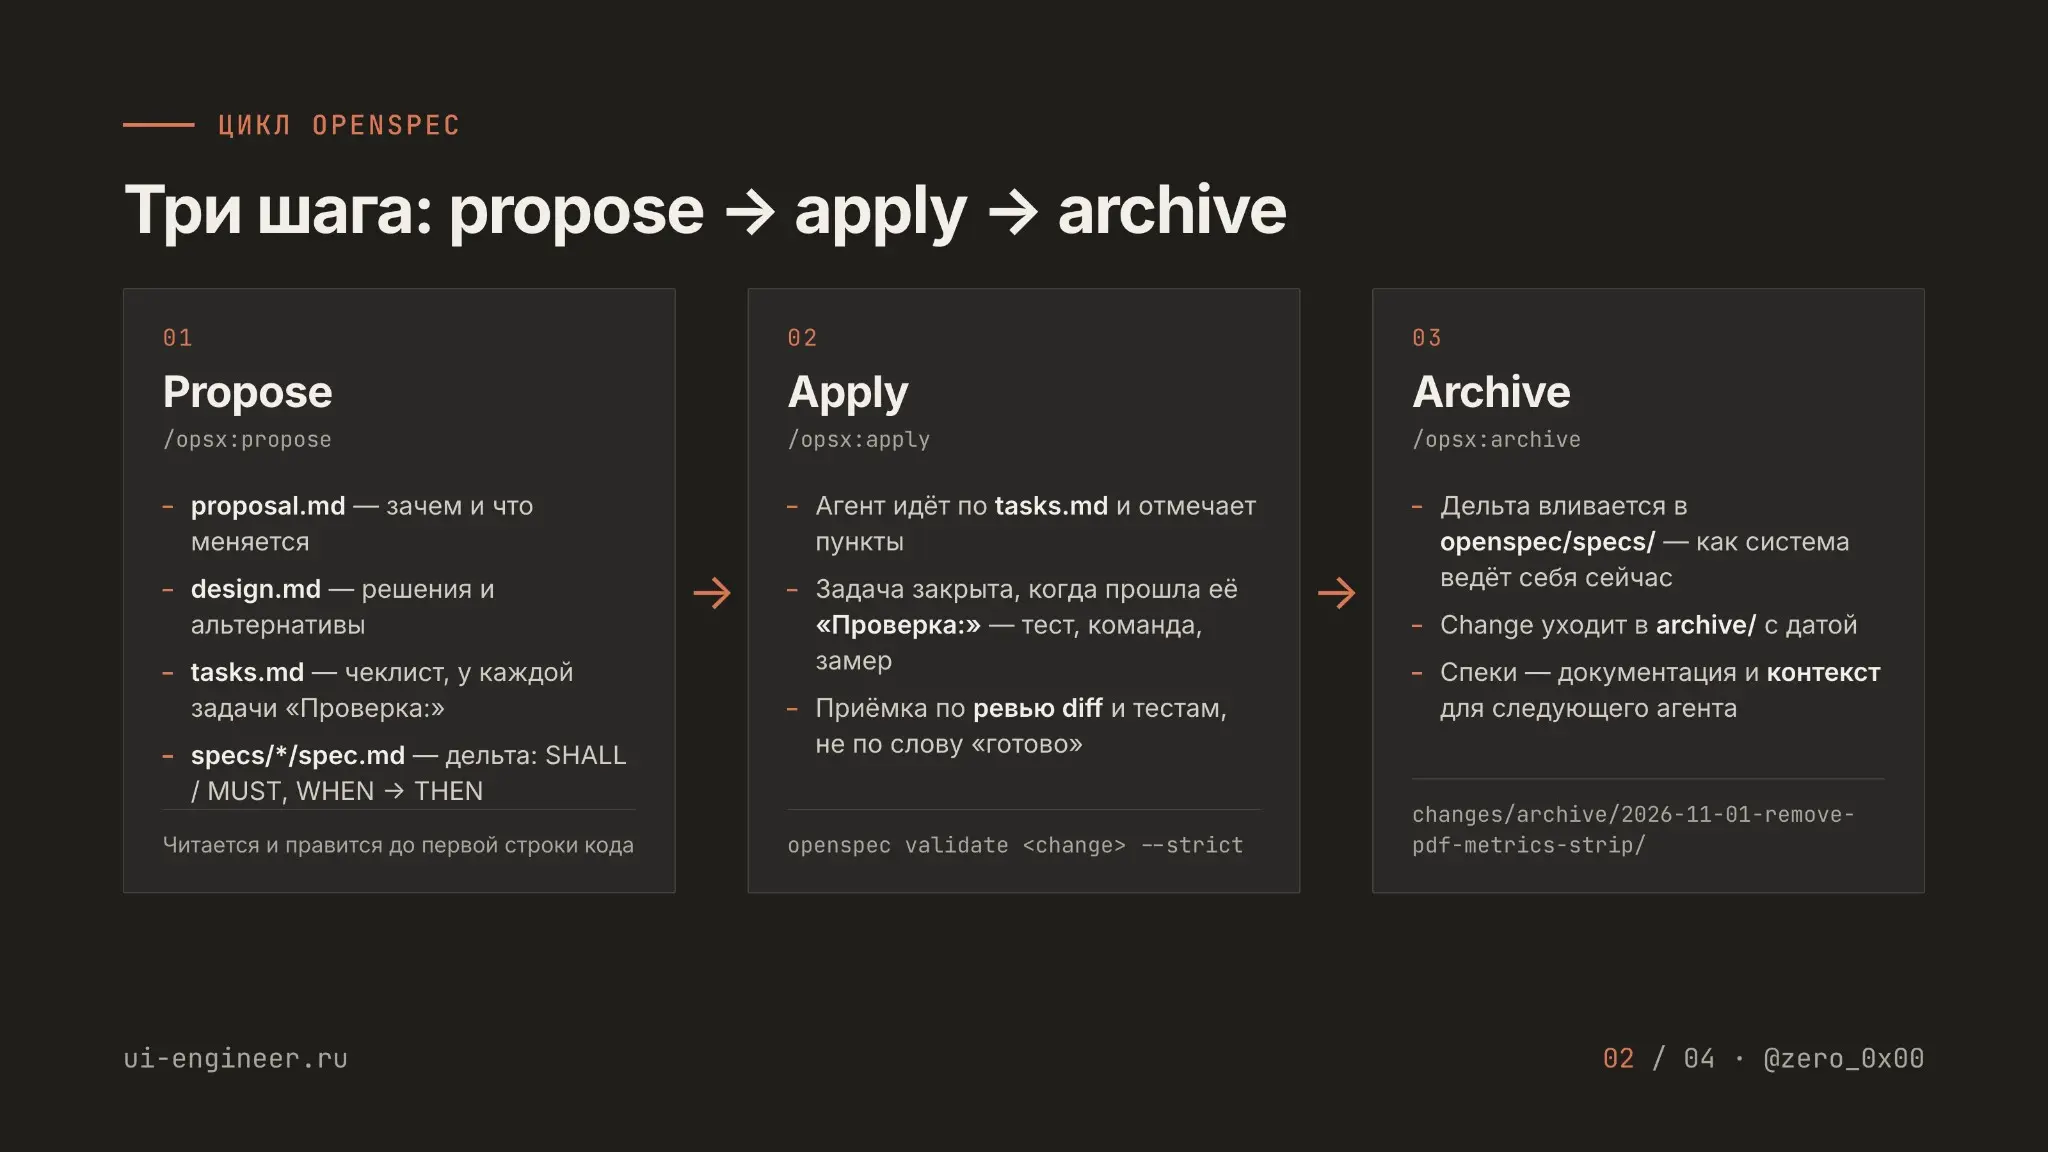
Как устроен цикл
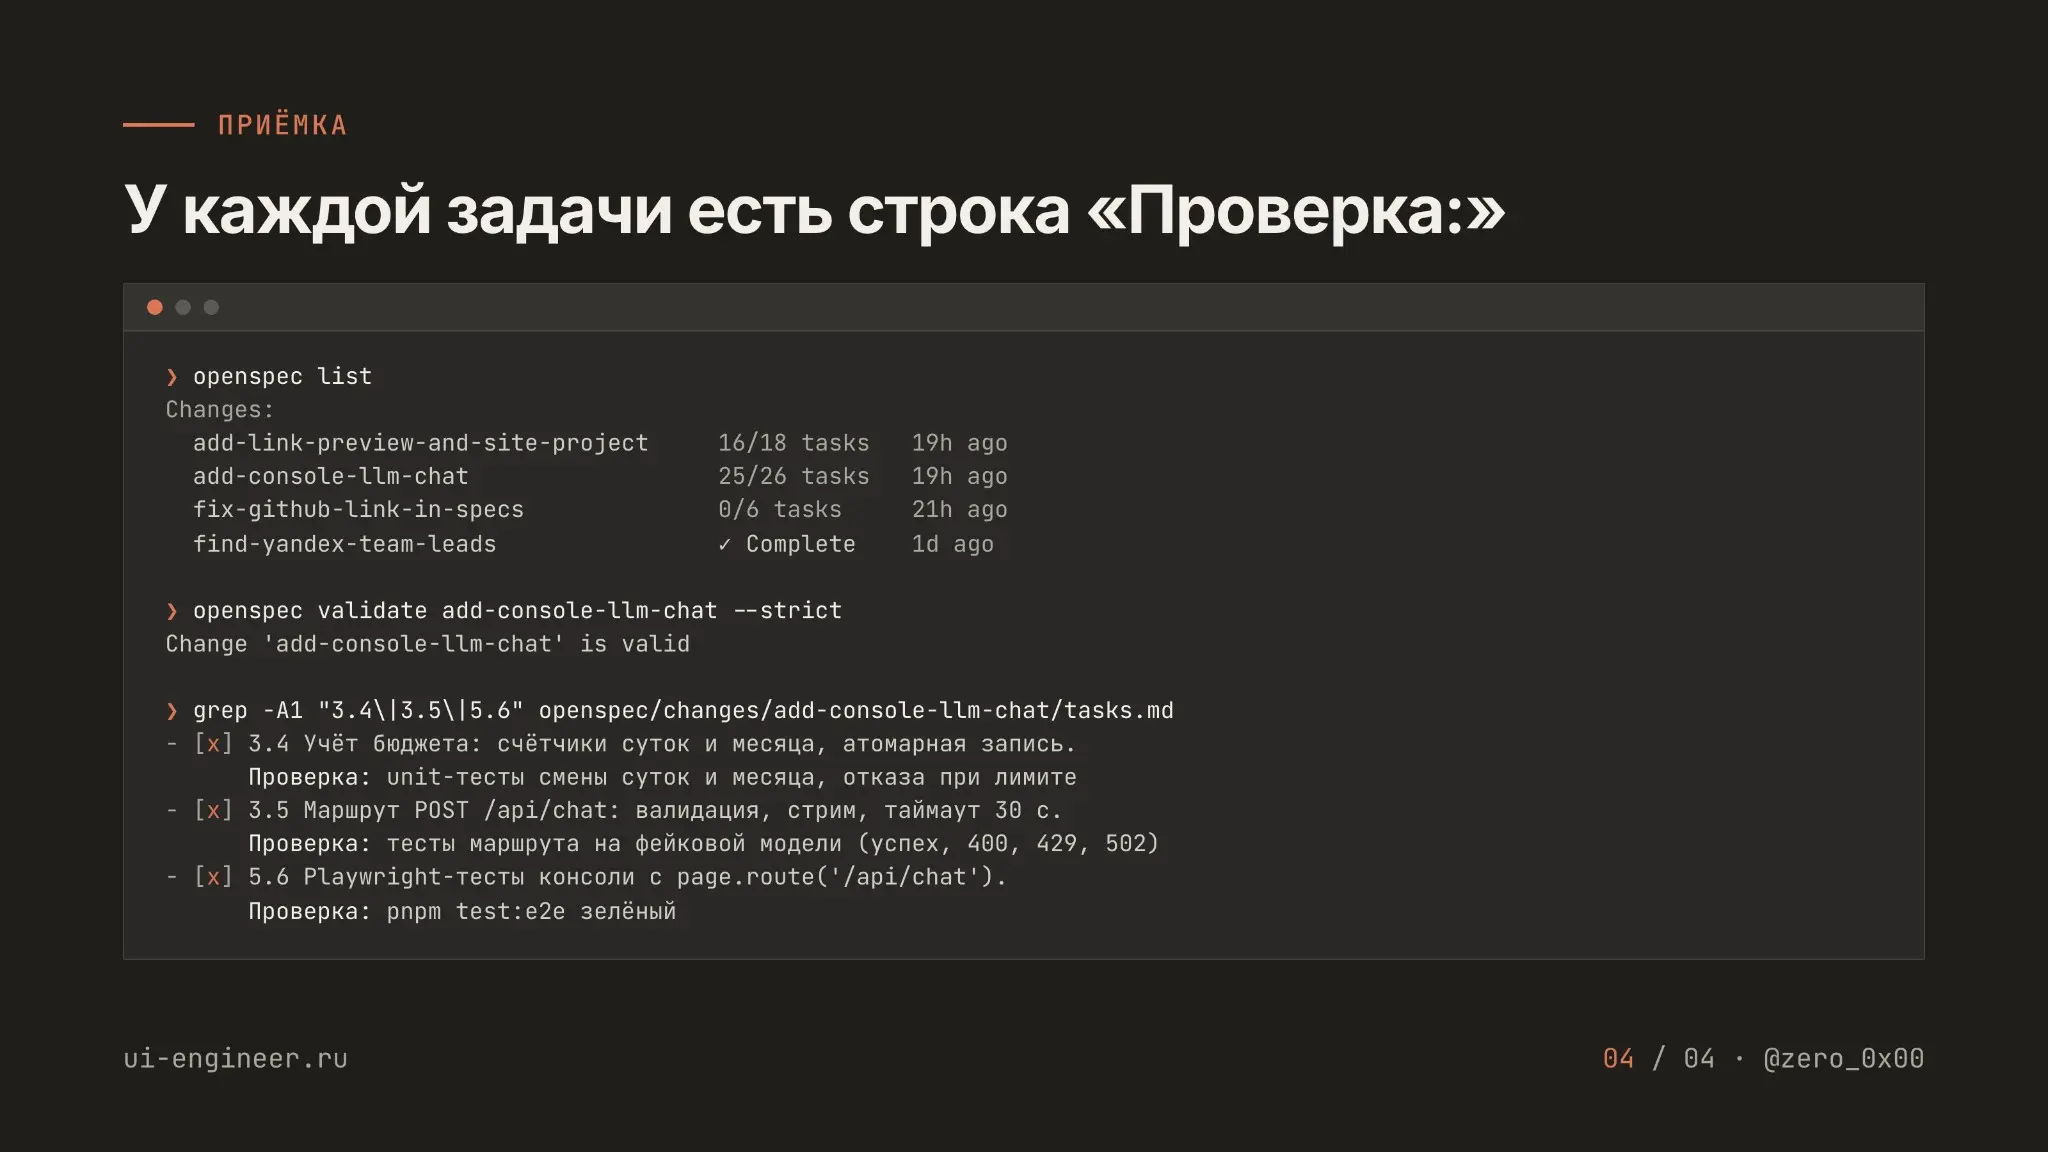
1. Propose. Описываю, что хочу. Агент создаёт change из четырёх артефактов: proposal.md (зачем и что меняется), design.md (технические решения и альтернативы), tasks.md (чеклист) и дельта спеки — требования SHALL / MUST со сценариями WHEN → THEN. Всё это читается и правится до первой строки кода.
2. Apply. Агент идёт по tasks.md и отмечает пункты. У каждой задачи есть строка «Проверка:» — какой тест, команда или замер подтверждает, что она сделана. Принимаю по ревью diff и этим проверкам, а не по слову «готово».
3. Archive. Дельта вливается в основные спеки, change уходит в архив с датой. Папка openspec/specs/ описывает, как система ведёт себя сейчас: это и документация, и контекст для следующего агента.
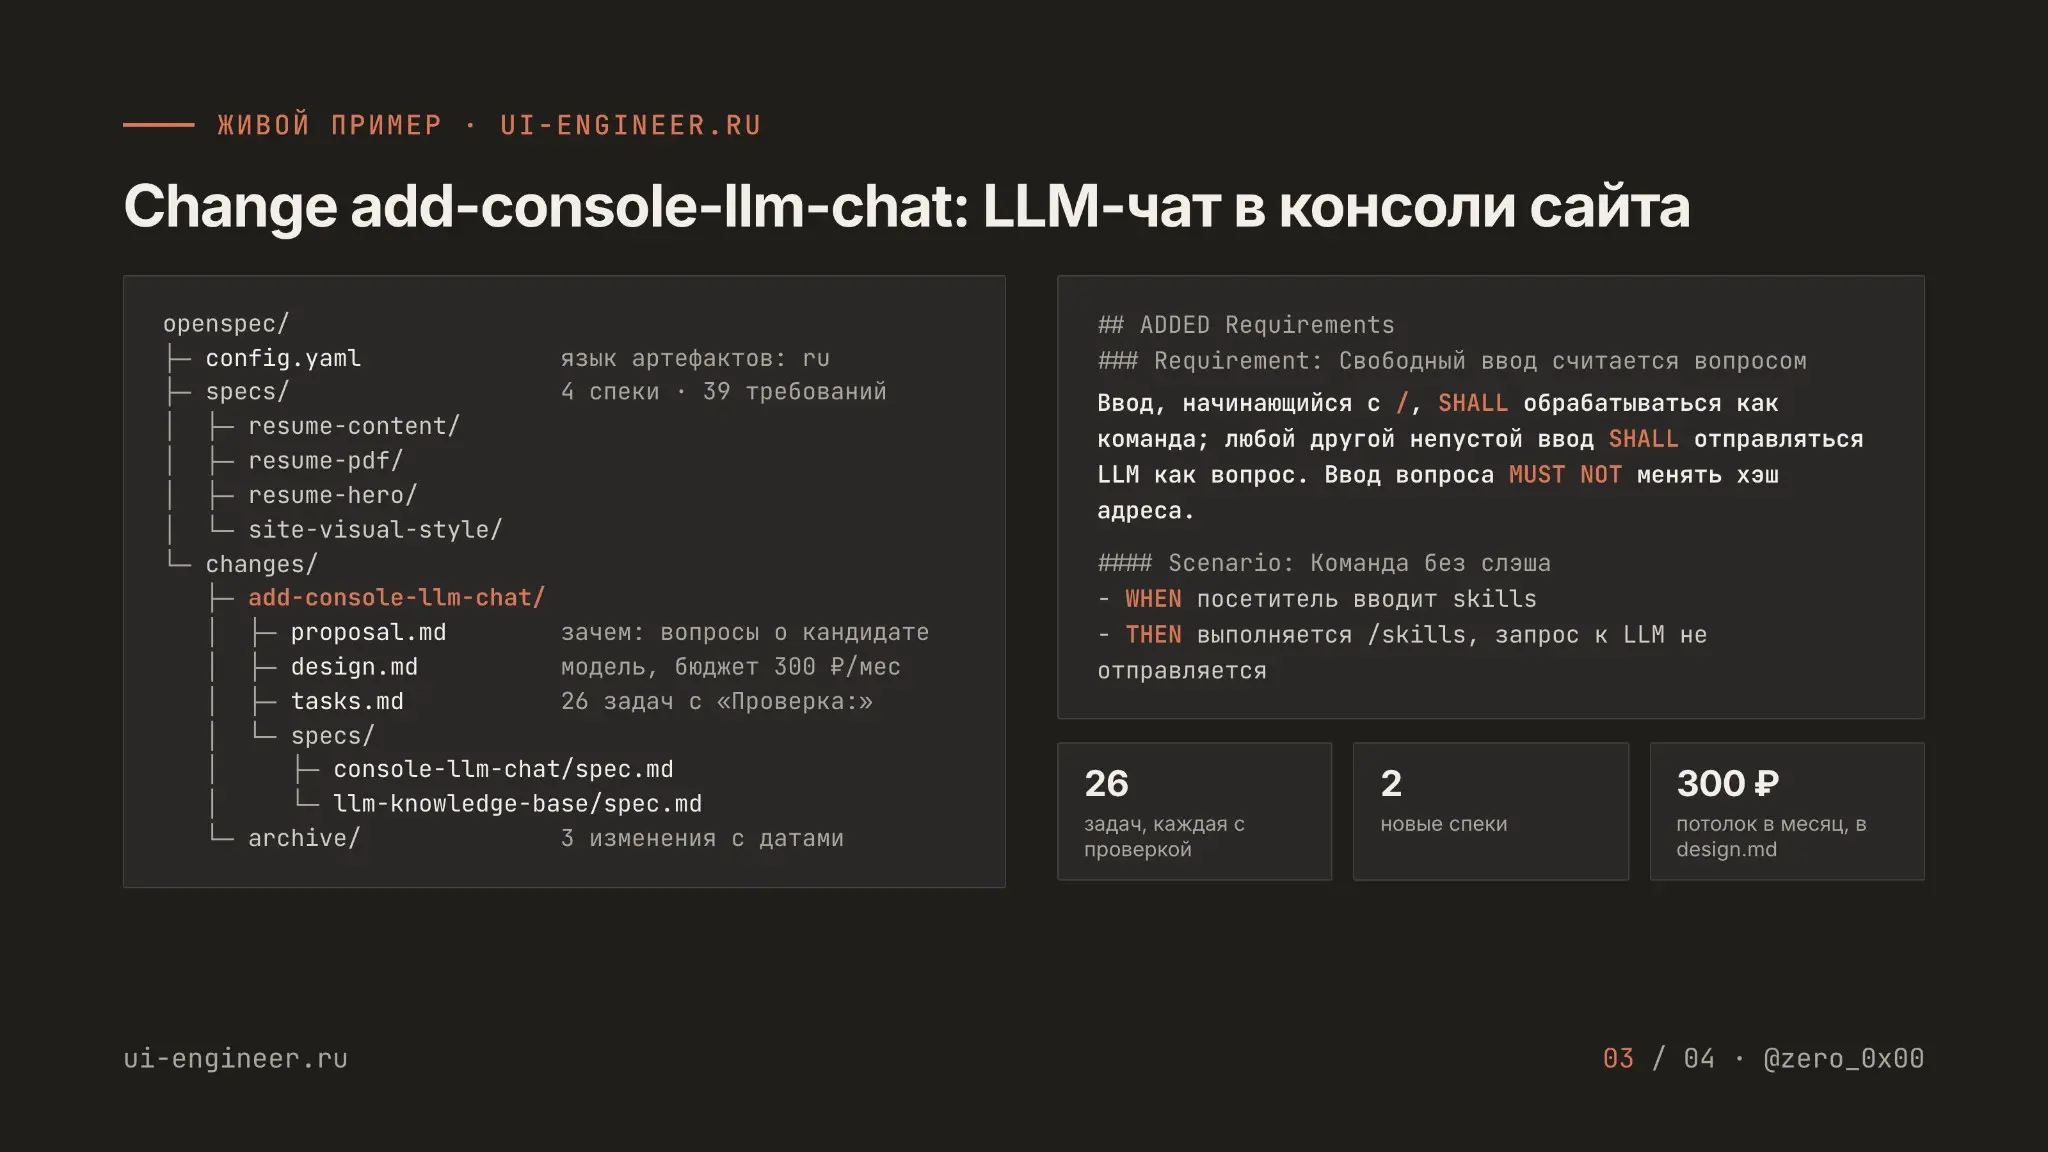
Что это даёт — Спека фиксирует намерение, код — реализацию. Расхождение видно на ревью, а не в проде. — Контекст агента не теряется между сессиями: он читает спеки, а не историю чата. — Правила проекта в одном config.yaml: у меня артефакты на русском, ключевые слова SHALL / MUST — на английском. — Работает не только для кода: последний change в репозитории — навык поиска тимлидов по докладам конференций.
Что не нравится. На мелкие правки цикл избыточен. Граница: если изменение проверяется одним тестом, спека не нужна.
Если работаете с агентами иначе — интересно сравнить.




· 9 ч
Спеки лежат в репозитории рядом с кодом: команда читает их в ревью, а править может любой через обычный PR, это же markdown. Главный эффект в том, что договорённость из чата переезжает в файл и попадает в diff.
Ещё OpenSpec хорошо ложится на задачи из таск-менеджера: задача в трекере, под неё change со спекой и чеклистом. По завершении change архивируется, дельта вливается в основные спеки, и документация по проекту актуализируется сама, а не отдельным «надо обновить вики».
Но у подхода пока есть ограничение: это память одного репозитория. Следующий шаг вижу во внешней памяти между репозиториями внутри компании: соглашения между командами и архитектурные решения, которые читают и люди, и агенты из любого репо. Возможно, в лоб это решается одним монорепозиторием, но думаю, в скором будущем появится внешняя память для спек между репозиториями. У вас в Gramax эту задачу уже кто-то решает?
0
ответить
коммент скрыт — часть юзеров считает его токсичным или некорректным
коммент удалён