109 миллионов против 72 миллиардов: что на самом деле доказал Ян ЛеКун
Ян ЛеКун и Рэндалл Балестриеро опубликовали работу, которая ставит под сомнение главный рецепт последних лет: делать модели всё больше и кормить их всё большим количеством текста.
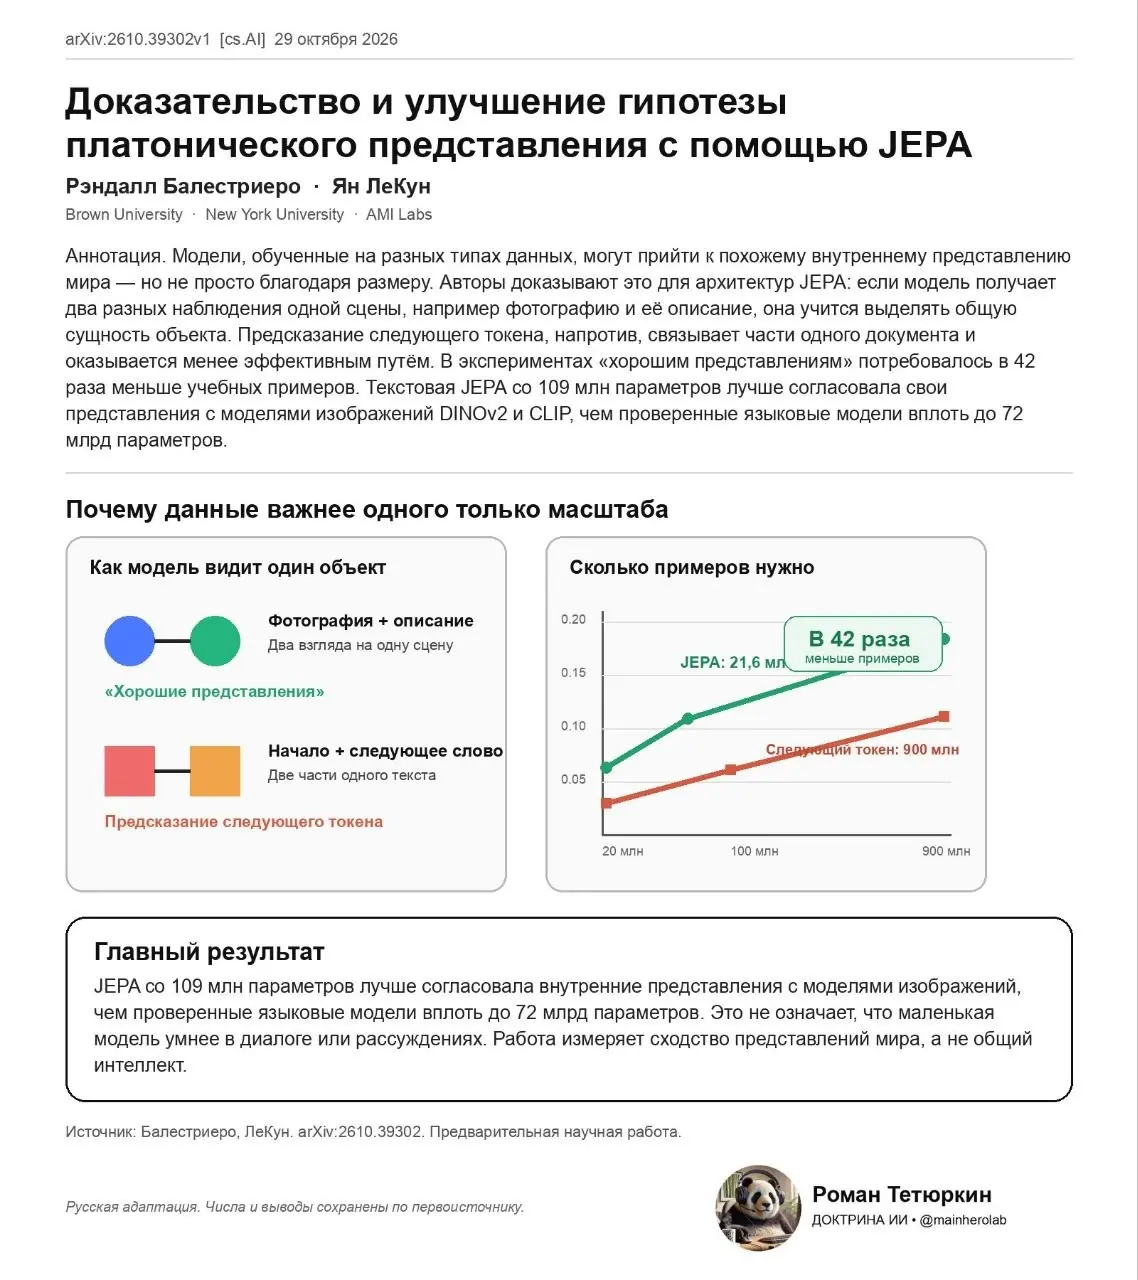
Объяснение на пальцах. Представьте ребёнка, которому показывают фотографию собаки и одновременно говорят: «Это собака». Он получает два разных взгляда на один объект и быстрее понимает, что именно перед ним.
Обычную языковую модель учат иначе. Ей показывают начало текста и просят угадать следующее слово. Она тоже постепенно находит закономерности, но идёт к представлению о мире длинным и дорогим путём.
Авторы проверили это экспериментально. Их архитектуре потребовалось 21,6 млн учебных примеров, чтобы достичь уровня согласования представлений, для которого модели с предсказанием следующего слова понадобилось 900 млн. Разница в 42 раза.
Ещё громче выглядит второе число. Текстовая модель со 109 млн параметров лучше согласовала свои внутренние представления с моделями компьютерного зрения, чем все проверенные языковые модели, включая модель на 72 млрд параметров. Она меньше примерно в 660 раз.
Но заголовок «маленькая модель победила большую» вводит в заблуждение. Исследователи сравнивали не общий интеллект, качество диалога или рассуждений. Они измеряли, насколько похоже разные модели представляют одни и те же объекты. Работа пока опубликована как предварительная научная статья и не прошла независимую проверку.
На рынок это не повлияет завтра. Никто не заменит большие языковые модели версией на 109 млн параметров. Но после подтверждения результатов измениться может направление инвестиций: меньше гонки за размером, больше денег на связанные данные, обучение одновременно на текстах и изображениях, а также новые архитектуры.
Главный вывод: масштаб остаётся полезным, но дорогим. Правильно устроенное обучение может оказаться сильнее грубой вычислительной мощности.
Источник: работа Балестриеро и ЛеКуна, 29 октября 2026 года.