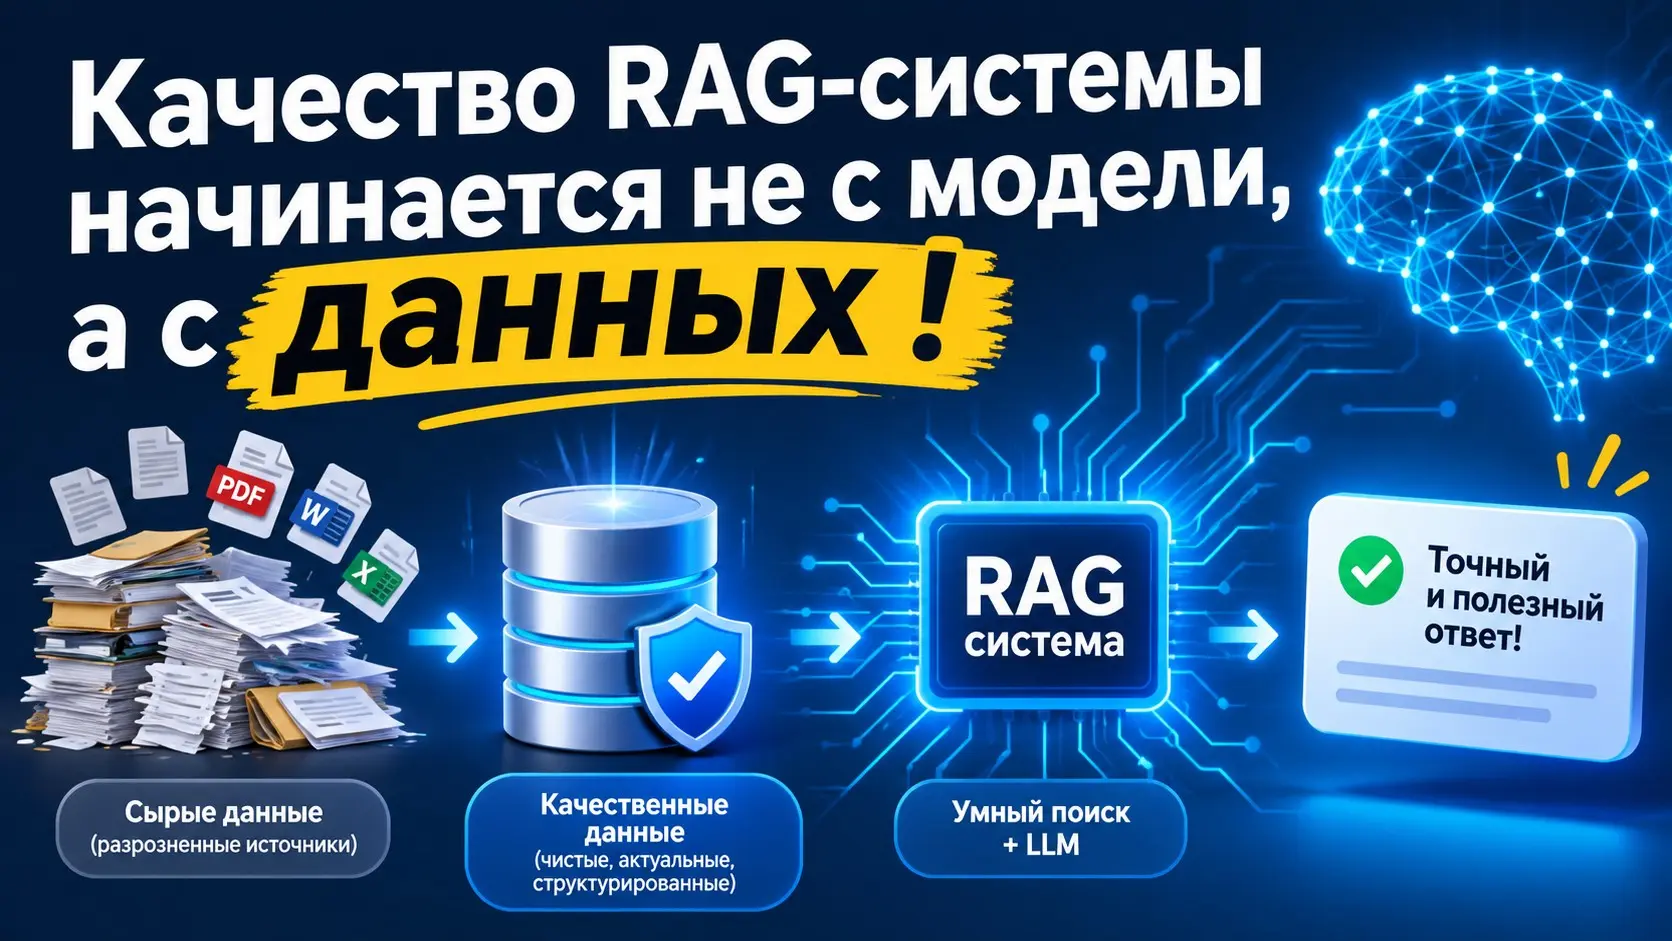
Качество RAG-системы начинается не с модели, а с данных !
Когда обсуждают RAG, часто сразу переходят к выбору модели, векторной базы или фреймворка. Это важные решения, но для меня они не первые. Сначала я хочу понять, что именно лежит в базе знаний. Представим, что мы делаем ассистента для внутренней поддержки. В хранилище есть инструкции, регламенты, шаблоны заявок, письма и заметки из чатов. Формально данных много. Но можно ли на их основе давать надёжные ответы? Не всегда. Одна и та же проблема может быть описана в трёх документах, но инструкции в них устарели или противоречат друг другу. В одном файле — актуальная версия, в другом — черновик без даты. А в переписке — полезный совет, который никто не согласовал как официальную рекомендацию. Если загрузить всё это в векторную базу «как есть», модель начнёт находить похожие фрагменты. Но похожий текст не всегда означает правильный или применимый ответ. Поэтому перед построением поиска я задаю себе несколько вопросов: — Какие документы считаются источником истины? — Кто и как часто их обновляет? — Есть ли у документа версия, статус и дата? — Можно ли отличить официальную инструкцию от черновика или обсуждения? — Какие данные содержат персональную или конфиденциальную информацию? — Что должно быть исключено из поиска полностью? Дальше возникает вопрос структуры. Документ на 80 страниц — это не один «кусок знаний». В нём могут быть разные разделы: общее описание, пошаговая инструкция, ограничения, контакты, частые ошибки. Если разбить его неправильно, поиск может вернуть только часть контекста — и модель сделает вывод на неполных данных. Поэтому мне важно продумать, как разбивать документы, какие метаданные сохранять и как связывать фрагменты с исходным источником. Например, для инструкции важно знать не только текст шага, но и название системы, версию, дату обновления, отдел и статус документа. Эти метаданные помогают не только искать, но и фильтровать результаты. И ещё один момент, который часто недооценивают: доступ. Сотрудник может иметь право читать один раздел базы знаний, но не иметь доступа к другому. Если поиск не учитывает права, ассистент может показать пользователю информацию, к которой у него не должно быть доступа. Даже если сам ответ технически корректный, это уже проблема. Поэтому в моих проектах поиск — это не просто «найти похожий текст». Это найти подходящий фрагмент с учётом прав доступа, актуальности, типа документа и контекста запроса. И только после этого модель формулирует ответ. Мой принцип простой: если в основе лежат шумные, устаревшие или плохо структурированные данные, то ни одна модель не превратит их в надёжную систему. Хорошая RAG-система — это в первую очередь работа с знаниями: их отбором, структурой, актуальностью и доступом. А модель и векторное хранилище — инструменты, которые помогают этим знаниями пользоваться. Коллеги, как вы сейчас решаете вопрос с версиями и актуальностью документов в своих базах знаний?