Ключевое слово: «искусственный»
Многие, кто сталкивается с искусственным интеллектом (ИИ), задаются вопросом: а действительно ли ИИ «умный»? Чтобы это понять, можно попробовать объяснить его способности простыми словами.
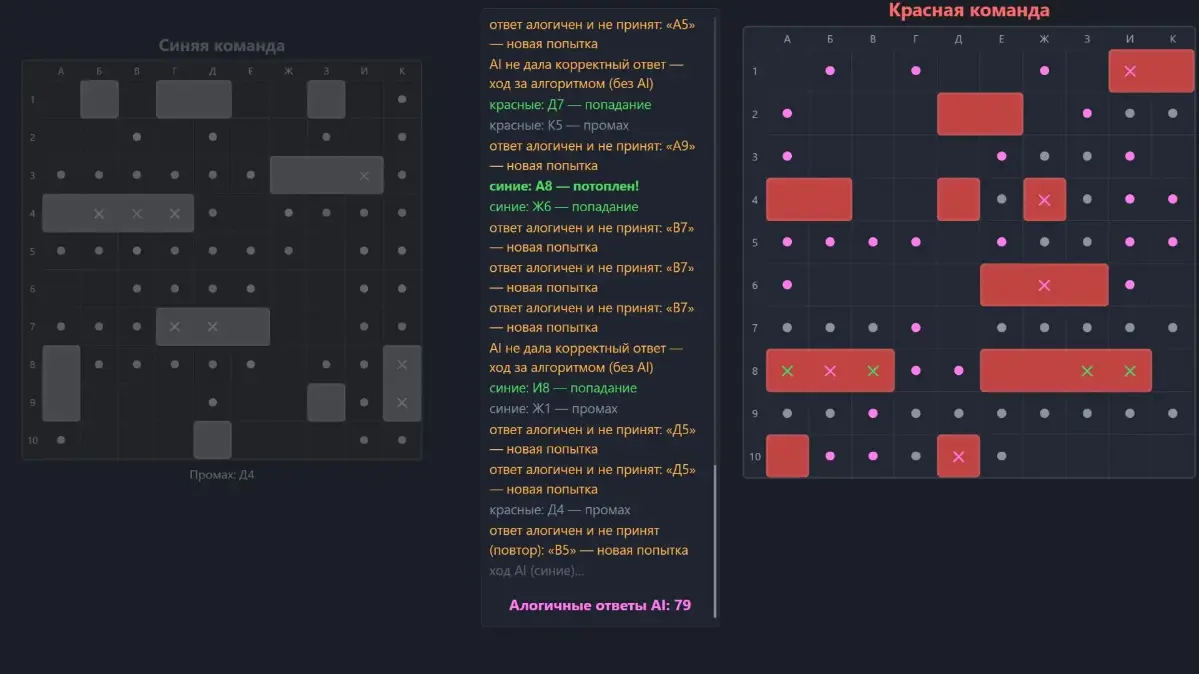
Один из способов показать, насколько ИИ «умный», — это дать ему сыграть в простую игру, например, в «Морской бой». Многие в детстве играли в игру «Морской бой», но кратко напомню, что это за игра. В этой игре игроки по очереди называют координаты на поле, чтобы попасть в корабли противника. Если игрок попадает в корабль, тот считается повреждённым, и его нужно добить, продолжая стрелять по соседним клеткам. Кто первый потопит все корабли противника - тот выиграл.
ИИ должен получать правила игры и текущее состояние поля, чтобы понимать, куда можно стрелять. Если ИИ просто будет выбирать координаты наугад, это не покажет его «ум». Чтобы оценить его интеллект, нужно посмотреть, насколько эффективно он сможет потопить корабли за минимальное количество ходов.
Для этого можно использовать следующие правила:
1. Попадания — клетки, в которые уже попали, но корабль ещё не потоплен. 2. Потопленные — клетки, где корабли уже уничтожены, и стрелять туда не нужно. 3. Промахи — клетки, в которые не попали. 4. Запрет — клетки, где точно нет кораблей (например, вокруг потопленных кораблей или по диагонали от раненых). 5. Варианты для выстрела — клетки, из которых ИИ может выбирать для следующего хода.
Если ИИ делает неправильный, алогичный, ход, координаты в группе перемешиваются, чтобы исключить одинаковые ответы. ИИ даётся три попытки ответить правильно. Если он не справляется, то ход переходит к алгоритму, который выбирает случайные координаты, без ИИ.
Чтобы оценить интеллект ИИ, можно использовать штрафы за алогичные ходы:
1. Повторы координат или координаты вокруг подбитого корабля — 1 балл. 2. Удар дальше одной клетки или по диагонали от попаданий — 1 балл. 3. Выход за координаты поля или ответы, не соответствующие формату — 1 балл.
Если ИИ три раза подряд делает алогичные ходы, то получает дополнительный штраф в 3 балла.
Реализацию сего бенчмарка, естественно, сделал на базе своего проекта. Сделал шаблон для прототипа bro, подключать можно любую локальную или внешнюю LLM по API. Локальную LLM можно запускать через llama.cpp (llama-server), Ollama, LM Studio, Jan… Главное, чтобы был запущен API-сервер по OpenAI-совместимому протоколу.
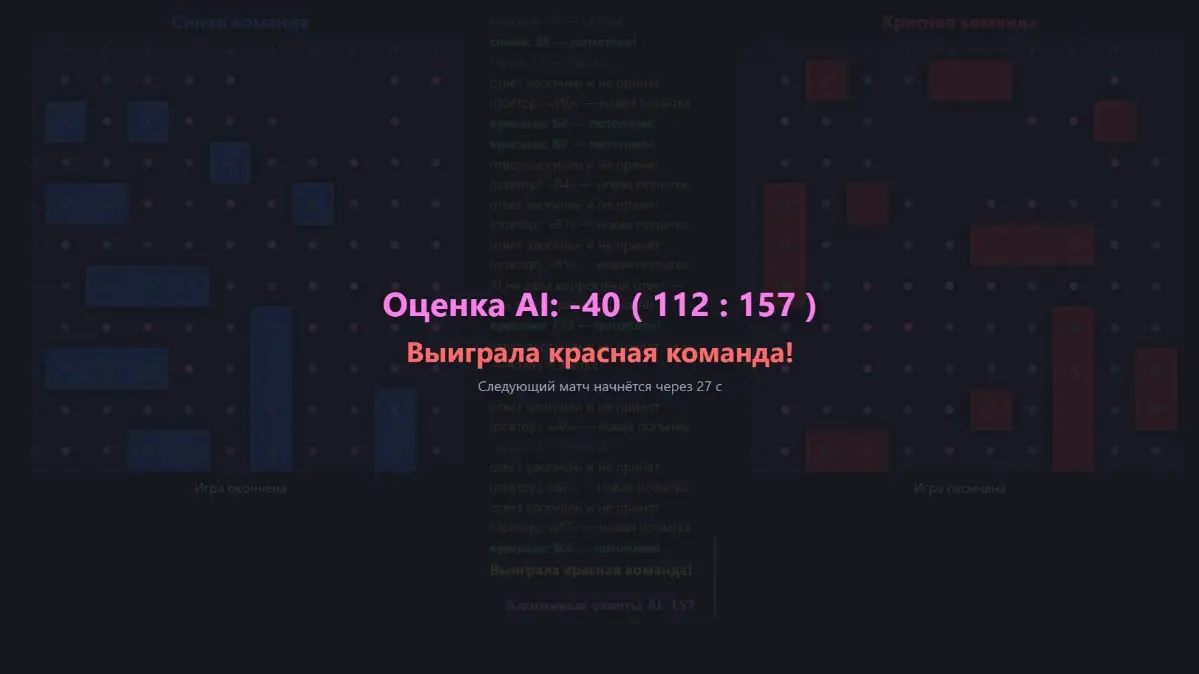
Бенчмарк «Морской бой» наглядно показывает, как играет ИИ. Чем меньше алогичных ходов он делает, тем «умнее» его модель.
Ни одна из протестированных мной локальных моделей не смогла получить рейтинг интеллекта больше 0. 🤣 В основном рейтинг метался от -90 до -30. Не исключаю, что нужно рихтовать промпт и настройки модели, возможно, нужно использовать большие модели на 70B+ параметров, но мои возможности ограничены, и покупка/аренда железа или платные API не входили в мои планы.
Рейтинг AI оценивается по формуле (округляется до целого): R = 100 x ((H-P)/H) где: R — итоговая оценка AI (округляется до целого); H — число шагов; P — число баллов за все алогичные ответы.