Память агента между сессиями: что хранить, а что нет
Каждая новая сессия AI-агента — чистый лист. Договорённости из прошлого чата, грабли, на которые уже наступали, предпочтения — всё теряется. В Claude Code это решается файловой памятью проекта.
Как устроено — Каталог памяти проекта: индекс MEMORY.md плюс файл на каждый факт. — Индекс — одна строка на факт: название, ссылка на файл, короткий хук. Он грузится в контекст каждой сессии, поэтому короткий: у меня 9 строк на 9 файлов. — Файл факта — фронтматтер (name, description, type) и тело. Type один из четырёх: user (кто я и что предпочитаю), feedback (как работать, с «почему»), project (что не выводится из кода и git), reference (ссылки, эндпоинты, где что редактируется). — Агент читает файл только когда description совпал с задачей. Индекс — оглавление, не содержимое.
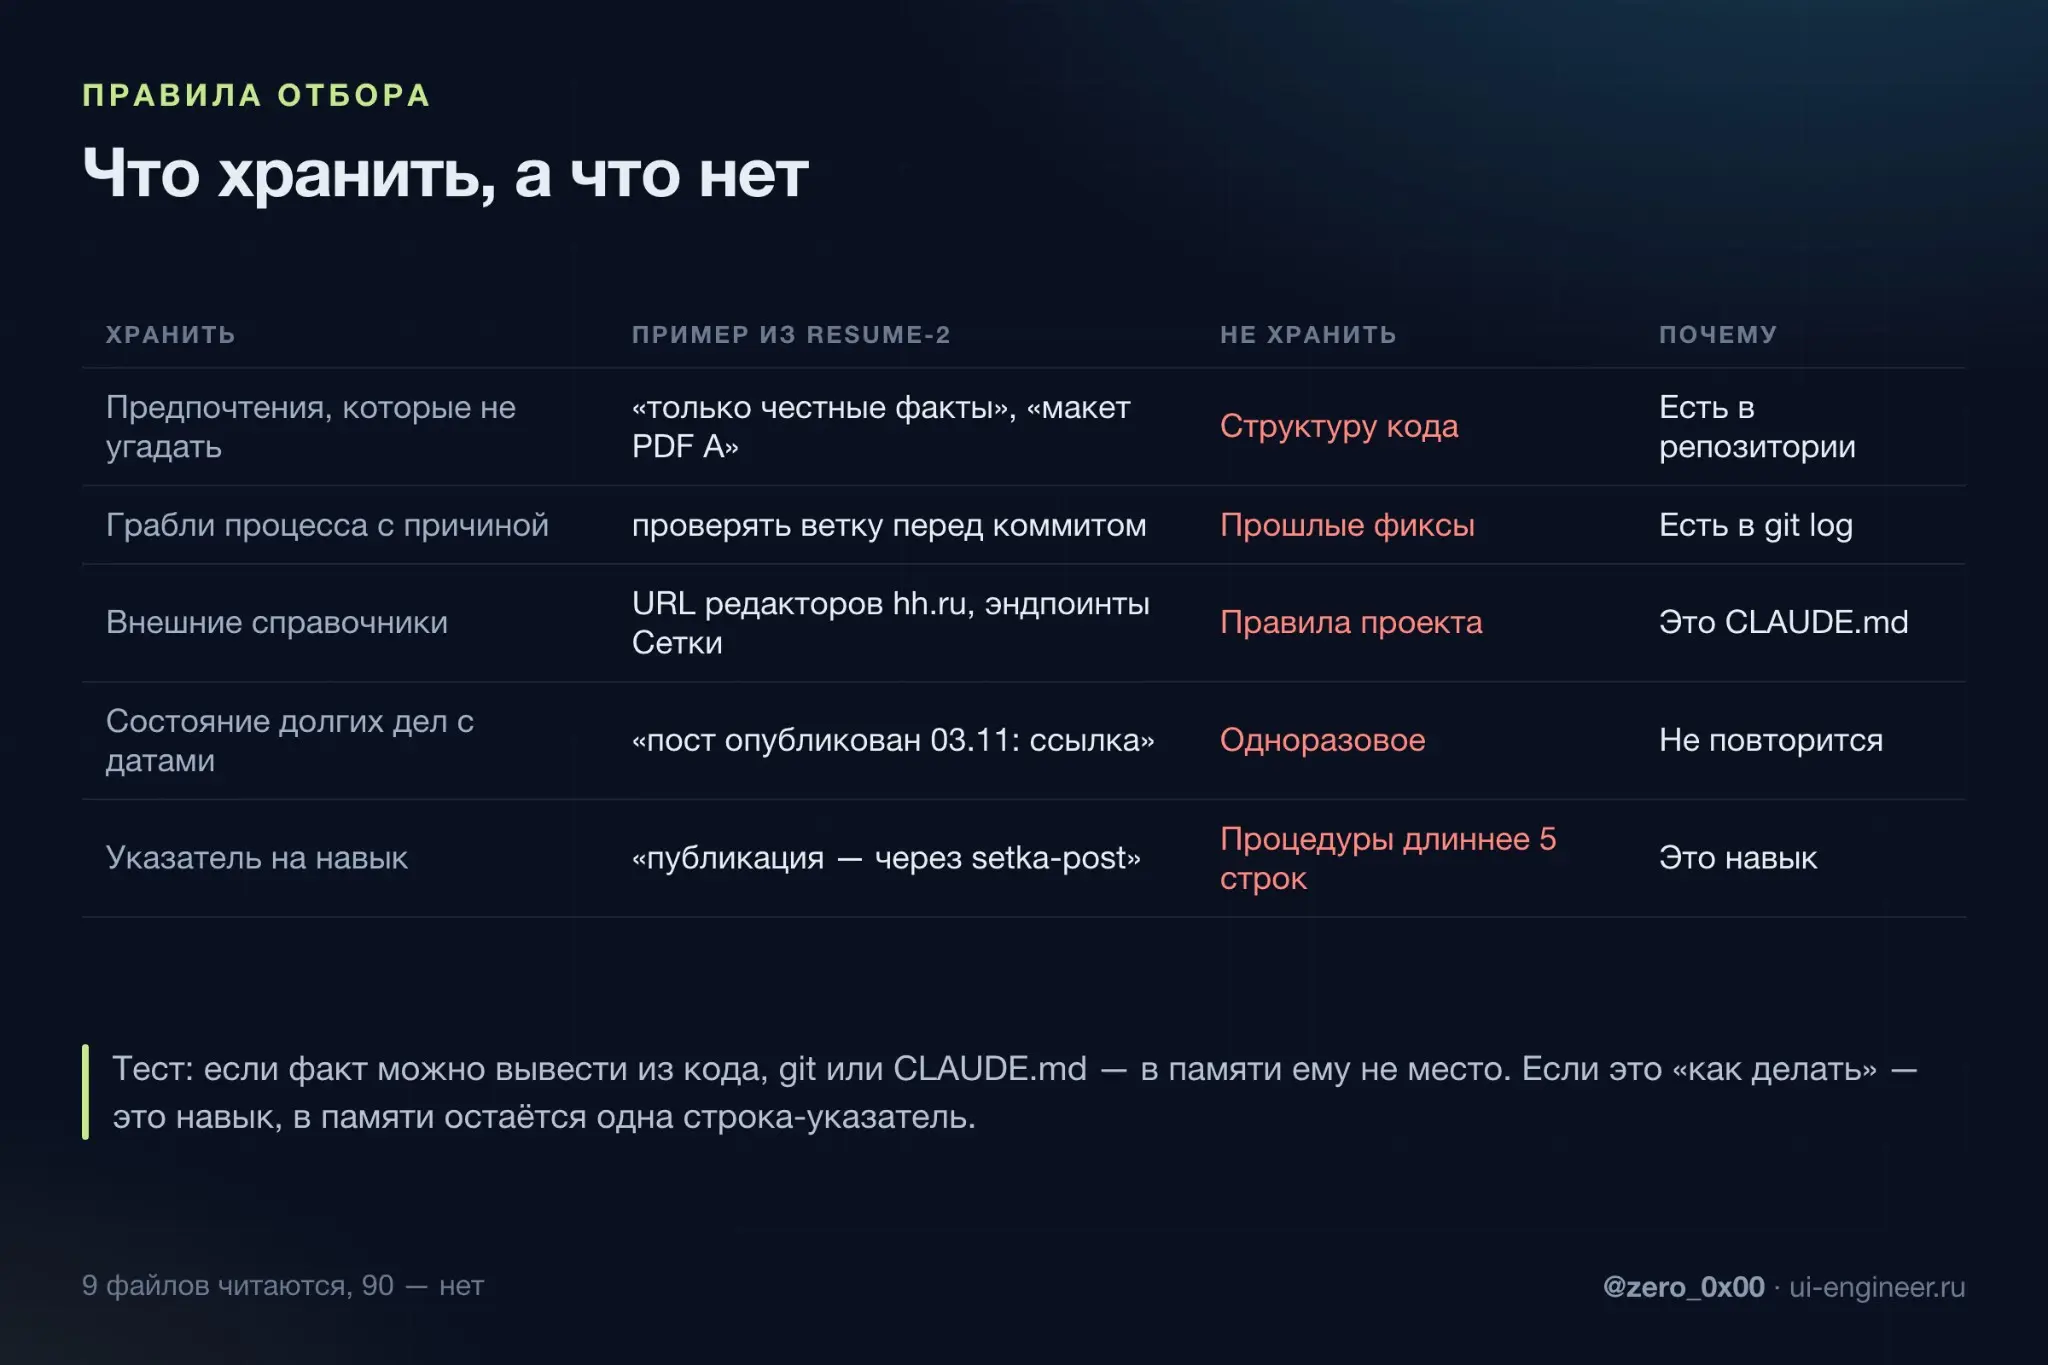
Что хранить — Предпочтения, которые не угадать: «в резюме только честные факты», «макет PDF — вариант A». — Проблемы процесса с причиной: «в этой папке несколько сессий переключают ветки — перед коммитом проверяй ветку». — Внешние справочники: например swagger. — Состояние долгих дел с датами.
Что не хранить — То, что есть в коде, git или CLAUDE.md. Дубликат устареет первым. — Одноразовое: «в этот раз файл назывался так». — Процедуры длиннее пяти строк: это навык, а не факт. Память хранит указатель на навык.
Где память подводит — Устаревает молча. В файле есть дата изменения, и перед тем как опираться на факт о файле или настройке, стоит проверить, что они ещё существуют. — Соблазн записать всё. Девять файлов читаются, девяносто — нет. — Личные данные. В память попадают ссылки на профили и контакты, поэтому она живёт вне репозитория.
Как вы передаёте контекст агенту между сессиями — файлы, спеки, длинный системный промпт?