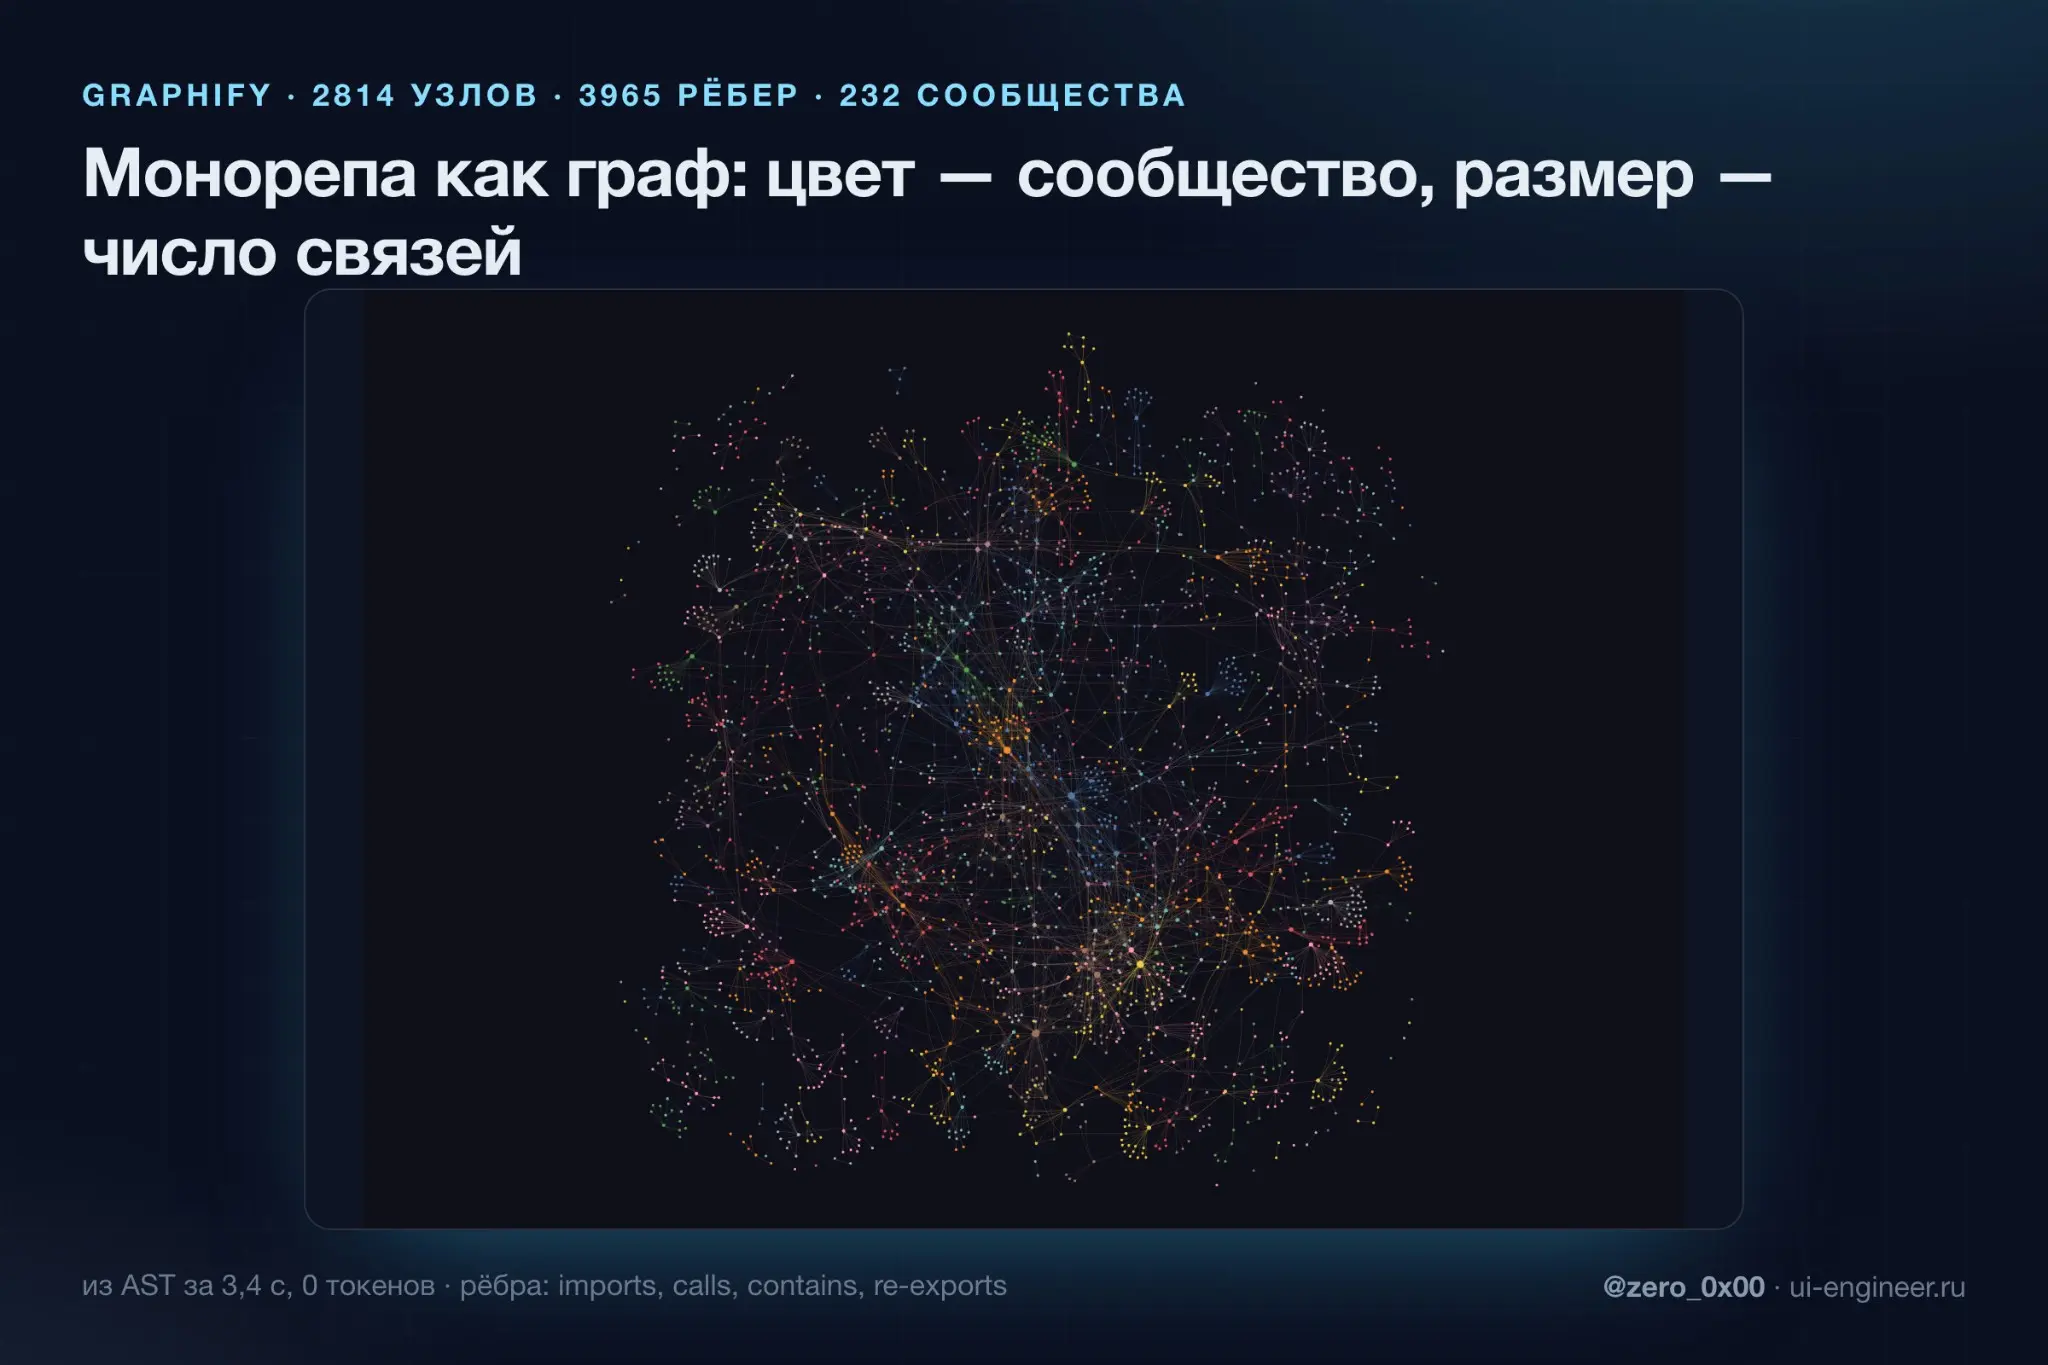
graphify: граф знаний по монорепе без LLM за минуту
Проблема. Агент заходит в большую монорепу и начинает цикл: grep, открыть файл, ещё grep, ещё файл. Каждый открытый файл — тысячи токенов контекста. Ответ на вопрос «кто вызывает эту функцию» собирается из пяти-шести файлов, и после десятка таких вопросов контекст забит кодом, который был нужен один раз. Новому человеку в команде так же: README устарел, а «с чего начать» никто не написал.
Что пробовал и смотрел — grep или ripgrep плюс чтение: бесплатно, но за каждый файл платишь контекстом, а связи между файлами держишь в голове. — Repomix и gitingest: упаковать репозиторий в один файл. На монорепе в полмегабайта кода это около 150 тысяч токенов на один вопрос. — madge и dependency-cruiser: граф импортов, но только импорты и только модули — ни вызовов, ни «центров тяжести». — «Find references» в IDE через LSP: точно, но один символ за раз и не из CLI, куда ходит агент. — Repo map в Aider: компактная карта на tree-sitter, но живёт внутри одного инструмента и не переносится.
Почему graphify — Строит граф из AST локально: узлы — файлы и символы, рёбра — contains, imports, calls, re-exports. На построение кода LLM не нужен, ноль токенов. — Сверху — community detection и god nodes: самые связанные узлы и есть карта проекта, с них начинают онбординг и ревью. — Каждое ребро помечено: EXTRACTED из AST или INFERRED с уверенностью. Граф говорит, что знает, а что предположил. — CLI: query по вопросу, path между двумя символами, explain по узлу с номерами строк. Есть режим MCP — агент ходит в граф как в инструмент, и wiki — статья на сообщество для агентов, которые умеют только читать markdown. — Инкрементальное обновление, граф лежит в папке и переживает сессии.
Цифры на моей монорепе (около 190 файлов кода, 590 КБ, токены считаю как 4 символа) — Полное обновление графа: 3,4 секунды, 0 токенов. Итог: 2814 узлов, 3965 рёбер, 232 сообщества. — Вопрос «с чего начать»: отчёт с хабами и сообществами — 47 КБ против 590 КБ кода, в 12 раз меньше, а нужная часть — первые два экрана. — Вопрос «кто вызывает функцию»: explain выдаёт 411 символов, около 100 токенов. Без графа — grep и чтение трёх файлов, 5,4 КБ, около 1400 токенов. В 13 раз меньше. Путь между двумя символами — одна строка в 85 символов. — Оговорка: широкий query с обходом в глубину выдал 14,6 КБ — больше, чем сами файлы. Граф экономит на точечных вопросах; «расскажи всё про модуль» дешевле задать файлам.
Где споткнулся — Имена сообществам даёт LLM. Без ключа сообщества называются по файлу-хабу — читаемо, но не всегда осмысленно. — Документы и картинки в репозитории тоже требуют ключ; без него индексируется только код. — Динамические связи — Module Federation, динамический import по строке — AST не видит. Граф статический, и об этом стоит помнить. — В граф попадают папки с бенчмарками и worktree, и чужой package.json становится хабом. Нужны исключения, иначе мусор искажает god nodes.
Чем вы помогаете агенту ориентироваться в большой кодовой базе — графы, wiki, просто карта папок в CLAUDE.md?