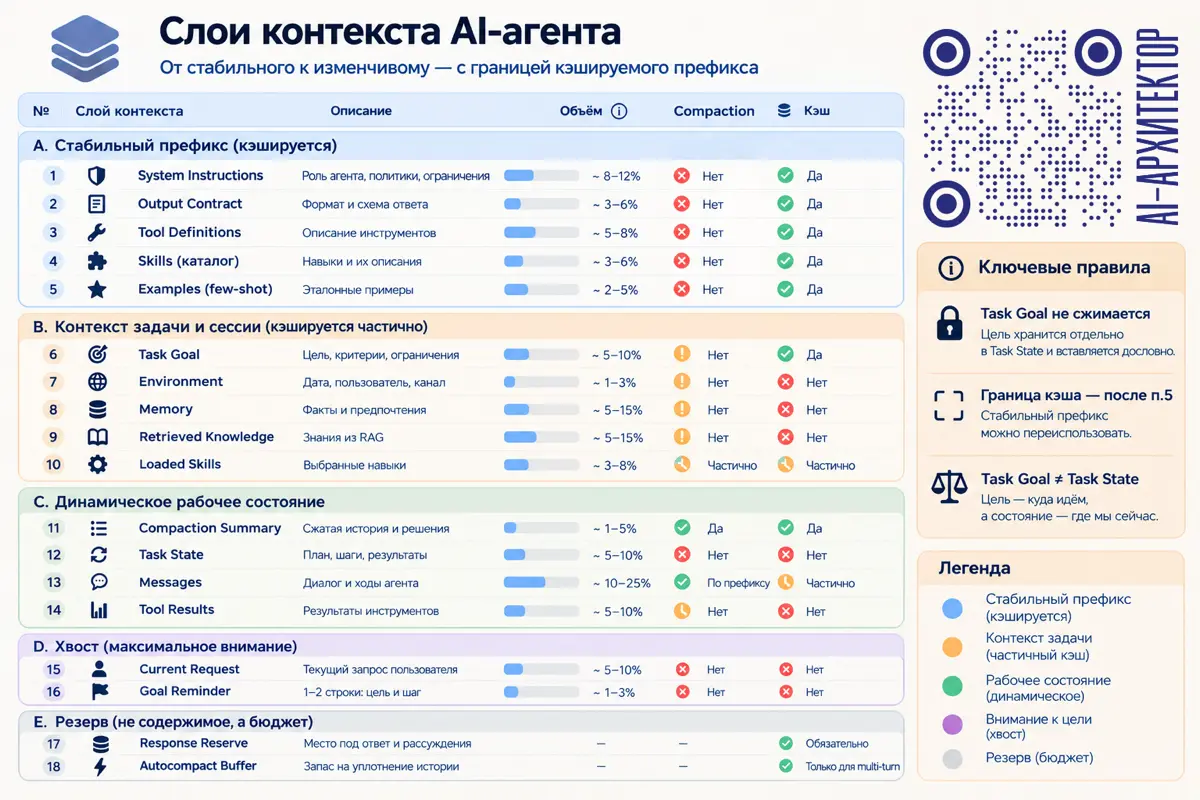
Как устроен контекст AI-агента
Контекст — это минимальный достаточный набор высокосигнальной информации для текущего шага запроса к инференсу.
Архитектурная задача правильно собрать, распределить и контролировать информацию.
Именно разделение этих сущностей позволяет строить устойчивых AI-агентов, работающих с длинными задачами и большими объёмами информации.
1. Из чего состоит контекст? Для каждого вызова LLM Context Assembly формирует рабочий набор данных из нескольких логических слоёв.
System Instructions — системные инструкции, роль агента, ограничения и политики.
Task Goal — цель текущей задачи, критерии результата и ограничения пользователя.
Messages — история диалога, предыдущие запросы и ответы.
Task State — рабочее состояние: выполненные шаги, промежуточные результаты, ошибки и следующие действия. Task Goal никогда не входит в сжимаемую часть
Memory — извлечённые из долговременного хранилища факты, предпочтения, решения и знания.
Skills — инструкции и процедуры выполнения конкретных задач.
Tool Definitions — описания доступных инструментов, MCP-серверов, функций и их параметров.
Tool Results — результаты вызовов инструментов: поиск, вычисления, обращения к API и другие данные.
Compaction Summary — сжатое представление предыдущей истории. Используется в длительных сессиях, когда исходная история становится слишком большой.
Короткое напоминание цели В длинных сессиях модель «забывает» исходную цель. Появлеться goal drift: агент уходит в подзадачи или повторяет действия. Краткое повторение рядом с местом генерации удерживает фокус.
2. Цикл goal-based агента Task Goal отвечает на вопрос, куда идём, а Task State - на вопрос, где мы сейчас. Validator - сверяет их на каждом шаге: соответствует ли следующее действие цели и выполнены ли критерии готовности.