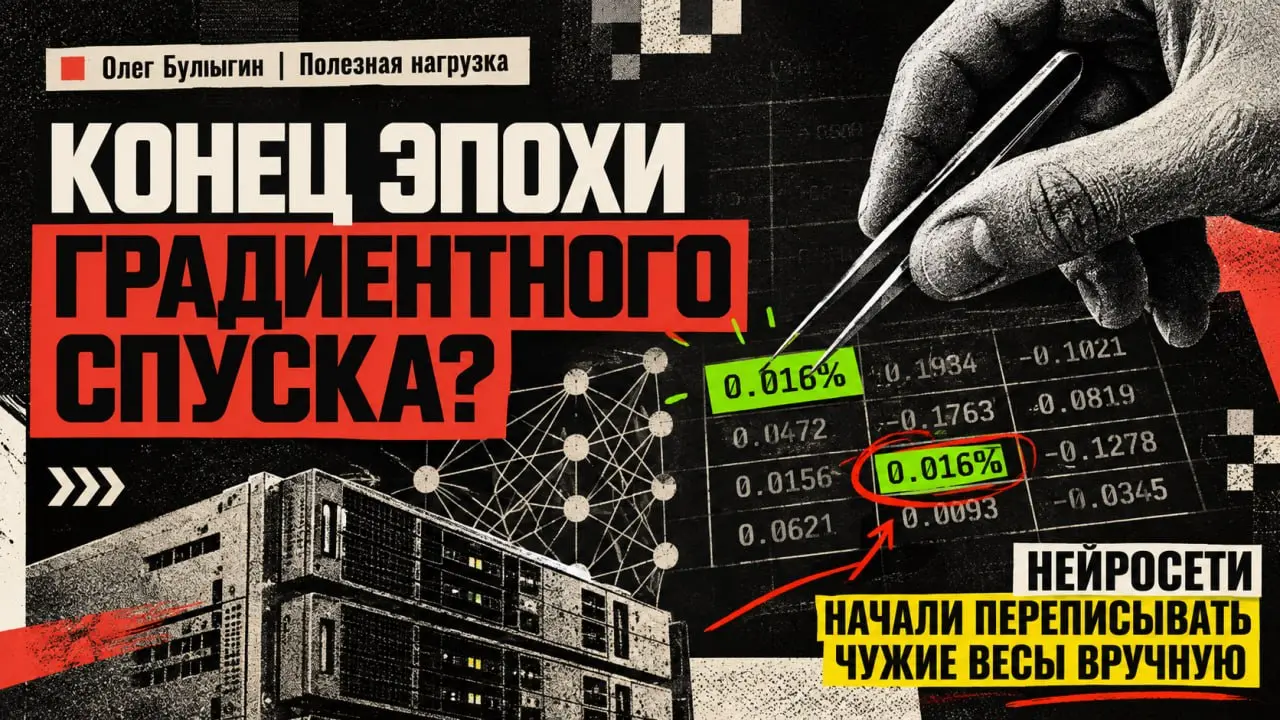
Конец эпохи градиентного спуска? Нейросети начали переписывать чужие веса вручную 🤯
Исследователи из MIT CSAIL опубликовали концепт Weight-Space Programming. Фронтирные LLM научились читать сырые матрицы весов других сеток как текст, находить в них баги и точечно патчить числами без обучения и градиентного спуска. В одном из тестов ручная правка 0.016% весов подняла бенчмарк модели по математике с 7.9% до 48.1%.
Всю историю deep learning мы относились к весам как к нечитаемой черной коробке. Человек не способен открыть тензор на пару миллионов чисел и понять, что там происходит. Мы скармливали данные алгоритмам оптимизации вроде Adam, подбирали learning rate и уповали на схождении функции потерь.
Ребята из MIT решили проверить, что произойдет, если скормить сырые веса напрямую топовой LLM (в экспериментах гоняли GPT-6 Astra). Результаты получились интересными 👇 1️⃣ Чтение весов «глазами» без запуска инференса Модели скормили 17 253 сырых числа весовой матрицы и спросили: в какую игру учили играть эту сетку? Astra проанализировала распределение весов в первом слое, нашла паттерны движения ракетки в 8-й строке, кирпичи в верхних строках и без вариантов выдала: Breakout (Atari).
Далее из трансформера выкинули входные и выходные эмбеддинги, оставив только промежуточные блоки (7.2M параметров). Глядя исключительно на матрицы внимания, модель вычислила так называемые индукционные головы (головы копирования) и верно определила язык обучения: где был английский, где романдзи, а где Python-код (в коде имена переменных повторяются чаще всего).
2️⃣ Нейрохирургия без градиентов Самый показательный кейс — Qwen3.5-0.8B. Мелкие reasoning-модели часто страдают зацикливанием: начинают ходить по кругу в рассуждениях и бьются головой о лимит контекста (у Qwen 93% ответов на MATH-500 улетали в 32k токенов). LLM локализовала вектор зацикливания в MLP-блоках 15 и 19 слоев и вычла это направление из матриц. Затронули всего 131 072 параметра из 800 миллионов (0.016% сетки). Итог: MATH-500 взлетел с 7.9% до 48.1%, GSM8K — с 13.8% до 67.1%, а следование инструкциям (IFEval) выросло в три раза. Никакого дообучения, просто прямая правка весов.
3️⃣ Код сразу в веса В задачах с играми MinAtar и Go модель вообще сгенерировала рабочие веса с нуля, написав их через Python-сессию послойно как алгоритм. Сетка для Go с 1.5 млн параметров после 50 тестовых прогонов развалила PPO, который обучался на 20 миллионах партий.
А теперь снимаем розовые очки 👓
Звучит как магия, но физику и математику не обманешь. В этой же работе исследователи провели честный контроль на Gemma 3 270M. Эта сетка в циклы не валилась, ей просто не хватало математических знаний. Astra ковыряла веса, пыталась подкручивать отдельные нейроны, но результат по MATH остался на уровне плинтуса.
Вывод: прямое редактирование весов позволяет снять блокировки и убрать баги, но не может наколдовать знания, которых в модель физически не заложили при претрейне.
Но сам подход значимый. Веса перестают быть бессмысленным шумом и превращаются в своего рода низкоуровневый байт-код или ассемблер. Вместо того чтобы сжигать мегаватты на дообучение ради фикса одной глупой ошибки, в будущем мы, вероятно, сможем натравливать модель-диагност, которая за пару секунд пропатчит сбойный контур.