Смешанный аудиопоток убивает перевод на живом звонке.
Когда Zoom или Teams отдают один микс — твой голос + собеседник + системные звуки — STT видит кашу. Распознавание путает языки, диаризация сыпется, перевод опаздывает или врёт.
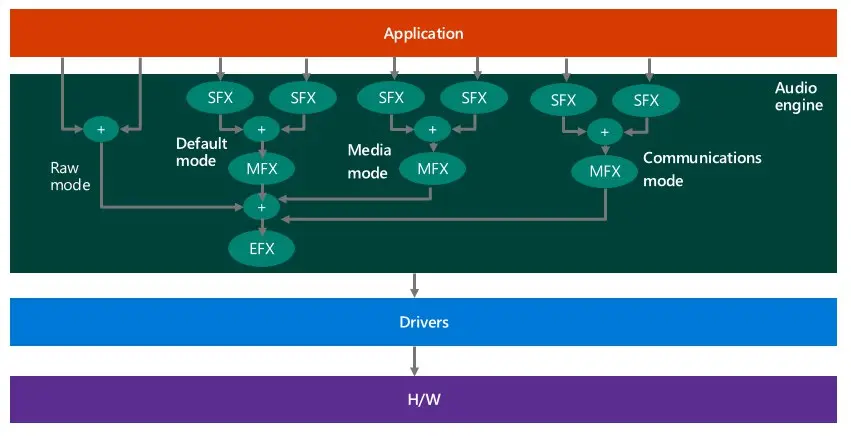
На Windows — два независимых потока через WASAPI. Микрофон — обычный capture. Системный звук (звонок) — loopback с render endpoint (AUDCLNT_STREAMFLAGS_LOOPBACK, shared). Каждый: свой resampler до 16 kHz mono (Whisper/Parakeet), свой VAD, своя STT и запись.
Exclusive: 3–10 мс, но другие молчат. Shared: 10–30 мс, всё работает. DPC/ISR >500–1000 µs ломают real-time. LatencyMon покажет виновника.
Разделение: чистые транскрипты. Incoming сразу в переводчик (27 языков, грамматика/словарь), outgoing — в companion или историю. Никакого crosstalk. После — поиск по таймкодам, экспорт, AI-сводка. Всё на диске.
Без этого live-перевод и анализ — лотерея.