Робот-переводчик на звонке сразу палит, что ты не говоришь на их языке. Свой голос — другое дело.
Почему большинство live-переводчиков звучат как call-center бот? После ASR и MT текст уходит в generic TTS. Собеседник слышит чужой тембр, и доверие падает — особенно на интервью или переговорах.
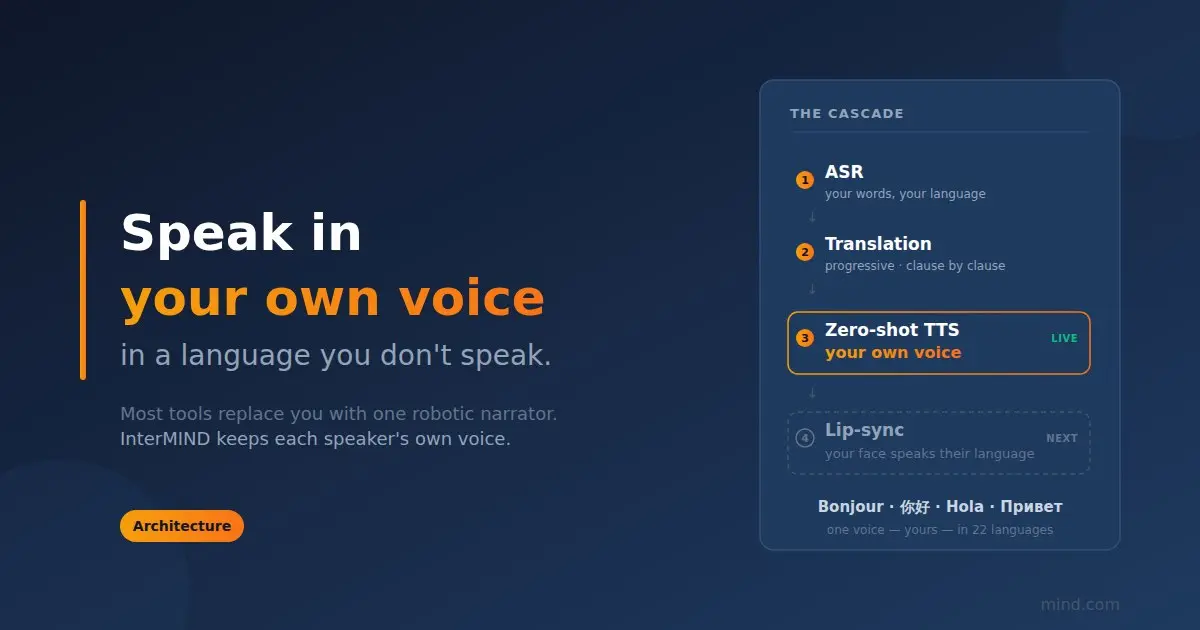
Talkaside делает zero-shot клонирование: берёт 10–20 секунд твоего голоса (локально), извлекает speaker embedding и синтезирует перевод с твоим тембром, темпом и интонацией. Каскад: dual-stream WASAPI (микрофон + loopback системного звука) → отдельный STT на каждый трек (Whisper/Parakeet локально или облако) → перевод Hy-MT2 / DeepL / Gemini (27 языков, с разбором грамматики и словаря в practice mode) → zero-shot TTS → виртуальный кабель обратно в звонок.
Latency в бюджете: partials STT 200–500 мс, перевод стримится по фразам, TTS стартует на стабильных сегментах. Shared-mode WASAPI держит 10–20 мс буфер