Почему смешанный аудиопоток убивает перевод и анализ в живом звонке.
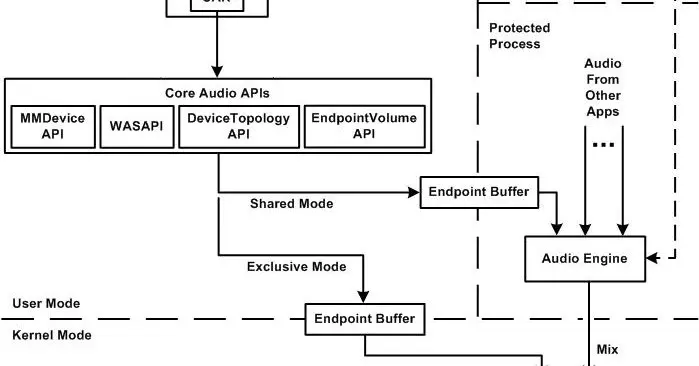
На схеме Core Audio: приложение через WASAPI попадает в Shared Mode (через Audio Engine, который микширует всё в один Endpoint Buffer) или Exclusive Mode (прямо в буфер). Shared — это 5–12 мс базовой задержки плюс DPC. Один микс (микрофон + системный звук) даёт STT кашу: диаризация сыпется, перевод опаздывает или врёт, подсказки на чужой фразе.
Talkaside идёт двумя независимыми пайплайнами. Микрофон — обычный capture. Входящий звук — loopback с render endpoint (AUDCLNT_STREAMFLAGS_LOOPBACK). Оба потока ресемплятся отдельно в 16 кГц моно со своими таймстемпами. Локальный Whisper или Parakeet (CPU/CUDA/Vulkan) либо облако с замером latency и авто-failover, если TTFS ползёт выше 80–100 мс. История и записи остаются на диске.
На любом созвоне — интервью, клиентский, практика языка — стороны не смешиваются. Перевод чистый, анализ разговора точный.