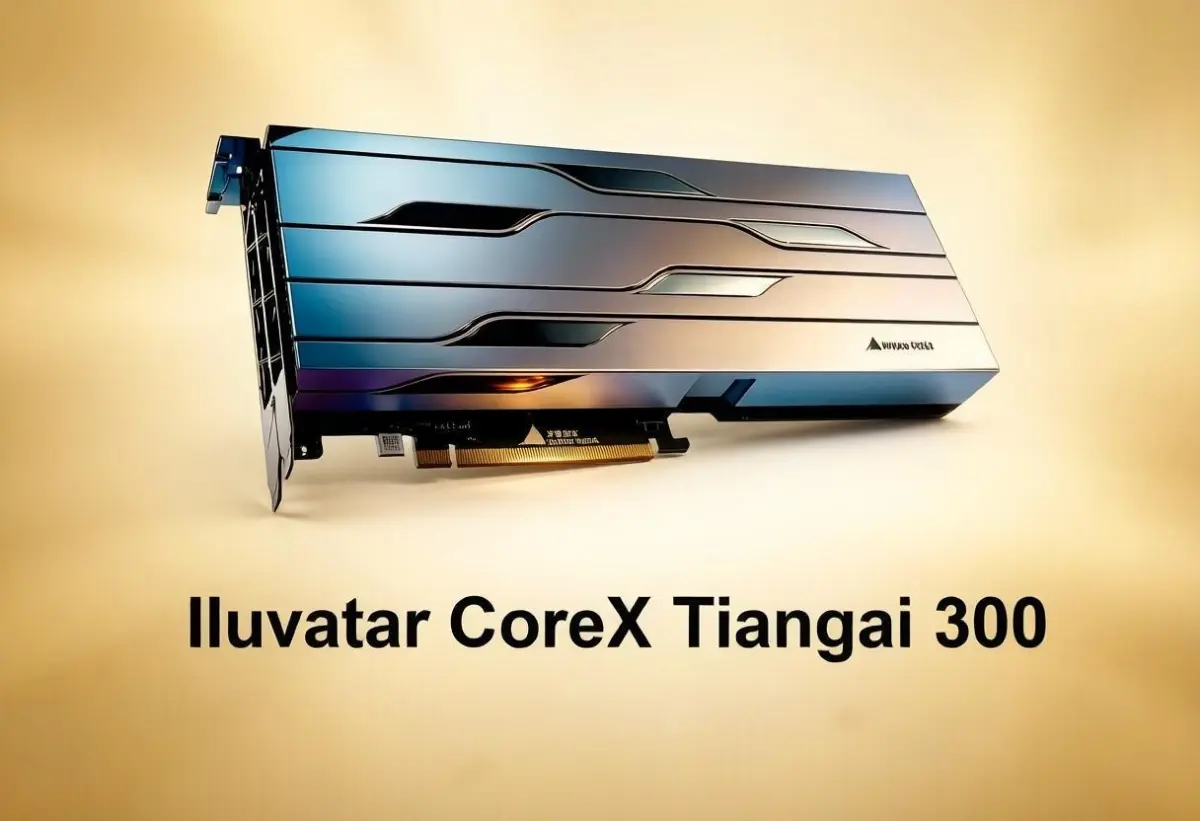
Обзор AI ускорителя Iluvatar CoreX Tiangai 300
Iluvatar CoreX Tiangai 300 — это специализированный графический ускоритель (GPU), разработанный шанхайской компанией Iluvatar CoreX для высокопроизводительных вычислений (HPC) и задач искусственного интеллекта. Устройство представляет собой кульминацию многолетней стратегии компании по созданию полностью независимой от западных вендоров вычислительной платформы.
Эволюция и рыночная роль Iluvatar CoreX История компании Iluvatar CoreX в сегменте GPU началась в 2018 году. До выхода модели Tiangai 300 вендор последовательно развивал свою линейку: первопроходцем стал чип Tiangai 100 (2021 год, 7 нм технология), предназначенный для облачных вычислений, а модели 200-й и 300-й серий закрепили успех, сместив фокус на архитектуру трансформеров.
Официальный дебют Tiangai 300 состоялся в конце октября 2026 года, а публичная презентация для журналистов прошла 28 октября в Шанхае. Устройство задумано как прямой вызов Nvidia H200. Этот выбор обусловлен тем, что H200 — это вершина производительности, которую правительство США на данный момент разрешает поставлять в материковый Китай. Tiangai 300 призван дать китайским технологическим гигантам доступ к мощностям мирового класса, полностью исключив зависимость от санкционной политики Запада.
Позиция на рынке и аппаратные комплексы
Iluvatar CoreX удерживает статус одного из ключевых игроков (драконов) на внутреннем рынке ИИ ускорителей, наряду с Biren Technology, Enflame и Moore Threads. Привлеченное в ходе IPO на Гонконгской бирже в январе 2026 года финансирование позволило компании перейти к массовому выпуску.
Стратегия Iluvatar строится вокруг создания целостной инфраструктуры. Tiangai 300 является ядром масштабных систем, таких как суперузел IXL144. Эта вычислительная стойка объединяет 144 ускорителя и 18 центральных процессоров, предоставляя 10.1 ТБ объединенной памяти. Согласно расчетам разработчика, подобная архитектура снижает себестоимость обработки токенов (cost per million effective tokens) примерно на 40% в сравнении с западными аналогами. Заявлено, что чипы Tiangai уже работают в кластерах, насчитывающих до 10 000 единиц, что подтверждает их готовность к промышленной эксплуатации.
Архитектурные решения и программная среда
Чтобы упростить миграцию клиентов из экосистемы Nvidia, Tiangai 300 обеспечивает полную программную совместимость с CUDA. Это дает возможность использовать привычные инструменты разработки, такие как PyTorch и TensorFlow, без переписывания кода. Поскольку доступ Китая к самым современным полупроводниковым фабрикам ограничен, инженеры Iluvatar сделали упор на оригинальную архитектуру и системную оптимизацию:
Расширенный кадровый буфер: 144 ГБ видеопамяти на карту (против 141 ГБ у H200), что необходимо для обработки больших контекстов в языковых моделях.
Низкая точность: Аппаратная поддержка вычислений в форматах FP8 и FP4, что кратно ускоряет инференс без критической потери качества.
Сверхбыстрая связь: Интерконнект P2P с задержкой около 1 микросекунды, минимизирующий задержки при обмене данными между ускорителями.
Специализация на MoE: Глубокая оптимизация под архитектуру Mixture of Experts для эффективной маршрутизации запросов.
Верификация и рыночные реалии Заявления производителя получили подтверждение от независимых экспертов. Тестирование, организованное структурой Shanghai INESA, показало превосходство Tiangai 300 на 5% (коэффициент 1.05) по сквозной пропускной способности в типовых сценариях. При этом эксперты отмечают, что лидерство чипа пока подтверждается в узком спектре задач (преимущественно инференс и адаптация моделей). Детальные спецификации кристалла и полные протоколы испытаний остаются закрытыми, а коммерческий успех ускорителя напрямую зависит от зрелости всей национальной цепочки поставок микроэлектроники. Несмотря на это, Tiangai 300 стал одним из немногих примеров, когда китайский GPU в реальных задачах не просто догнал, но и опередил актуальный западный флагман, доступный на внутреннем рынке КНР.