Почему облачный распознаватель речи ломает перевод и подсказки в реальном звонке
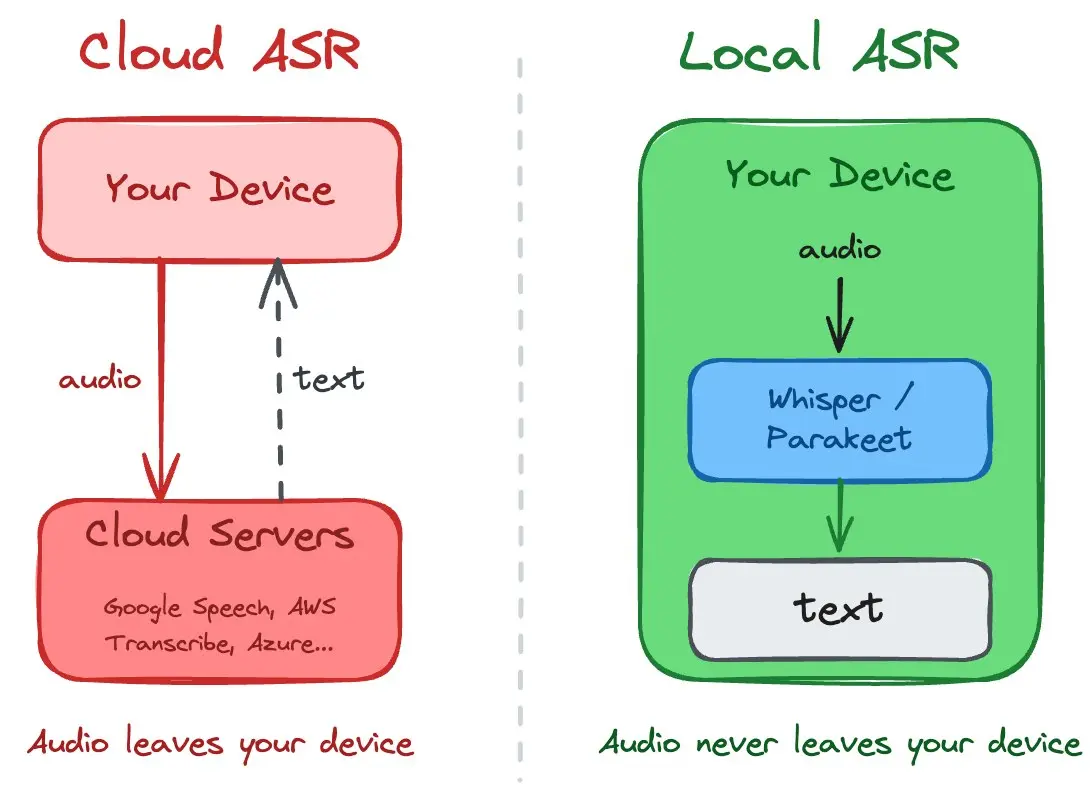
Облачный STT (Google, Deepgram, Whisper API) отправляет аудио на сервер. Задержка 300–800 мс только на сеть, плюс очередь. В живом созвоне это уже сбивает ритм: перевод опаздывает, подсказка приходит после того, как ты уже ответил.
Talkaside крутит локальные модели на твоей машине: Whisper (tiny/base через whisper.cpp или Faster-Whisper) и Parakeet от NVIDIA. Аудио захватывается через WASAPI, проходит VAD (Silero), режется на чанки 200–500 мс и сразу идёт в модель. Первый токен часто вылезает за 250–600 мс на нормальном CPU/GPU.
История звонка, транскрипт с таймстемпами, аудио — всё остаётся локально. Ты сам выбираешь, слать ли текст в облачный LLM для анализа или держать всё offline. Для перевода можно подключить Hy-MT2 или локальный NLLB. Никаких ботов в звонке.
В итоге перевод и подсказки идут в ритме разговора, а после звонка полный разбор без утечек.