Смешанный поток в Shared Mode превращает любой живой перевод в лотерею диаризации.
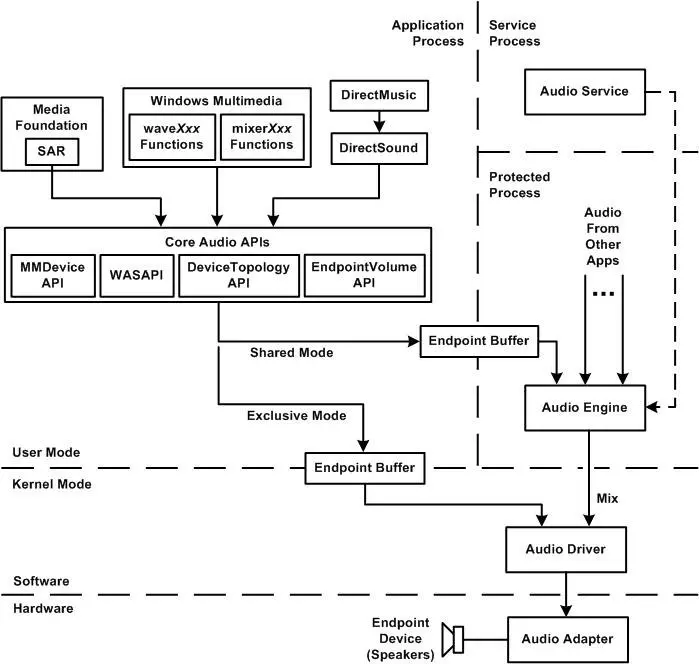
На схеме Core Audio: приложение через WASAPI попадает либо в Shared Mode (через Audio Engine, который микширует всё в один Endpoint Buffer), либо в Exclusive (прямо в буфер). Shared — это 5–12 мс базовой задержки плюс DPC. Один микс (микрофон + системный звук звонка) даёт STT кашу: языки путаются, перевод врёт на смеси.
Talkaside открывает два независимых клиента. Микрофон — обычный capture endpoint. Входящий звук — loopback с render endpoint (AUDCLNT_STREAMFLAGS_LOOPBACK, shared). Каждый поток ресемплится отдельно в 16 кГц моно со своими таймстемпами и VAD. Локальный Whisper или Parakeet либо облако с замером latency и авто-failover.
Incoming сразу идёт в переводчик: 27 языков, practice mode разбирает грамматику и новые слова. Companion mode подмешивает короткие подсказки. После — полный транскрипт с таймкодами, поиск и AI-сводка. Всё на диске.
Без разделения сторон анализ остаётся случайностью.