Почему перевод на звонке звучит как робот, даже когда текст идеальный.
Большинство live-переводчиков берут STT + MT и кормят это в обычный TTS с фиксированным голосом. Собеседник слышит чужой тембр, просодия пропадает, диалог ломается.
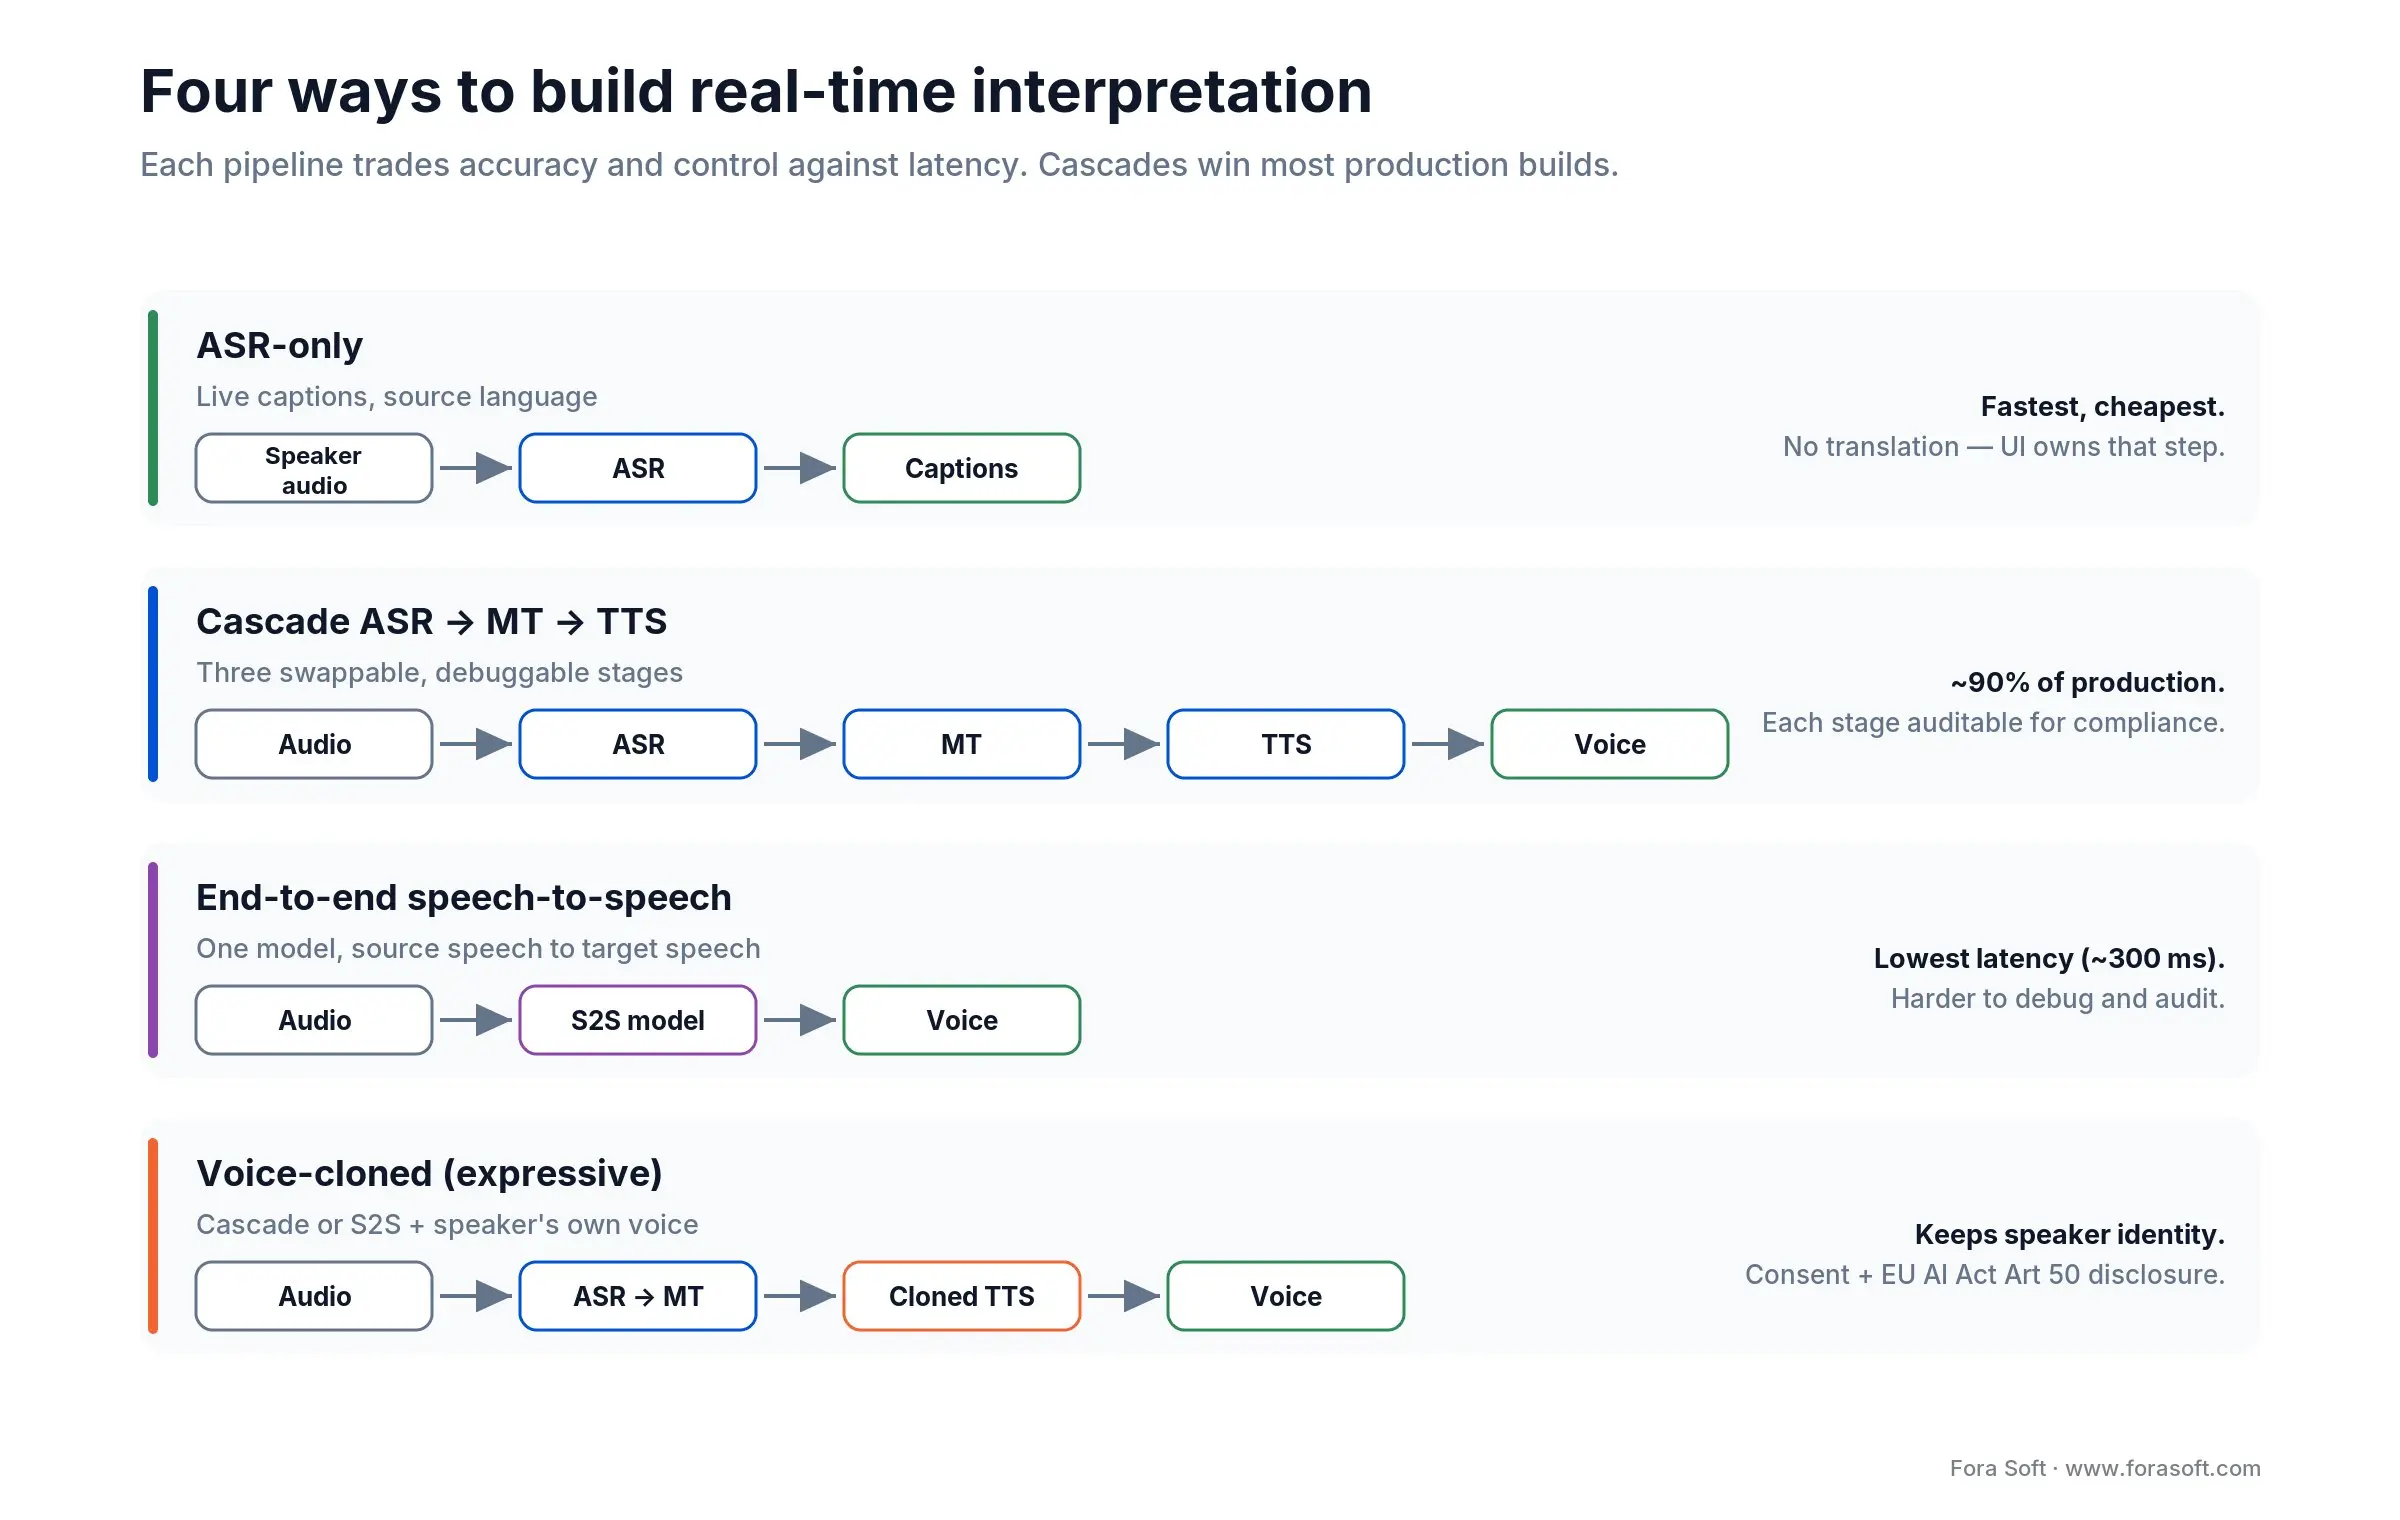
Нормальный пайплайн для своего голоса: dual-stream WASAPI даёт чистый микрофонный референс (5-20 сек). Speaker encoder выдаёт embedding (256-512 dim). Перевод (Hy-MT2) стримится по фразам. Cloned TTS (Riva Magpie, Qwen3-TTS, ElevenLabs Flash или локальный SoVITS) принимает текст + embedding и генерирует waveform с сохранением тембра и интонации.
End-to-end: STT 150-300 мс, MT 100-200, TTS first audio 70-180 мс. Суммарно 400-700 мс на фразу. Референс и история остаются локально на диске.
Вместо безликого голоса собеседник слышит тебя на другом языке. Practice mode и companion от этого только выигрывают.