Как каталог событий собирается без меня
Каталог событий собирается быстро. Дольше всего я разбиралась не с сайтом, а с тем, откуда брать данные и как не сойти с ума на второй неделе.
Сайт — самая простая часть проекта: генератор страниц, подборки, карта сайта. Потом наступает понедельник, и выясняется, что все события в каталоге не подгрузились.
Дальше был разбор источников. 18 площадок: музеи, библиотеки, планетарий, парки. У каждой своя вёрстка и свой способ писать даты — от «14 ноября» до «6 июня — 31 января». Где-то расписание есть только картинкой, где-то анонс живёт во «ВКонтакте» и больше нигде.
Самое полезное решение в проекте — не парсеры. Это то, как я обошлась с тем, что машинно не берётся.
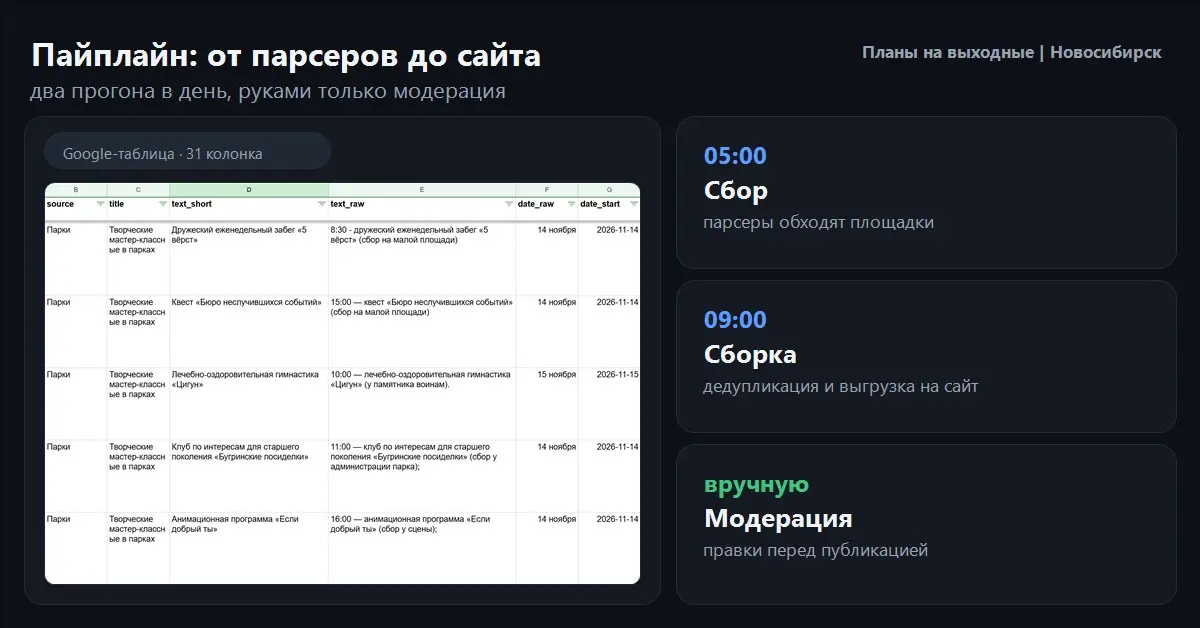
Я не заполняю 21 колонку руками. Я вставляю анонс как он есть — с эмодзи, переносами и фразой «вход платный» в отдельный файл. Код достаёт дату, время, площадку, цену, возраст и афишу, а заодно решает, попадёт событие в подборки «бесплатно» или «с детьми». На выходе — та же строка таблицы, что и у парсера.
Получился полуавтомат: основную работу делает код, за мной — проверка. 20 минут в понедельник уходят не на перепечатывание, а на то, чтобы посмотреть, что получилось.
Отдельная история — про ошибку, которую я долго не видела. 17 парковых событий висели в таблице, а на страницу не попадали. В логах — тишина: сборщик пропускал строки без внутреннего номера. Нашла, когда сверила, сколько строк в таблице и сколько карточек на странице.
Вывод, который забираю с собой: автоматизация — это не «всё происходит само». Это когда ты точно знаешь, где именно нужно твоё участие, и не тратишь силы на остальное.