Налог на токенайзер: почему за один и тот же смысл в LLM можно заплатить в 17 раз дороже 💸
Провайдеры LLM берут деньги за токены, а не за смысл текста — из-за этого пользователи не-латинских алфавитов платят скрытый налог за особенности BPE-сжатия. Для русского языка 18 из 19 протестированных семейств моделей переваривают кириллицу адекватно, но одна открытая модель умудрилась провалиться даже на втором языке интернета.
Исследователи из CLEAR выкатили работу The Tokenizer Tax, где прогнали корпус FLORES-200 (203 языка и письменности) через актуальные проприетарные и открытые модели. Главная метрика — коэффициент max/min: во сколько раз больше токенов тратит самый «дорогой» язык по сравнению с самым «дешёвым» (обычно английским или упрощённым китайским).
В чём суть?
Модели не читают слова — они жрут токены. Токенизатор (BPE и его вариации) сжимает часто встречающиеся подстроки в один токен.
Поскольку датасеты исторически залиты английским текстом на латинице, для английского языка токен — это почти всегда целое слово или смысловой корень. Для остальных языков — как повезёт. В худших сценариях буквы нелатинских алфавитов дробятся на слоги, отдельные символы или вовсе на сырые байты UTF-8.
А провайдеры берут денюжки за миллион токенов по единому тарифу, плевать они хотели на язык.
Возьмём простую фразу: «People should benefit from AI, regardless of the language they speak». В токенайзере GPT-5 она весит: 🟢 Английский — 13 токенов. 🟡 Малаялам — 26 токенов. 🟣Амхарский (письмо геэз) — 78 токенов (×6 к цене, каждый символ распилило на два однобайтовых токена).
А что там с русским языком? 🇷🇺
В рейтинге ресурсообеспеченности CLEAR (на базе веб-присутствия в Common Crawl и числа носителей) русский занимает 2-е место после английского.
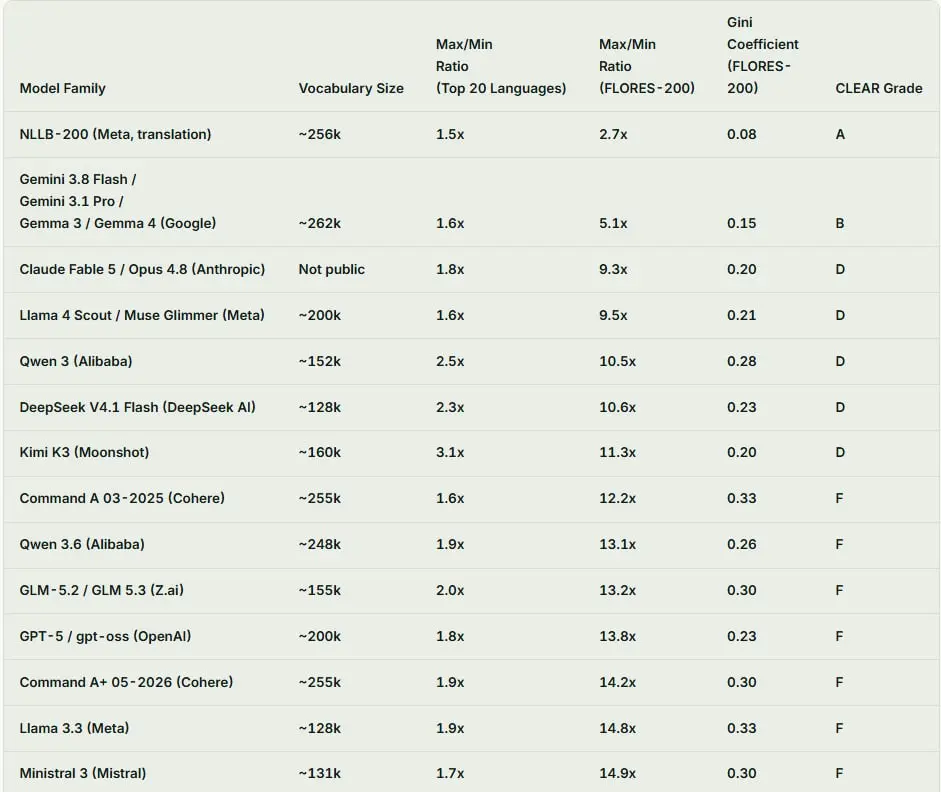
🔵 Крупные лабы кириллицу не обижают. Для 18 из 19 семейств русский уверенно сидит в высшей категории Grade A (переплата ≤ 3× к базовому языку). Если смотреть на максимальный разброс внутри топ-20 языков интернета, то у Gemini 3.8 / 3.1, Gemma 3 / 4 и Llama 4 он не превышает 1.6×, у Ministral 3 и Nemotron 3.5 — 1.7×, у GPT-5 и Claude Fable 5 / Opus 4.8 — 1.8×, у Qwen 3.6 — 1.9×, у DeepSeek V4.1 Flash — 2.3×.
🔵 Но «невидимый налог» никуда не девается. Даже если ваш язык укладывается в условные 1.5×–1.8× от английского, на больших объёмах это бьёт сразу по трём метрикам: — Прямой чек за API: вы платите на десятки процентов больше за тот же объём смысла. — Усыхание контекстного окна: оно по факту вмещают заметно меньше реального текста, чем на английском. — Latency: больше токенов на выходе = пропорционально дольше пользователь ждёт ответ.
Как распределились оценки топовых нейронок 🏆
CLEAR ввели шкалу от A (разброс эффективности между языками меньше 3x) до F (разброс больше 12x):
1️⃣ Google (Gemini 3 / Gemma 4) — твёрдая B (макс. разброс 5.1x). Единственные из коммерческих тяжеловесов, кто целенаправленно вложился в мультиязычный словарь. 2️⃣ Anthropic (Claude Fable / Opus) и Meta (Llama 4) — оценка D (разброс 9.3x–9.5x). 3️⃣ OpenAI (GPT-5), Mistral, Cohere, DeepSeek — оценка F (разброс от 10.6x до 14.9x).
Причём дело не просто в размере словаря: у Llama 4 словарь меньше, чем у Qwen 3.6, но Llama работает с разными языками ровнее.
Авторы исследования предлагают лабам перейти от биллинга за токены к тарификации по символам или нормализации по языку — токенайзер без переобучения базы не поменять, а крутилку в биллинге поправить можно хоть завтра. Но рассчитывать на альтруизм корпораций не стоит.
А перед тем как тащить новую модель в прод под не-английский (и тем более не-латинский) язык, можете прогнать свой корпус через её токенайзер. Код бенчмарка выложили на GitHub — можно проверить сколько вам будет стоить использвоание другого языка.