Шалость удалась (часть 6)
Хорошо, устройство замолчало. И что дальше?
К этому моменту система уже показывала, когда ESP32 последний раз выходила на связь. Открываешь Web UI, смотришь heartbeat и понимаешь, доступен ли офис. Но обнаружилась проблема: чтобы узнать об отсутствии интернета, нужно было самому вспомнить про мониторинг и открыть страницу.
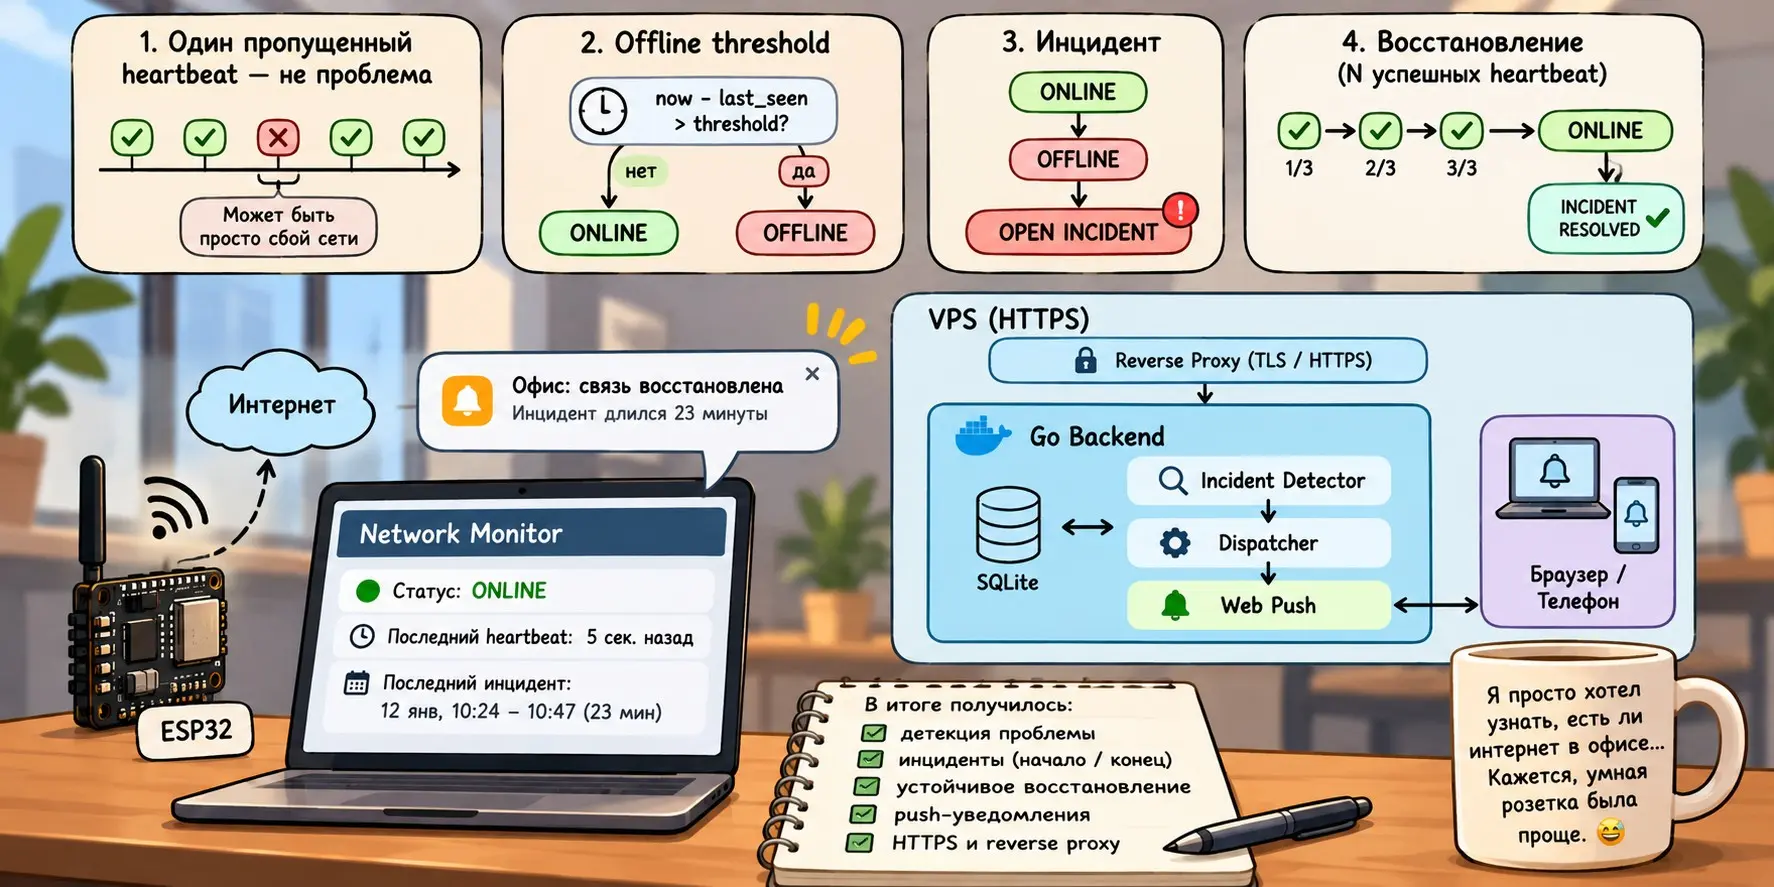
Получался мониторинг, за которым нужно мониторить. Значит, система должна сама обнаруживать проблемы и сообщать о них. Один потерянный heartbeat — ещё не авария Казалось бы, всё просто: не пришёл heartbeat — устройство offline. Но запрос может потеряться. Wi-Fi — переподключиться. VPS — временно не ответить. Где-то между офисом и сервером может произойти кратковременный сбой.
Объявлять аварию после одного пропущенного запроса было бы слишком агрессивно. Поэтому появился offline threshold.
Backend хранит время последнего успешного heartbeat (last_seen) и периодически проверяет, сколько времени прошло с момента его получения. Если интервал превышает заданный порог, устройство переходит в OFFLINE. До этого оно остаётся ONLINE. Так отдельная сетевая ошибка перестала автоматически превращаться в аварию. Offline — это уже событие
Допустим, устройство признано offline. Через минуту backend снова проверяет его состояние. Оно всё ещё offline. И ещё через минуту — тоже. Если каждую проверку считать новым событием, одна проблема быстро превратится в десятки одинаковых записей и уведомлений. Поэтому я добавил connectivity incidents.
Первый переход из ONLINE в OFFLINE открывает инцидент. Пока он открыт, повторные проверки не создают новые. Теперь система хранила не только текущее состояние устройства, но и историю проблем: когда пропала связь, сколько длился сбой и когда всё восстановилось. И это уже было интереснее обычного last_seen.
А когда считать устройство восстановленным? Если одного пропущенного heartbeat недостаточно для аварии, достаточно ли одного успешного для восстановления?
Представим нестабильную связь: один запрос дошёл, два потерялись, затем снова пришёл успешный. Если менять статус после каждого сигнала, устройство начнёт прыгать между ONLINE и OFFLINE. Поэтому появился ещё один механизм — несколько последовательных успешных heartbeat.
Я выбрал три. Первый сигнал ещё ничего не меняет. Второй подтверждает восстановление. Третий возвращает устройство в ONLINE и закрывает инцидент. Получился небольшой state machine, защищающий мониторинг от постоянного переключения статусов.
Мониторинг должен сообщать сам Backend уже обнаруживал сбои, открывал инциденты и фиксировал восстановление. Но обо всём этом я по-прежнему узнавал только через Web UI. Пришло время уведомлений. Механизм обнаружения инцидентов я отделил от доставки: позже можно подключить email, мессенджеры или другие каналы.
Первым стал Web Push. И тут маленькому backend понадобились вполне взрослые компоненты: хранение push subscriptions, service worker в браузере, VAPID-ключи и очистка недействительных подписок.
А Web Push для обычного удалённого сайта требует защищённого контекста — HTTPS. Так появились reverse proxy, TLS и дополнительные настройки сервера. Теперь цепочка выглядела так: ESP32 отправляет heartbeat, Go backend хранит состояние в SQLite, детектор открывает инцидент при потере связи, а диспетчер отправляет уведомление в браузер или на телефон.
И тут я снова вспомнил, с чего всё начиналось. Я просто хотел перед поездкой в офис узнать, работает ли там интернет. Теперь у меня были ESP32, Go backend, SQLite, инциденты, логика восстановления, HTTPS и push-уведомления.
Кажется, умная розетка всё-таки была немного проще.
Продолжение следует…
#ESP32 #IoT #GoLang #Backend #PetProject #Мониторинг #WebPush #SQLite #Разработка